

Yapay sinir ağına giriş
Önkoşul:Perceptron
Kanca
- derste XOR’un tek bir perceptronla ASLA tam çözülemeyeceğini kanıtladık — matematiksel bir imkansızlıktı. Peki bu, “yapay zeka” fikrinin sonu muydu? Hayır — çözüm, tek bir nöronu daha GÜÇLÜ yapmak değil, birden fazla nöronu bir araya getirmekti.
Sezgi
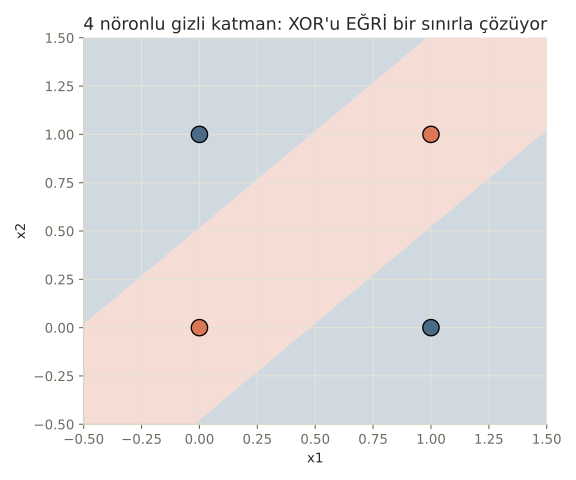
Yapay sinir ağı (çok katmanlı algılayıcı / MLP), perceptron’ları KATMANLAR halinde bir araya getirir. Girdi ile çıktı arasına bir veya daha fazla “gizli katman” (hidden layer) eklenir. Her gizli nöron kendi doğrusunu çizer; çıktı katmanı, bu doğruların sonuçlarını BİRLEŞTİREREK çok daha karmaşık, eğrisel karar sınırları oluşturabilir.
Bu, 17. ML dersindeki karar ağaçlarının fikrine biraz benziyor — tek bir basit kural yetersizken, birden fazlasını birleştirmek güçlü hale geliyor. Ama sinir ağlarında bu birleştirme, ÖĞRENİLEBİLİR ağırlıklarla, matematiksel olarak sürekli (differentiable) bir şekilde yapılır.
Mekanizma
- dersteki XOR verisine geri dönelim:
XOR hatırlatması
# 1. dersten hatırla: TEK bir perceptron, XOR'u en fazla %75 doğrulukla çözebiliyordu.
X_xor = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
y_xor = np.array([0, 1, 1, 0])
print("XOR verisi (1. dersten): tek bir doğru bunu asla tam ayıramıyordu.")
XOR verisi (1. dersten): tek bir doğru bunu asla tam ayıramıyordu.Şimdi araya bir gizli katman ekleyelim:
Gizli katmanla XOR çözülüyor
# Şimdi girdi ile çıktı arasına GİZLİ bir katman (hidden layer) ekleyelim.
model = MLPClassifier(hidden_layer_sizes=(4,), activation="relu", max_iter=2000, random_state=1)
model.fit(X_xor, y_xor)
tahmin = model.predict(X_xor)
dogruluk = (tahmin == y_xor).mean()
print(f"1 gizli katman (4 nöron) ile MLP doğruluğu: {dogruluk:.2f}")
for x, hedef, t in zip(X_xor, y_xor, tahmin):
    print(f"  giriş={x.astype(int)}  hedef={hedef}  tahmin={t}")
1 gizli katman (4 nöron) ile MLP doğruluğu: 1.00
giriş=[0 0] hedef=0 tahmin=0
giriş=[0 1] hedef=1 tahmin=1
giriş=[1 0] hedef=1 tahmin=1
giriş=[1 1] hedef=0 tahmin=0%100 doğruluk! Tek bir doğrunun asla başaramadığı şeyi, birkaç nöron birlikte başarıyor. Bunun NASIL çalıştığını görelim:
Gizli katmanın içinde ne oluyor?
# Gizli katmandaki her nöron, kendi doğrusunu çiziyor. Çıktı katmanı bu doğruların
# sonuçlarını BİRLEŞTİRİYOR -- işte "derinliğin" gücü tam olarak burada.
gizli_aktivasyonlar = np.maximum(0, X_xor @ model.coefs_[0] + model.intercepts_[0])
print("\nHer girişin gizli katmandaki 4 nöronu nasıl aktifleştirdiği (ReLU sonrası):")
for x, akt in zip(X_xor, gizli_aktivasyonlar):
    print(f"  giriş={x.astype(int)}  gizli aktivasyonlar={akt.round(2)}")
print("Farklı girişler, gizli katmanda FARKLI aktivasyon örüntüleri üretiyor -- çıktı katmanı bu örüntülere bakarak karar veriyor.")
Her girişin gizli katmandaki 4 nöronu nasıl aktifleştirdiği (ReLU sonrası):
  giriş=[0 0]  gizli aktivasyonlar=[0. 0. 0. 0.]
  giriş=[0 1]  gizli aktivasyonlar=[0.  0.  0.  1.7]
  giriş=[1 0]  gizli aktivasyonlar=[0.   1.73 0.   0.  ]
  giriş=[1 1]  gizli aktivasyonlar=[0. 0. 0. 0.]
Farklı girişler, gizli katmanda FARKLI aktivasyon örüntüleri üretiyor -- çıktı katmanı bu örüntülere bakarak karar veriyor.
Farklı girdiler, gizli katmanda FARKLI aktivasyon “imzaları” üretiyor — (0,1) ve (1,0) girdileri farklı nöronları tetikliyor, (0,0) ve (1,1) ise hiçbir nöronu tetiklemiyor. Çoğu kişi “daha fazla katman eklemek sadece modeli büyütür, temelde aynı şeyi yapar” sanır. Değil, çünkü her gizli nöron kendi doğrusal sınırını çiziyor, ama bu sınırların ReLU gibi DOĞRUSAL OLMAYAN bir fonksiyondan geçmesi (bir sonraki derslerde detaylandıracağız), birleşiminin eğrisel/karmaşık sınırlar oluşturmasını sağlıyor.
Matematik
Çok katmanlı algılayıcının yapısı
| Sembol | Anlamı |
|---|---|
| Girdi vektörü | |
| Girdiden gizli katmana giden ağırlıklar ve bias’lar | |
| Gizli katmanın çıktısı (aktivasyonları) | |
| Doğrusal olmayan aktivasyon fonksiyonu (bu derste ReLU) — SONRAKİ derslerde detaylandıracağız | |
| Gizli katmandan çıktıya giden ağırlıklar ve bias’lar |
Kritik nokta: eğer olmasaydı (yani sadece doğrusal işlemler üst üste binseydi), TÜM bu katmanlar matematiksel olarak TEK bir doğrusal dönüşüme eşdeğer olurdu — hâlâ sadece düz bir çizgi çizebilirdik. Doğrusal olmayan aktivasyon fonksiyonu, derinliğin GERÇEK gücünü ortaya çıkaran şeydir.
Kod
Kaç gizli nöron gerekli? Deneyelim:
Gizli nöron sayısının etkisi
for n_noron in [1, 2, 3, 4, 8]:
    m = MLPClassifier(hidden_layer_sizes=(n_noron,), activation="relu", max_iter=2000, random_state=1)
    m.fit(X_xor, y_xor)
    d = (m.predict(X_xor) == y_xor).mean()
    print(f"gizli nöron sayısı={n_noron}  doğruluk={d:.2f}")
print("Tek bir gizli nöron yine YETERSİZ (perceptron ile aynı sorun). Bu ÇALIŞTIRMADA 1-3 nöron yerel bir")
print("optimuma takılıp %50'de kaldı, 4+ nöron ise güvenle %100'e ulaştı -- daha fazla nöron, eğitimi de kolaylaştırıyor.")
gizli nöron sayısı=1 doğruluk=0.50
gizli nöron sayısı=2 doğruluk=0.50
gizli nöron sayısı=3 doğruluk=0.50
gizli nöron sayısı=4 doğruluk=1.00
gizli nöron sayısı=8 doğruluk=1.00
Tek bir gizli nöron yine YETERSİZ (perceptron ile aynı sorun). Bu ÇALIŞTIRMADA 1-3 nöron yerel bir
optimuma takılıp %50'de kaldı, 4+ nöron ise güvenle %100'e ulaştı -- daha fazla nöron, eğitimi de kolaylaştırıyor.Bu çalıştırmada 1-3 nöron yerel bir optimuma takılıp %50’de kaldı (bu bir OPTİMİZASYON zorluğu, XOR’un çözülemezliği değil — 2 nöron teorik olarak XOR’u çözebilir), 4+ nöron ise güvenle %100’e ulaştı.
Nerede işe yarar
Gizli katman fikri, bu kategorideki HER modelin (CNN dahil) temelini oluşturur:
- Doğrusal olarak ayrılamayan her problem. Görüntü tanıma, dil anlama gibi gerçek dünya problemlerinin neredeyse tamamı XOR’dan çok daha karmaşık, doğrusal olmayan yapılar içerir.
- “Derinlik” kavramının somut anlamı. Her ek katman, önceki katmanın çıktısını daha soyut bir temsile dönüştürür — bu yüzden “derin” öğrenme deniyor.
- Evrensel yaklaşım teoremi’nin (universal approximation) sezgisel temeli. Yeterince geniş TEK bir gizli katman bile, teorik olarak HERHANGİ bir sürekli fonksiyonu yaklaşık olarak temsil edebilir.
Bu 3 hatayı yaparsın:
- Doğrusal olmayan aktivasyon fonksiyonunu (ReLU gibi) atlamak — bu derste gördüğümüz gibi, onsuz katmanlar matematiksel olarak tek bir doğrusal dönüşüme “çökebilir”.
- Gizli nöron sayısını rastgele seçmek — bu derste gördüğümüz gibi, çok az nöron yetersiz kalabilir (hem kapasite hem eğitilebilirlik açısından).
- “Daha derin her zaman daha iyidir” diye düşünmek — bir sonraki derste (kaybolan gradyan) bu varsayımın neden yanlış olabileceğini göreceğiz.
Kendini test et
1. Bir sinir ağına gizli katman eklemek, 1. dersteki XOR sorununu nasıl çözüyor?
- Daha fazla veri kullanarak
- Her gizli nöron kendi doğrusal sınırını çiziyor; bu sınırların doğrusal olmayan bir fonksiyondan geçip birleşmesi eğrisel/karmaşık sınırlar oluşturabiliyor (doğru cevap)
- Sadece daha uzun eğitilerek
- Farklı bir veri seti kullanarak
Neden: Gizli katmandaki her nöron kendi doğrusal ayrımını yapar; bu ayrımların doğrusal olmayan aktivasyonlardan geçip çıktı katmanında birleşmesi, tek bir doğrunun asla çizemeyeceği karmaşık sınırlar oluşturur.
2. Doğrusal olmayan aktivasyon fonksiyonu (σ) olmasaydı ne olurdu?
- Hiçbir şey değişmezdi
- Ağ daha hızlı çalışırdı
- Tüm katmanlar matematiksel olarak TEK bir doğrusal dönüşüme eşdeğer olurdu -- derinliğin hiçbir faydası kalmazdı (doğru cevap)
- Ağ sadece regresyon yapabilirdi
Neden: Doğrusal dönüşümlerin üst üste binmesi hâlâ doğrusaldır; aktivasyon fonksiyonu olmadan, ne kadar katman eklersen ekle, ağ sadece tek bir doğrusal sınır çizebilir -- tıpkı 1. dersteki perceptron gibi.
3. Notebook'ta 1-3 gizli nöronun %50'de takılı kalması neyi gösteriyor?
- 2-3 nöronun XOR'u çözmesi TEORİK olarak imkansızdır
- Bu, o çalıştırmada bir OPTİMİZASYON zorluğuydu (yerel optimum) -- XOR'un matematiksel olarak çözülemezliği değil, 1. dersteki perceptron durumundan farklı bir sorun (doğru cevap)
- Kod hatalıydı
- Veri seti yanlıştı
Neden: 1. dersteki perceptron sınırlaması GEOMETRİK/matematikseldi (hiçbir ayar bulunamazdı). Burada ise 2-3 nöron teorik olarak XOR'u temsil edebilir, ama bu çalıştırmada eğitim süreci bir yerel optimuma takıldı -- farklı bir tür zorluk.
Özet
Özet
- Çok katmanlı algılayıcı (MLP), perceptron'ları gizli katmanlar halinde bir araya getirir.
- Her gizli nöron kendi doğrusal sınırını çizer; bu sınırlar doğrusal olmayan aktivasyonlarla birleşerek karmaşık sınırlar oluşturabilir.
- Doğrusal olmayan aktivasyon fonksiyonu OLMADAN, derinliğin hiçbir matematiksel faydası kalmaz.
- Gizli nöron/katman sayısı, hem modelin KAPASİTESİNİ hem de eğitilebilirliğini etkiler.
- Bu gizli katman fikri, sonraki tüm derin öğrenme mimarilerinin (CNN, transformer) temelini oluşturur.