

Klasik mimariler (LeNet → ResNet)
Önkoşul:CNN mimarisinin tamamı
Kanca
- derste TEK bir CNN’in yapısını gördük. Ama gerçek dünyada kullanılan mimariler, 1998’den 2015’e kadar İNANILMAZ değişti — 7 katmandan 152 katmana. Bu sıçramayı mümkün kılan TEK bir fikri bu derste keşfedeceğiz.
Sezgi
CNN mimarileri zamanla DERİNLEŞTİ, ama bu derinleşme 2015’e kadar ciddi bir engelle karşılaştı: kaybolan gradyan (5. ders). ResNet’in “atlama bağlantısı” (skip/residual connection) fikri, bu engeli aşıp 1000+ katmanlı ağları bile eğitilebilir kıldı.
Mekanizma
Önce tarihe bakalım — gerçek mimarilerin katman ve parametre sayıları:
LeNet'ten ResNet'e
# CNN mimarileri, 1998'den 2015'e KATMAN SAYISI bakımından devasa büyüdü.
# Bu sayılar, yayınlanmış makalelerden alınmış GERÇEK rakamlardır.
mimariler = [
    ("LeNet-5", 1998, 7, "60 bin"),
    ("AlexNet", 2012, 8, "60 milyon"),
    ("VGG-16", 2014, 16, "138 milyon"),
    ("ResNet-50", 2015, 50, "25 milyon"),
    ("ResNet-152", 2015, 152, "60 milyon"),
]

print(f"{'Mimari':<14} {'Yıl':<8} {'Katman sayısı':<16} {'Parametre sayısı':<16}")
for isim, yil, katman, parametre in mimariler:
    print(f"{isim:<14} {yil:<8} {katman:<16} {parametre:<16}")

print("\nVGG-16'dan ResNet-50'ye geçişte katman sayısı 16'dan 50'ye ÇIKTI ama parametre sayısı 138M'dan 25M'a DÜŞTÜ.")
print("ResNet, daha DERİN ama daha VERİMLİ bir mimari -- bunun sırrı: atlama (skip/residual) bağlantıları.")
Mimari Yıl Katman sayısı Parametre sayısı
LeNet-5 1998 7 60 bin
AlexNet 2012 8 60 milyon
VGG-16 2014 16 138 milyon
ResNet-50 2015 50 25 milyon
ResNet-152 2015 152 60 milyon
VGG-16'dan ResNet-50'ye geçişte katman sayısı 16'dan 50'ye ÇIKTI ama parametre sayısı 138M'dan 25M'a DÜŞTÜ.
ResNet, daha DERİN ama daha VERİMLİ bir mimari -- bunun sırrı: atlama (skip/residual) bağlantıları.VGG-16’dan ResNet-50’ye geçişte katman sayısı 16’dan 50’ye ÇIKARKEN parametre sayısı 138M’dan 25M’a DÜŞÜYOR — ResNet hem daha derin HEM daha verimli. Şimdi NEDEN 2015’ten önce böyle derin ağlar eğitilemediğini görelim:
Derin bir ağda kaybolan gradyan
# Neden 2015'ten ÖNCE kimse 50+ katmanlı ağlar eğitemedi? 5. dersteki kaybolan
# gradyan sorununu, GERÇEK bir konvolüsyon zincirinde tekrar görelim.
def blok_olustur(std=0.02):
    konv = nn.Conv2d(8, 8, 3, padding=1)
    nn.init.normal_(konv.weight, std=std)
    nn.init.zeros_(konv.bias)
    return konv

def duz_ag_olustur(derinlik):
    katmanlar = []
    for _ in range(derinlik):
        katmanlar.append(blok_olustur())
        katmanlar.append(nn.ReLU())
    return nn.Sequential(*katmanlar)

def girdi_gradyan_normu(ag, girdi):
    girdi = girdi.clone().requires_grad_(True)
    kayip = ag(girdi).sum()
    kayip.backward()
    return girdi.grad.norm().item()

girdi = torch.randn(1, 8, 8, 8)
print(f"\n{'Derinlik':<10} {'Düz ağ (atlama YOK) gradyan normu':<36}")
for derinlik in [10, 20, 30]:
    duz_ag = duz_ag_olustur(derinlik)
    norm = girdi_gradyan_normu(duz_ag, girdi)
    print(f"{derinlik:<10} {norm:<36.3e}")

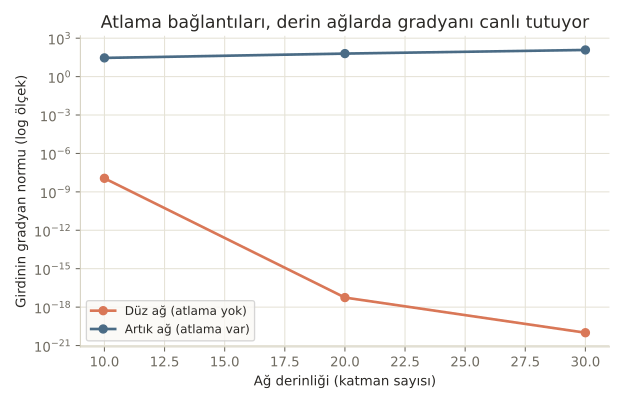
print("\n30 katmanda gradyan norm 0.0'a (float32 hassasiyetinin ALTINA) düşüyor -- 5. dersteki kaybolan gradyanın")
print("konvolüsyon zincirindeki YENİDEN karşımıza çıkışı. Bu yüzden 2015'ten önce çok derin ağlar eğitilemedi.")
Derinlik   Düz ağ (atlama YOK) gradyan normu
10         4.146e-08
20         3.655e-18
30         0.000e+00

30 katmanda gradyan norm 0.0'a (float32 hassasiyetinin ALTINA) düşüyor -- 5. dersteki kaybolan gradyanın
konvolüsyon zincirindeki YENİDEN karşımıza çıkışı. Bu yüzden 2015'ten önce çok derin ağlar eğitilemedi.
30 katmanlı bir konvolüsyon zincirinde, gradyan tam olarak 0.0’a (float32’nin temsil edebileceği en küçük sayının bile ALTINA) düşüyor. Çoğu kişi “5. dersteki kaybolan gradyan sadece basit örneklerde olur” sanır. Yanlış, çünkü GERÇEK konvolüsyon katmanlarında da AYNI matematik geçerli.
Matematik
Atlama (residual) bağlantısının türevi
| Sembol | Anlamı |
|---|---|
| Bloğun girdisi | |
| Bloğun “öğrenilen” dönüşümü (konvolüsyon + aktivasyon) | |
| Bloğun çıktısı — girdi DOĞRUDAN çıktıya eklenir |
Türevdeki "" terimi KRİTİK: ne kadar küçük olursa olsun (kaybolsa bile), gradyan en azından bu "" üzerinden HER ZAMAN geri akabilir. Bu, gradyanın asla TAMAMEN sıfırlanmamasını garanti eder.
Kod
Bu fikri gerçek bir “artık blok” (residual block) ile test edelim:
Atlama bağlantısının etkisi
# ResNet'in çözümü: her bloğun çıktısına GİRDİYİ GERİ EKLEMEK (y = x + f(x)).
class ArtikBlok(nn.Module):
    def __init__(self, std=0.02):
        super().__init__()
        self.konv = blok_olustur(std)
        self.relu = nn.ReLU()

    def forward(self, x):
        return x + self.relu(self.konv(x))  # ATLAMA (skip) bağlantısı

def artik_ag_olustur(derinlik):
    return nn.Sequential(*[ArtikBlok() for _ in range(derinlik)])

print(f"\n{'Derinlik':<10} {'Artık ağ (atlama VAR) gradyan normu':<36}")
for derinlik in [10, 20, 30]:
    artik_ag = artik_ag_olustur(derinlik)
    norm = girdi_gradyan_normu(artik_ag, girdi)
    print(f"{derinlik:<10} {norm:<36.4f}")

print("\nAYNI derinlikte, atlama bağlantılı ağın gradyanı SIFIRA gitmiyor -- tam tersine, derinlikle BÜYÜYOR.")
print("Neden: y = x + f(x)'in türevi, dy/dx = 1 + f'(x) -- '1' terimi, gradyanın HER ZAMAN en az bir doğrudan")
print("yol üzerinden geri akmasını GARANTİ ediyor. Bu basit fikir, 1000+ katmanlı ağları eğitilebilir kıldı.")
Derinlik   Artık ağ (atlama VAR) gradyan normu
10         34.2274
20         54.9939
30         99.4524

AYNI derinlikte, atlama bağlantılı ağın gradyanı SIFIRA gitmiyor -- tam tersine, derinlikle BÜYÜYOR.
Neden: y = x + f(x)'in türevi, dy/dx = 1 + f'(x) -- '1' terimi, gradyanın HER ZAMAN en az bir doğrudan
yol üzerinden geri akmasını GARANTİ ediyor. Bu basit fikir, 1000+ katmanlı ağları eğitilebilir kıldı.
AYNI derinlikte (30 katman), atlama bağlantılı ağın gradyanı sıfıra gitmek yerine 99.45’e kadar BÜYÜYOR. Tek fark: her bloğun çıktısına girdiyi geri eklemek.
Nerede işe yarar
Bu beş mimarinin her biri, kendi döneminin bir “aşılması gereken engelini” temsil eder:
- LeNet-5 (1998): İlk pratik CNN — el yazısı rakam tanıma için.
- AlexNet (2012): ReLU (8. ders), dropout (22. ders) ve GPU eğitimiyle ImageNet yarışmasını kazanıp derin öğrenmeyi ana akıma taşıdı.
- VGG (2014): “Sadece 3×3 çekirdekler kullan, derinliği artır” fikrinin basitliğiyle etkili oldu.
- ResNet (2015): Atlama bağlantılarıyla, o zamana kadar İMKANSIZ sayılan derinlikleri (152+ katman) eğitilebilir kıldı.
- Atlama bağlantıları bugün NEREDEYSE HER modern mimaride (transformer’lar dahil, NLP kategorisinde göreceğiz) bir şekilde kullanılıyor.
Bu 3 hatayı yaparsın:
- “Daha derin ağ her zaman daha iyi” sanmak — derinlik, atlama bağlantıları gibi bir ÇÖZÜM olmadan faydasız (hatta zararlı) olabilir.
- Atlama bağlantılarını sadece “ResNet’e özgü egzotik bir teknik” sanmak — aslında son derece basit bir fikir (
y = x + f(x)). - Parametre sayısı ile katman sayısını KARIŞTIRMAK — ResNet-50, VGG-16’dan hem DERİN hem daha AZ parametreli.
Kendini test et
1. Notebook'ta 30 katmanlı düz bir ağda gradyan neden tam olarak 0.0'a düştü?
- Kod hatalıydı
- Her katmanda gradyan küçük bir sayıyla çarpılıyor; 30 kez üst üste çarpılınca sonuç float32'nin temsil edebileceği en küçük sayının bile altına iniyor (5. ders: kaybolan gradyan) (doğru cevap)
- PyTorch 30 katmanı desteklemiyor
- Girdi yanlış tanımlandı
Neden: 5. dersteki zincir kuralı mantığı burada da geçerli: her katmanda küçültücü bir çarpan varsa, bu çarpanlar katman sayısıyla üstel olarak küçülür -- 30 katman sonunda sonuç, float32'nin en küçük temsil edilebilir sayısının bile altına düşer.
2. Atlama bağlantısının (y = x + f(x)) türevindeki '1' terimi neden bu kadar önemli?
- Önemli değildir, sadece matematiksel bir detaydır
- f'(x) ne kadar küçük olursa olsun (kaybolsa bile), gradyan '1' terimi üzerinden HER ZAMAN geri akabilir -- bu, gradyanın tamamen sıfırlanmasını ENGELLER (doğru cevap)
- Bu terim öğrenme oranını değiştirir
- Bu terim sadece ilk katmanı etkiler
Neden: dy/dx = 1 + f'(x) formülündeki sabit '1', f'(x) sıfıra gitse bile toplam türevin en az 1 olmasını garanti eder -- bu da gradyanın derin bir ağda bile TAMAMEN kaybolmasını önler.
3. ResNet-50'nin VGG-16'dan hem daha derin (50 vs 16 katman) hem daha az parametreli (25M vs 138M) olması neyi gösteriyor?
- Katman sayısı ile parametre sayısı her zaman doğru orantılıdır
- Derinlik ve parametre sayısı BAĞIMSIZ tasarım kararlarıdır -- akıllı mimari tasarımı (örn. global average pooling, verimli bloklar) derinliği artırırken parametre sayısını azaltabilir (doğru cevap)
- ResNet-50 aslında VGG-16'dan daha küçük bir modeldir
- Bu rakamlar hatalıdır
Neden: VGG'nin parametrelerinin çoğu son tam bağlı katmanlarından gelir; ResNet gibi mimariler bu büyük FC katmanları yerine global average pooling gibi verimli tekniklerle, daha derin olsalar bile çok daha az parametre kullanabilir.
Özet
Özet
- CNN mimarileri 1998 (LeNet, 7 katman) ile 2015 (ResNet-152, 152 katman) arasında devasa derinleşti.
- Derin ağlarda kaybolan gradyan (5. ders), 2015'ten önce çok derin ağların eğitilmesini engelleyen temel sorundu.
- ResNet'in atlama (residual) bağlantısı, y = x + f(x) ile, gradyanın her zaman en az bir "doğrudan yol" üzerinden akmasını garanti eder.
- Notebook'ta 30 katmanlı bir ağda bu fikir, gradyanı sıfırdan 99.45'e taşıdı.
- Atlama bağlantıları bugün transformer'lar dahil neredeyse her modern mimarinin temel bir bileşenidir.