

Kaybolan gradyan problemi
Önkoşul:Geri yayılım
Kanca
- derste 2 katmanlı bir ağda geri yayılımı elle doğruladık. Peki 15 katmanlı bir ağda ne olur? Zincir kuralı hâlâ matematiksel olarak doğru — ama pratikte BÜYÜK bir sorun ortaya çıkabilir: gradyan, ağın başına ulaşana kadar yok olabilir.
Sezgi
Kaybolan gradyan, geri yayılım zinciri uzadıkça (katman sayısı arttıkça) gradyanların katlanarak küçülüp neredeyse SIFIRA inmesi problemidir. Sebebi basit: her katmanda gradyan, o katmanın aktivasyon türeviyle ÇARPILIR. Sigmoid’in türevi her zaman 0.25’ten küçüktür — bu küçük sayıları art arda 15 kez çarparsan, sonuç akıl almaz derecede küçülür.
Girdiye en yakın katmanın gradyan büyüklüğü: 1.84e-7 (çıktıdaki büyüklük: 6.59e-1) -- sigmoid'in türevi her zaman ≤0.25 olduğu için, katman sayısı arttıkça gradyan katlanarak KÜÇÜLÜYOR.
Katman sayısını artır ve Sigmoid ile ReLU arasında geçiş yap: Sigmoid’de çubuklar, girdiye yaklaştıkça (soldan) HIZLA küçülüyor (log ölçekte bile bariz). ReLU’da ise çubuklar sabit kalıyor — hiç sönümlenme yok.
Mekanizma
Bu kategoride ilk kez PyTorch’u kullanalım — autograd, 4. derste elle yaptığımız zincir kuralı türetmesini otomatikleştiriyor:
İlk PyTorch ağı: autograd
# Bu kategoride İLK KEZ PyTorch kullanıyoruz. autograd, 4. dersteki elle türettiğimiz
# zincir kuralını OTOMATİK uygular -- .backward() çağrısı yeter.
katman = nn.Linear(1, 1, bias=False)
katman.weight.data.fill_(1.0)
girdi = torch.tensor([[1.0]], requires_grad=False)
cikti = torch.sigmoid(katman(girdi))
kayip = 0.5 * (cikti - 0) ** 2
kayip.backward()
print(f"Tek katmanlı ağ: çıktı={cikti.item():.4f}, ağırlık gradyanı={katman.weight.grad.item():.4f}")
print("Elle hiçbir türev almadan, PyTorch bu gradyanı OTOMATİK hesapladı (autograd).")
Tek katmanlı ağ: çıktı=0.7311, ağırlık gradyanı=0.1437
Elle hiçbir türev almadan, PyTorch bu gradyanı OTOMATİK hesapladı (autograd).Tek satır .backward() çağrısı, tüm zincir kuralını arka planda uyguluyor. Şimdi 15 katmanlı, hepsi sigmoid olan derin bir ağ kuralım:
15 katmanlı sigmoid ağ
# Şimdi 15 katmanlı, HER katmanı sigmoid olan derin bir ağ kuralım.
def derin_ag_olustur(katman_sayisi, aktivasyon):
    katmanlar = []
    for _ in range(katman_sayisi):
        lin = nn.Linear(1, 1, bias=False)
        lin.weight.data.fill_(1.0)  # tüm ağırlıklar TAM OLARAK 1 -- sönümlenme SADECE aktivasyondan gelsin
        katmanlar.append(lin)
        katmanlar.append(aktivasyon())
    return nn.Sequential(*katmanlar)

ag_sigmoid = derin_ag_olustur(15, nn.Sigmoid)
x = torch.tensor([[1.0]])
y_tahmin = ag_sigmoid(x)
kayip = 0.5 * (y_tahmin - 0) ** 2
kayip.backward()

gradyan_buyuklukleri_sigmoid = [
    katman.weight.grad.abs().item() for katman in ag_sigmoid if isinstance(katman, nn.Linear)
]
print(f"\n15 katmanlı SİGMOİD ağda, çıktıya en yakın katmanın gradyanı: {gradyan_buyuklukleri_sigmoid[-1]:.2e}")
print(f"Girdiye en yakın (1.) katmanın gradyanı: {gradyan_buyuklukleri_sigmoid[0]:.2e}")
print(f"Oran (çıktı/girdi): {gradyan_buyuklukleri_sigmoid[-1] / gradyan_buyuklukleri_sigmoid[0]:.2e} kat büyük")
15 katmanlı SİGMOİD ağda, çıktıya en yakın katmanın gradyanı: 9.76e-02
Girdiye en yakın (1.) katmanın gradyanı: 1.05e-10
Oran (çıktı/girdi): 9.28e+08 kat büyük
Girdiye en yakın katmanın gradyanı 1.05e-10 — neredeyse sıfır! Şimdi AYNI mimariyi, sadece aktivasyonu ReLU yaparak deneyelim:
15 katmanlı ReLU ağ
ag_relu = derin_ag_olustur(15, nn.ReLU)
y_tahmin_relu = ag_relu(x)
kayip_relu = 0.5 * (y_tahmin_relu - 0) ** 2
kayip_relu.backward()

gradyan_buyuklukleri_relu = [
    katman.weight.grad.abs().item() for katman in ag_relu if isinstance(katman, nn.Linear)
]
print(f"\n15 katmanlı RELU ağda, çıktıya en yakın katmanın gradyanı: {gradyan_buyuklukleri_relu[-1]:.2e}")
print(f"Girdiye en yakın (1.) katmanın gradyanı: {gradyan_buyuklukleri_relu[0]:.2e}")
print("ReLU'da gradyan, 15 katman boyunca neredeyse HİÇ küçülmüyor -- sigmoid'in aksine.")
15 katmanlı RELU ağda, çıktıya en yakın katmanın gradyanı: 1.00e+00
Girdiye en yakın (1.) katmanın gradyanı: 1.00e+00
ReLU'da gradyan, 15 katman boyunca neredeyse HİÇ küçülmüyor -- sigmoid'in aksine.
ReLU’da gradyan, 15 katman boyunca TAM OLARAK 1.00 kalıyor — hiç küçülmüyor! Çoğu kişi “derin ağlar her zaman aynı şekilde eğitilir, katman sayısı sadece kapasiteyi etkiler” sanır. Değil, çünkü aktivasyon fonksiyonunun seçimi, derin bir ağın EĞİTİLEBİLİR olup olmadığını doğrudan belirliyor — bu 928 milyon kat fark, sadece bir sayı değil, “bu ağ hiç öğrenemeyebilir” anlamına geliyor.
Matematik
Neden sigmoid, ReLU değil?
| Fonksiyon | Türevin maksimumu | 15 katman sonra (çarpımsal) |
|---|---|---|
| Sigmoid | 0.25 (sadece ‘da) | — pratikte SIFIRA yakın |
| ReLU | 1 (pozitif bölgede) | — HİÇ küçülmez |
Zincir kuralı, katman katman TÜREVLERİ çarpar (4. dersi hatırla). Sigmoid’in türevi her zaman 1’den küçük olduğu için, bu çarpım katman sayısı arttıkça katlanarak küçülür. ReLU’nun türevi (pozitif bölgede) TAM OLARAK 1 olduğu için, bu çarpım hiç küçülmez.
Kod
Tüm 15 katmanı yan yana karşılaştıralım:
Katman katman karşılaştırma
print(f"\n{'Katman':<10} {'Sigmoid gradyanı':>18} {'ReLU gradyanı':>16}")
for i, (gs, gr) in enumerate(zip(gradyan_buyuklukleri_sigmoid, gradyan_buyuklukleri_relu)):
    print(f"{i + 1:<10} {gs:>18.2e} {gr:>16.2e}")
print("\nSigmoid'in 1. katmanındaki gradyan, ReLU'nunkinden ONLARCA BASAMAK küçük -- bu katman,")
print("gradyan inişiyle GÜNCELLENEMEYECEK kadar küçük bir sinyal alıyor. Bu, 'kaybolan gradyan'.")
Katman       Sigmoid gradyanı    ReLU gradyanı
1                    1.05e-10         1.00e+00
2                    3.91e-10         1.00e+00
3                    1.65e-09         1.00e+00
4                    7.23e-09         1.00e+00
5                    3.21e-08         1.00e+00
6                    1.43e-07         1.00e+00
7                    6.34e-07         1.00e+00
8                    2.82e-06         1.00e+00
9                    1.26e-05         1.00e+00
10                   5.59e-05         1.00e+00
11                   2.49e-04         1.00e+00
12                   1.11e-03         1.00e+00
13                   4.93e-03         1.00e+00
14                   2.19e-02         1.00e+00
15                   9.76e-02         1.00e+00

Sigmoid'in 1. katmanındaki gradyan, ReLU'nunkinden ONLARCA BASAMAK küçük -- bu katman,
gradyan inişiyle GÜNCELLENEMEYECEK kadar küçük bir sinyal alıyor. Bu, 'kaybolan gradyan'.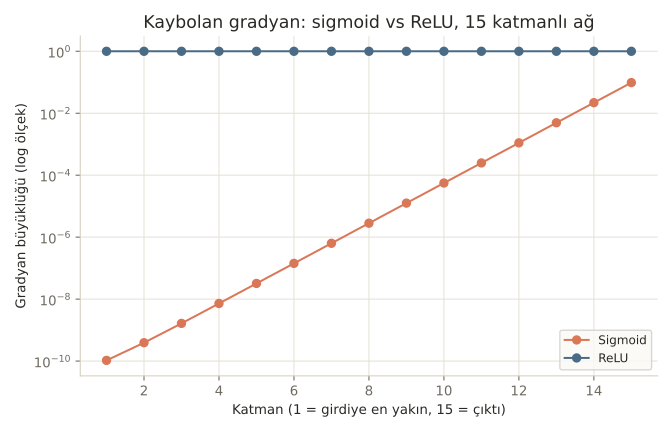
Nerede işe yarar
Kaybolan gradyan problemi, derin öğrenmenin tarihinde ciddi bir engeldi ve hâlâ dikkat gerektirir:
- ReLU’nun (ve türevlerinin) yaygınlaşmasının ana nedeni. 2010’lar öncesi ağlar genelde sigmoid/tanh kullanıyordu ve derinleştikçe eğitilemez hale geliyordu — ReLU bunu büyük ölçüde çözdü.
- Çok derin ağlarda hâlâ dikkat gerektirir. ReLU bile, çok derin ağlarda (yüzlerce katman) başka mekanizmalarla (artık bağlantılar/residual connections, normalizasyon) desteklenir.
- Ağırlık ilklendirme ve normalizasyonla birlikte düşünülür. Bu kategorinin ilerleyen derslerinde (ağırlık ilklendirme, batch/layer normalization) bu sorunun diğer çözümlerini göreceğiz.
Bu 3 hatayı yaparsın:
- Çok derin bir ağda sigmoid/tanh’ı hiç düşünmeden kullanmak — bu derste gördüğümüz gibi, gradyan pratik olarak sıfırlanabilir.
- “Model öğrenmiyor” sorununu her zaman öğrenme oranına bağlamak — bazen kök neden, gradyanın ağın derinliklerine hiç ULAŞAMAMASI.
- ReLU’nun “her sorunu çözdüğünü” düşünmek — ReLU’nun kendi sorunu var (ölü ReLU/dying ReLU), bir sonraki bölümde aktivasyon fonksiyonlarını derinlemesine karşılaştıracağız.
Kendini test et
1. Kaybolan gradyan problemi neden özellikle DERİN (çok katmanlı) ağlarda ortaya çıkar?
- Derin ağlar daha az veri kullanır
- Zincir kuralı, her katmanın aktivasyon türevini ÇARPAR; sigmoid gibi türevi 1'den küçük fonksiyonlarda, bu çarpım katman sayısı arttıkça katlanarak küçülür (doğru cevap)
- Derin ağlar daha yavaş çalışır
- PyTorch derin ağları desteklemez
Neden: Geri yayılım, her katmanda aktivasyon türevini çarpar; sigmoid'in türevi her zaman ≤0.25 olduğu için, katman sayısı arttıkça bu çarpım katlanarak (üstel olarak) küçülür.
2. Notebook'ta 15 katmanlı ReLU ağında gradyan neden HİÇ küçülmedi (tam olarak 1.00 kaldı)?
- Kod hatalıydı
- ReLU'nun türevi, pozitif girdilerde TAM OLARAK 1'dir -- bu değer tekrar tekrar çarpılsa bile hiç küçülmez (doğru cevap)
- ReLU rastgele sayılar üretiyor
- Ağırlıklar sıfırdı
Neden: ReLU'nun türevi pozitif bölgede tam olarak 1 olduğu için, zincir kuralındaki çarpım hiçbir katmanda küçülmez -- 1'i kaç kere çarparsan çarp sonuç yine 1'dir.
3. Girdiye en yakın katmanın gradyanı astronomik derecede küçükse (örn. 1e-10), pratikte ne olur?
- Hiçbir etkisi olmaz
- O katmanın ağırlıkları, gradyan inişiyle neredeyse HİÇ güncellenmez -- ağ, ilk katmanlarında pratik olarak öğrenmeyi durdurur (doğru cevap)
- Model daha hızlı eğitilir
- Kayıp fonksiyonu değişir
Neden: Ağırlık güncelleme adımı gradyanla orantılıdır (4. ML dersini hatırla); gradyan neredeyse sıfırsa, güncelleme adımı da neredeyse sıfır olur -- o katman pratikte öğrenmeyi durdurur.
Özet
Özet
- Kaybolan gradyan, geri yayılım zinciri uzadıkça gradyanların katlanarak küçülüp neredeyse sıfırlanması problemidir.
- Sebebi, her katmanda aktivasyon türevinin gradyana ÇARPILMASI -- sigmoid'in türevi her zaman ≤0.25'tir.
- ReLU'nun türevi (pozitif bölgede) tam olarak 1 olduğu için bu sönümlenmeyi yaşamaz.
- Bu, ReLU'nun modern derin ağlarda sigmoid/tanh'a tercih edilmesinin ana nedenlerinden biridir.
- Kaybolan gradyan yaşayan bir katman, gradyan inişiyle pratikte ÖĞRENMEYİ durdurur.