

Neden tam bağlı ağ yetmez
Önkoşul:Görüntü verisi nedir
Kanca
- derste bir görüntünün sadece bir sayı ızgarası olduğunu gördük. O zaman neden onu düzleştirip (flatten) şimdiye kadar kullandığımız tam bağlı (fully-connected) ağlara veremiyoruz? İki NEDEN var — biri pratik, biri kavramsal.
Sezgi
Birinci sorun: parametre sayısı patlar. İkinci, daha derin sorun: tam bağlı bir ağ, bir örüntünün NEREDE olduğunu öğrenir — NE olduğunu değil. Aynı şekli görüntünün farklı bir köşesinde gösterdiğinde, ağ onu TANIYAMAYABİLİR.
Mekanizma
Önce parametre sayısına bakalım:
Parametre sayısı ne kadar büyüyor?
# Bir görüntüyü DÜZLEŞTİRİP (flatten) tam bağlı bir katmana vermek, ilk bakışta
# mantıklı görünüyor. Ama parametre sayısına bakalım.
def fc_parametre_sayisi(girdi_boyutu, gizli_noron):
    return girdi_boyutu * gizli_noron + gizli_noron  # ağırlıklar + bias

boyutlar = [(28, 28, 1, "MNIST rakamı"), (64, 64, 3, "küçük renkli görsel"), (224, 224, 3, "tipik ImageNet boyutu")]
print(f"{'Görüntü':<24} {'Piksel sayısı':<14} {'Gizli nöron':<12} {'Parametre sayısı':<18}")
for h, w, c, isim in boyutlar:
    girdi_boyutu = h * w * c
    for gizli in [128, 512]:
        p = fc_parametre_sayisi(girdi_boyutu, gizli)
        print(f"{isim:<24} {girdi_boyutu:<14,} {gizli:<12} {p:<18,}")

print("\nTEK bir gizli katman için bile, tipik bir görüntü boyutunda parametre sayısı 77 MİLYONA çıkıyor.")
print("Bu SADECE ilk katman -- gerçek bir ağda onlarca katman olur.")
Görüntü Piksel sayısı Gizli nöron Parametre sayısı
MNIST rakamı 784 128 100,480
MNIST rakamı 784 512 401,920
küçük renkli görsel 12,288 128 1,572,992
küçük renkli görsel 12,288 512 6,291,968
tipik ImageNet boyutu 150,528 128 19,267,712
tipik ImageNet boyutu 150,528 512 77,070,848
TEK bir gizli katman için bile, tipik bir görüntü boyutunda parametre sayısı 77 MİLYONA çıkıyor.
Bu SADECE ilk katman -- gerçek bir ağda onlarca katman olur.Tipik bir ImageNet boyutunda (224×224×3), TEK bir 512 nöronluk gizli katman bile 77 milyon parametre gerektiriyor — ve bu sadece İLK katman. Şimdi ikinci, daha temel soruna bakalım: bir kareyi hep AYNI köşede gösteren bir ağ eğitelim.
Kare hep sol-üst köşede
# Daha da temel bir sorun: FC ağ, "NEREDE" bir örüntü gördüğünü öğrenir -- "NE" olduğunu değil.
def kare_ekle(taban, satir, sutun, boyut=2):
    img = taban.clone()
    img[satir:satir + boyut, sutun:sutun + boyut] = 1.0
    return img

# Eğitim verisi: kare HER ZAMAN sol-üst köşede (satır=0, sütun=0)
N = 40
egitim_x, egitim_y = [], []
for i in range(N):
    if i % 2 == 0:
        img = kare_ekle(torch.zeros(8, 8), 0, 0)
        egitim_y.append(1)
    else:
        img = torch.zeros(8, 8)
        egitim_y.append(0)
    img = img + torch.randn(8, 8) * 0.05
    egitim_x.append(img.flatten())
egitim_x = torch.stack(egitim_x)
egitim_y = torch.tensor(egitim_y, dtype=torch.float32)

ag = nn.Sequential(nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 1), nn.Sigmoid())
optimizer = torch.optim.Adam(ag.parameters(), lr=0.01)
for _ in range(300):
    optimizer.zero_grad()
    tahmin = ag(egitim_x).squeeze()
    kayip = nn.functional.binary_cross_entropy(tahmin, egitim_y)
    kayip.backward()
    optimizer.step()

with torch.no_grad():
    egitim_tahmin = (ag(egitim_x).squeeze() > 0.5).float()
    egitim_dogruluk = (egitim_tahmin == egitim_y).float().mean().item()
print(f"\nEğitim doğruluğu (kare her zaman sol-üst köşede): {egitim_dogruluk:.2f}")
Eğitim doğruluğu (kare her zaman sol-üst köşede): 1.00Eğitim doğruluğu %100 — ağ mükemmel öğrenmiş gibi görünüyor. Şimdi AYNI kareyi, hiç görülmemiş bir köşeye (sağ-alt) koyalım:
Aynı kare, farklı konum
# Şimdi AYNI kareyi, HİÇ görülmemiş bir pozisyona (sağ-alt köşe) koyalım.
test_x, test_y = [], []
for i in range(20):
    if i % 2 == 0:
        img = kare_ekle(torch.zeros(8, 8), 5, 5)  # farklı pozisyon -- eğitimde hiç görülmedi
        test_y.append(1)
    else:
        img = torch.zeros(8, 8)
        test_y.append(0)
    img = img + torch.randn(8, 8) * 0.05
    test_x.append(img.flatten())
test_x = torch.stack(test_x)
test_y = torch.tensor(test_y, dtype=torch.float32)

with torch.no_grad():
    test_tahmin = (ag(test_x).squeeze() > 0.5).float()
    test_dogruluk = (test_tahmin == test_y).float().mean().item()
print(f"Test doğruluğu (AYNI kare, KAYDIRILMIŞ pozisyonda): {test_dogruluk:.2f}")
print("\nEğitimde %100 -- ama pozisyon değişince neredeyse RASTGELE tahmin (%50) seviyesine düşüyor!")
print("Ağ, 'sol-üst köşedeki pikseller parlak' kuralını öğrendi -- 'bir yerde parlak bir kare var' kuralını DEĞİL.")
Test doğruluğu (AYNI kare, KAYDIRILMIŞ pozisyonda): 0.55
Eğitimde %100 -- ama pozisyon değişince neredeyse RASTGELE tahmin (%50) seviyesine düşüyor!
Ağ, 'sol-üst köşedeki pikseller parlak' kuralını öğrendi -- 'bir yerde parlak bir kare var' kuralını DEĞİL.Doğruluk %100’den %55’e (neredeyse rastgele tahmine) düşüyor! Çoğu kişi “ağ kareyi öğrendi, nerede olduğu önemli olmamalı” sanır. Yanlış, çünkü tam bağlı bir katmanda her piksel, KENDİNE ÖZGÜ bir ağırlığa bağlanır — ağ “sol üstteki pikseller parlak” kuralını öğrenir, “bir YERDE parlak bir kare var” kuralını değil.
Matematik
Neden konum bu kadar önemli?
| Sembol | Anlamı |
|---|---|
| . pikselin değeri — her piksel, görüntüdeki SABİT bir konuma karşılık gelir | |
| O SPESİFİK piksel konumuna atanmış, kendine özgü ağırlık |
Piksel 5’teki bir desen ile piksel 500’deki AYNI desen, TAMAMEN farklı ağırlık kümeleriyle çarpılır. Ağın “bu bir kare” demesi için, o deseni GÖRDÜĞÜ HER konum için AYRI AYRI öğrenmesi gerekir.
Kod
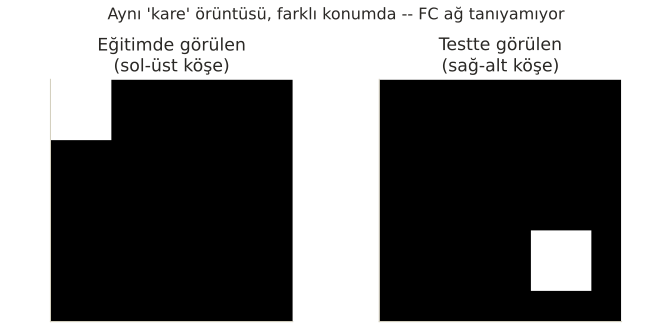
Bu iki sorun (parametre patlaması ve konum bağımlılığı) AYNI kökten geliyor: tam bağlı katman, girdinin UZAMSAL yapısını (hangi pikselin hangi pikselin YANINDA olduğunu) hiç bilmiyor — her pikseli bağımsız bir “özellik” gibi görüyor.
Nerede işe yarar
Bu iki sorun, 27. dersten itibaren göreceğimiz konvolüsyon işleminin VAROLUŞ NEDENİDİR:
- Konvolüsyon, AYNI küçük filtreyi görüntünün HER konumuna uygular — bu da parametre sayısını devasa azaltır VE konum bağımsızlığı (translation invariance) sağlar.
- Bir kez öğrenilen bir “kenar algılayıcı” filtre, görüntünün HER YERİNDE aynı şekilde çalışır — tam bağlı katmanın aksine, ayrı ayrı öğrenmeye gerek yoktur.
- Bu, 27-30. dersin ana motivasyonudur — CNN mimarisinin her parçası, bu iki soruna bir çözüm.
Bu 3 hatayı yaparsın:
- Küçük görüntülerde (örn. 28×28) tam bağlı katmanların “yeterince iyi” olduğunu düşünüp bu yaklaşımı büyük görüntülere ölçeklemeye çalışmak.
- Veri artırma (32. ders) olmadan, bir modelin eğitim verisinde görmediği konumlara otomatik genelleyeceğini varsaymak.
- Parametre patlamasının SADECE bir bellek sorunu olduğunu sanmak — konum bağımlılığı, çok daha temel bir GENELLEME sorunudur.
Kendini test et
1. Notebook'ta eğitim doğruluğu %100 iken, kare farklı bir köşeye taşındığında test doğruluğu neden %55'e (rastgele seviyeye) düştü?
- Model yeterince eğitilmedi
- Tam bağlı katmanda her piksel kendine özgü bir ağırlığa bağlıdır -- ağ "sol-üst köşe parlak" kuralını öğrendi, "bir yerde parlak kare var" kuralını değil (doğru cevap)
- Test verisi hatalıydı
- Kare şekli değişti
Neden: Tam bağlı katman, her piksel konumuna ayrı bir ağırlık atar; ağ, deseni GÖRDÜĞÜ spesifik piksel konumlarını öğrenir -- aynı desen farklı bir konumda tamamen farklı ağırlıklarla çarpılacağı için tanınmaz.
2. 224×224×3 boyutunda bir görüntüde, tek bir 512 nöronluk tam bağlı katmanın parametre sayısı neden bu kadar büyük (77 milyon)?
- PyTorch verimsiz kod üretiyor
- Her giriş pikseli, her çıkış nöronuna AYRI bir ağırlıkla bağlanır -- piksel sayısı (150,528) ile nöron sayısının (512) çarpımı devasa bir sayı üretir (doğru cevap)
- Renkli görüntüler her zaman bu kadar parametre gerektirir
- Bu bir hesaplama hatasıdır
Neden: Tam bağlı bir katmanda parametre sayısı = girdi boyutu × çıkış nöron sayısı; 150,528 piksel × 512 nöron gibi büyük sayılar çarpıldığında parametre sayısı milyonlara kolayca ulaşır.
3. Konvolüsyon işlemi (27. ders), bu derste gösterilen iki soruna nasıl çözüm sunuyor?
- Sadece parametre sayısını azaltır, konum sorununu çözmez
- AYNI küçük filtreyi görüntünün HER konumuna uygulayarak hem parametre sayısını azaltır hem de öğrenilen bir örüntünün görüntünün her yerinde tanınmasını sağlar (doğru cevap)
- Görüntüyü küçültüp sorunu basitleştirir
- Konvolüsyon bu sorunlarla ilgisizdir
Neden: Konvolüsyon, tek bir küçük filtreyi kaydırarak görüntünün tüm konumlarına uygular -- bu hem paylaşılan (çok daha az) parametre sayısı hem de konumdan bağımsız örüntü tanıma sağlar.
Özet
Özet
- Görüntüleri düzleştirip tam bağlı katmanlara vermek, parametre sayısını devasa büyütür (tipik boyutlarda milyonlarca).
- Daha temel bir sorun: tam bağlı katman, bir örüntünün NEREDE olduğunu öğrenir, NE olduğunu değil.
- Aynı desen farklı bir konumda gösterildiğinde, tam bağlı ağ onu tanımayabilir -- notebook'ta doğruluk %100'den %55'e düştü.
- Bu iki sorun (parametre patlaması ve konum bağımlılığı) aynı kökten geliyor: uzamsal yapının göz ardı edilmesi.
- Konvolüsyon (27. ders), aynı filtreyi her konuma uygulayarak bu iki sorunu birlikte çözüyor.