

Optimizasyona giriş
Önkoşul:Sınıflandırma kayıp fonksiyonları
Kanca
- dersten beri ağırlıkları hep aynı kuralla güncelledik:
w = w - öğrenme_oranı * gradyan. Bu kurala optimizer (eniyileyici) denir. Sonraki 5 derste (SGD’den Adam’a) bu kuralın farklı versiyonlarını göreceğiz — ama önce, bu derste, TEK bir optimizer’ın (SGD) kendisini derinlemesine anlayalım.
Sezgi
Önce her şeyi bir arada görelim: veri şekli seç, ağın katman/nöron sayısını ve aktivasyonunu ayarla, “Oynat”a bas ve ağın SGD ile nasıl öğrendiğini canlı izle.
- Tur
- 0
- Kayıp
- 0.000
- Doğruluk
- %50
- Sınıf 0
- Sınıf 1
"Oynat"a bas -- ağ, gösterdiğin veri şeklini öğrenmeye çalışırken karar sınırının nasıl şekillendiğini izle.
Bu, 1-13. derste öğrendiğin HER ŞEYİN bir araya gelmiş hali: ileri yayılım (3. ders), geri yayılım (4. ders), aktivasyon seçimi (6-10. ders), kayıp fonksiyonu (11-13. ders) ve şimdi — optimizasyon. Farklı veri şekillerinde, farklı aktivasyonların ne kadar hızlı (veya yavaş) öğrendiğine dikkat et.
Mekanizma
Şimdi optimizasyonun kendisine odaklanalım. “Optimizer nesnesi” dediğimiz şey, aslında 4. dersten beri elle yazdığımız güncelleme kuralının kısaltılmış hali:
Manuel güncelleme (4. dersin hatırlatması)
# 4. derste ağırlıkları ELLE güncellemiştik: w = w - öğrenme_oranı * gradyan.
# "Optimizasyon", bu güncelleme kuralının KENDİSİDİR -- ve bu ders boyunca
# farklı kurallar (SGD, momentum, Adagrad, RMSprop, Adam) öğreneceğiz.
w = torch.tensor(10.0, requires_grad=True)
ogrenme_orani = 0.1

for adim in range(5):
    kayip = (w - 2) ** 2  # basit bir "vadi": minimum w=2'de
    kayip.backward()
    with torch.no_grad():
        w -= ogrenme_orani * w.grad
    print(f"  adım {adim}: w={w.item():.4f}, kayıp={kayip.item():.4f}, gradyan={w.grad.item():.4f}")
    w.grad.zero_()
adım 0: w=8.4000, kayıp=64.0000, gradyan=16.0000
adım 1: w=7.1200, kayıp=40.9600, gradyan=12.8000
adım 2: w=6.0960, kayıp=26.2144, gradyan=10.2400
adım 3: w=5.2768, kayıp=16.7772, gradyan=8.1920
adım 4: w=4.6214, kayıp=10.7374, gradyan=6.5536torch.optim.SGD ile aynı iş
# PyTorch'ta bu döngüyü elle yazmak yerine bir "optimizer nesnesi" kullanılır.
# torch.optim.SGD, TAM OLARAK yukarıdaki "w -= lr * grad" işlemini yapar -- sadece daha kısa yazılır.
w2 = torch.tensor(10.0, requires_grad=True)
optimizer = torch.optim.SGD([w2], lr=0.1)

print("\noptimizer.SGD ile aynı döngü:")
for adim in range(5):
    optimizer.zero_grad()
    kayip = (w2 - 2) ** 2
    kayip.backward()
    optimizer.step()
    print(f"  adım {adim}: w={w2.item():.4f}, kayıp={kayip.item():.4f}")

print(f"\nManuel döngü ve optimizer.step() AYNI sonucu üretti (w={w.item():.4f} vs w={w2.item():.4f}) -- optimizer sadece bir kolaylık, matematik aynı.")
optimizer.SGD ile aynı döngü:
  adım 0: w=8.4000, kayıp=64.0000
  adım 1: w=7.1200, kayıp=40.9600
  adım 2: w=6.0960, kayıp=26.2144
  adım 3: w=5.2768, kayıp=16.7772
  adım 4: w=4.6214, kayıp=10.7374

Manuel döngü ve optimizer.step() AYNI sonucu üretti (w=4.6214 vs w=4.6214) -- optimizer sadece bir kolaylık, matematik aynı.
Çoğu kişi “optimizer, gizli bir akıllı algoritma” sanır. Değil, çünkü (en basit haliyle, SGD) sadece w -= öğrenme_oranı * gradyan işlemini senin yerine yapan bir kısayoldur — matematik BİREBİR aynı.
Matematik
Gradyan inişinin güncelleme kuralı
| Sembol | Anlamı |
|---|---|
| . adımdaki ağırlık değeri | |
| (eta) | Öğrenme oranı — her adımda ne kadar büyük bir hamle yapılacağı |
| O anki gradyan — kaybın en HIZLI arttığı yön |
Ağırlık, gradyanin TERSİ yönünde (eksi işaret) hareket eder — çünkü amaç kaybı AZALTMAK. ‘nın büyüklüğü, bu hareketin adım boyutunu belirler.
Kod
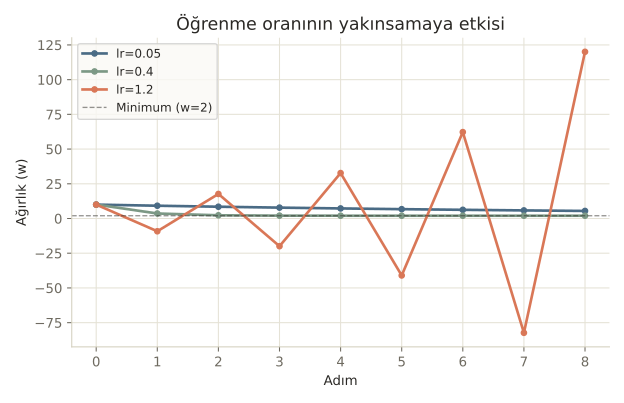
Öğrenme oranının seçimi, eğitimin başarısını doğrudan belirler. Üç senaryoyu karşılaştıralım:
Öğrenme oranının etkisi
# Öğrenme oranı (learning rate), en kritik hiperparametrelerden biri. Üç senaryo:
def egit_adim(lr, adim_sayisi=8):
    w = torch.tensor(10.0, requires_grad=True)
    gecmis = [w.item()]
    for _ in range(adim_sayisi):
        kayip = (w - 2) ** 2
        kayip.backward()
        with torch.no_grad():
            w -= lr * w.grad
        w.grad.zero_()
        gecmis.append(w.item())
    return gecmis

for lr, aciklama in [(0.05, "ÇOK KÜÇÜK -- yavaş ilerliyor"), (0.4, "İYİ -- hızla yakınsıyor"), (1.2, "ÇOK BÜYÜK -- ıraksıyor (patlıyor)")]:
    gecmis = egit_adim(lr)
    print(f"\nlr={lr} ({aciklama}):")
    print("  " + " -> ".join(f"{v:.2f}" for v in gecmis))

print("\nMinimum w=2.0'da. Çok küçük lr yavaş ama güvenli; çok büyük lr her adımda minimumun ETRAFINDA sıçrayıp büyüyor.")
lr=0.05 (ÇOK KÜÇÜK -- yavaş ilerliyor):
  10.00 -> 9.20 -> 8.48 -> 7.83 -> 7.25 -> 6.72 -> 6.25 -> 5.83 -> 5.44

lr=0.4 (İYİ -- hızla yakınsıyor):
  10.00 -> 3.60 -> 2.32 -> 2.06 -> 2.01 -> 2.00 -> 2.00 -> 2.00 -> 2.00

lr=1.2 (ÇOK BÜYÜK -- ıraksıyor (patlıyor)):
  10.00 -> -9.20 -> 17.68 -> -19.95 -> 32.73 -> -41.03 -> 62.24 -> -82.33 -> 120.06

Minimum w=2.0'da. Çok küçük lr yavaş ama güvenli; çok büyük lr her adımda minimumun ETRAFINDA sıçrayıp büyüyor.
lr=0.05 güvenli ama YAVAŞ; lr=0.4 hızlı ve DÜZGÜN yakınsıyor; lr=1.2 ise minimumun etrafında sıçraya sıçraya SONSUZA büyüyor. Bu üçü arasındaki fark, SADECE tek bir sayı.
Nerede işe yarar
Öğrenme oranı, pratikte en çok ayarlanan hiperparametredir:
- Çok küçük → güvenli ama yavaş. Eğitim, gerçek zamanlı bütçende bitmeyebilir.
- Çok büyük → hızlı ama riskli. Kayıp azalmak yerine artabilir (ıraksama) veya NaN’a gidebilir.
- Pratikte genelde 0.1 ile 0.001 arası denenir, ve sonraki derslerde göreceğimiz momentum/Adam gibi yöntemler bu seçimi daha “affedici” hale getirir.
Bu 3 hatayı yaparsın:
- Öğrenme oranını hiç ayarlamadan (varsayılan) bırakıp “model öğrenmiyor” diye modelin kendisini suçlamak — çoğu zaman sorun sadece lr’dir.
- Kaybın NaN’a gittiğini görüp mimariyi değiştirmeye başlamak — önce öğrenme oranını KÜÇÜLT, çoğu ıraksama bundan kaynaklanır.
- “Optimizer” kelimesini duyunca karmaşık bir kara kutu sanmak — SGD’nin özünde 4. dersten beri yaptığımız BASİT çıkarma işlemi var.
Kendini test et
1. torch.optim.SGD, manuel yazdığımız 'w -= lr * grad' döngüsünden nasıl farklıdır?
- Tamamen farklı bir matematik kullanır
- Farklı değildir -- aynı güncelleme kuralını daha kısa şekilde uygular; notebook'ta iki yöntem AYNI sonucu üretti (doğru cevap)
- SGD her zaman daha hızlıdır
- SGD sadece büyük modellerde çalışır
Neden: Notebook'ta manuel döngü ve optimizer.step() birebir aynı w değerini üretti (w=4.6214) -- SGD sadece bu işlemi kısaltan bir arayüzdür.
2. Notebook'ta lr=1.2 kullanıldığında neden ağırlık ıraksadı (sonsuza büyüdü)?
- Kod hatalıydı
- Adım boyutu o kadar büyüktü ki her güncelleme minimumu AŞIP karşı tarafa geçti, ve her geçişte hata daha da büyüdü (doğru cevap)
- lr=1.2 her zaman ıraksar
- Gradyan hesaplanamadı
Neden: Büyük öğrenme oranı, her adımda minimumun çok ötesine geçen bir hamle yapar; bu "aşırı düzeltme" her adımda büyüyerek devam edince ağırlık sonsuza doğru salınarak büyür.
3. Çok küçük bir öğrenme oranının temel dezavantajı nedir?
- Model asla doğru sonuca ulaşamaz
- Yakınsama güvenlidir ama çok YAVAŞ olur -- aynı sonuca ulaşmak çok daha fazla adım gerektirir (doğru cevap)
- Kayıp fonksiyonu değişir
- Hiçbir dezavantajı yoktur
Neden: Küçük öğrenme oranı her adımda çok küçük bir hamle yapar; sonunda minimuma ulaşır ama notebook'taki lr=0.05 örneğinde olduğu gibi bu çok daha fazla adım sürer.
Özet
Özet
- Optimizer, ağırlık güncelleme kuralının kendisidir -- 4. dersten beri elle yaptığımız işlemin kısaltılmış hali.
- torch.optim.SGD, "w -= öğrenme_oranı * gradyan" işlemini yapar -- matematik manuel döngüyle birebir aynıdır.
- Öğrenme oranı çok küçükse yakınsama güvenli ama yavaş; çok büyükse ıraksama (patlama) riski var.
- Öğrenme oranı, en sık ayarlanan hiperparametrelerden biridir.
- Sonraki 5 ders (SGD, momentum, Adagrad, RMSprop, Adam), bu temel güncelleme kuralının farklı, daha akıllı versiyonlarını inceleyecek.