

Geri yayılım
Önkoşul:İleri yayılım
Kanca
- derste bir ağın nasıl TAHMİN ürettiğini gördük (ileri yayılım). Ama bir ağ nasıl ÖĞRENİYOR? Yanlış bir tahmin yaptığında, hangi ağırlığın ne kadar “suçlu” olduğunu nasıl buluyor? Cevap, modern derin öğrenmenin kalbi olan tek bir fikirde saklı: zincir kuralı.
Sezgi
Geri yayılım, kayıptan başlayıp ağın İÇİNDEN GERİYE doğru, her ağırlığın kayba ne kadar katkıda bulunduğunu (gradyanını) hesaplar. Bu, matematikteki ZİNCİR KURALININ (bir sonraki “ek matematik” bölümünde detaylandıracağız) doğrudan bir uygulamasıdır: kayıp çıktıya bağlı, çıktı gizli katmana bağlı, gizli katman ağırlıklara bağlı — bu zincirin her halkasını tek tek çarparak, en baştaki ağırlığa kadar etkiyi taşıyabiliriz.
Gizli nöron 1: z₁ = 0.5·1 + 0.3·1 + 0.1 = 0.900 → h₁ = ReLU(z₁) = 0.900
Gizli nöron 2: z₂ = -0.4·1 + 0.6·1 + -0.15 = 0.050 → h₂ = ReLU(z₂) = 0.050
Çıktı nöronu: ŷ = 0.7·0.900 + (-0.5)·0.050 + 0.2 = 0.805
Kayıp: L = ½(ŷ − y)² = ½(0.805 − 1)² = 0.0190
Girdiler ağdan SIRAYLA (soldan sağa) geçiyor: önce gizli katman, sonra çıktı, sonra kayıp.
“Geri yayılım” sekmesine geç — her satır, bir öncekinin sonucunu KULLANIYOR, ama bu sefer SAĞDAN SOLA. Kayıptan başlayıp önce çıktı katmanına, sonra gizli katmana, en sonunda her bir ağırlığa kadar geri gidiyoruz.
Mekanizma
Aynı 2-2-1 ağla, 3. dersteki ileri yayılımı hatırlayalım:
İleri yayılım hatırlatması
z1 = x @ W1 + b1
h1 = relu(z1)
z_cikti = h1 @ W2 + b2
y_tahmin = z_cikti
kayip = 0.5 * (y_tahmin - y_hedef) ** 2
print(f"İleri yayılım (3. dersten): ŷ={y_tahmin:.3f}, kayıp={kayip:.4f}")
İleri yayılım (3. dersten): ŷ=0.805, kayıp=0.0190Şimdi geri yayılımı elle, zincir kuralıyla adım adım hesaplayalım:
Zincir kuralıyla elle geri yayılım
# Geri yayılım: ZİNCİR KURALINI kullanarak, kayıptan başlayıp AĞIRLIKLARA doğru geriye gidiyoruz.
dL_dyhat = y_tahmin - y_hedef                    # dL/dŷ
dL_dh1 = dL_dyhat * W2[0]                         # dL/dh1 = dL/dŷ * dŷ/dh1
dL_dh2 = dL_dyhat * W2[1]
# z1 aslında [z_norn1, z_norn2] -- gizli katmanın İKİ nöronunun ön-aktivasyonu (3. dersten).
dL_dz1 = dL_dh1 * relu_turev(z1[0])               # dL/dz1 = dL/dh1 * dh1/dz1 (ReLU türevi)
dL_dz2 = dL_dh2 * relu_turev(z1[1])

dL_dW2 = dL_dyhat * h1                            # çıktı katmanı ağırlık gradyanları
dL_db2 = dL_dyhat
dL_dW1 = np.outer(x, [dL_dz1, dL_dz2])            # gizli katman ağırlık gradyanları
dL_db1 = np.array([dL_dz1, dL_dz2])

print(f"\ndL/dŷ = {dL_dyhat:.4f}")
print(f"dL/dh = [{dL_dh1:.4f}, {dL_dh2:.4f}]")
print(f"dL/dz (ReLU sonrası) = [{dL_dz1:.4f}, {dL_dz2:.4f}]")
print(f"dL/dW2 (çıktı ağırlıkları) = {dL_dW2.round(4)}")
print(f"dL/dW1 (gizli katman ağırlıkları) =\n{dL_dW1.round(4)}")
dL/dŷ = -0.1950
dL/dh = [-0.1365, 0.0975]
dL/dz (ReLU sonrası) = [-0.1365, 0.0975]
dL/dW2 (çıktı ağırlıkları) = [-0.1755 -0.0097]
dL/dW1 (gizli katman ağırlıkları) =
[[-0.1365  0.0975]
 [-0.1365  0.0975]]
Bu sayılar interaktif bileşendeki değerlerle BİREBİR eşleşiyor. Ama bu gradyanların gerçekten DOĞRU olduğunu nasıl bilebiliriz?
Matematik
Zincir kuralı
| Sembol | Anlamı |
|---|---|
| Kaybın, ÇIKTIYA göre değişimi — zincirin ilk halkası | |
| Çıktının, gizli nörona göre değişimi (bu örnekte ) | |
| Aktivasyonun türevi (ReLU için 0 ya da 1) | |
| Ön-aktivasyonun, ağırlığa göre değişimi (bu örnekte ) |
Her halka, KENDİ yerel türevini hesaplar; zincir kuralı bunları çarparak, uzak bir ağırlığın nihai kayba olan TOPLAM etkisini bulur. Ağ ne kadar derin olursa olsun, bu zincir sadece uzar — mantık aynı kalır.
Kod
Elle türettiğimiz gradyanları, BAĞIMSIZ bir yöntemle doğrulayalım — sayısal gradyan kontrolü:
Sayısal gradyan kontrolü
# Elle türettiğimiz gradyanların DOĞRU olduğunu nasıl bilebiliriz? "Sayısal gradyan kontrolü":
# bir ağırlığı ÇOK KÜÇÜK oynat, kaybın ne kadar değiştiğini ölç, analitik gradyanla karşılaştır.
def kayip_hesapla(W1_, b1_, W2_, b2_):
    z1_ = x @ W1_ + b1_
    h1_ = relu(z1_)
    yhat_ = h1_ @ W2_ + b2_
    return 0.5 * (yhat_ - y_hedef) ** 2

epsilon = 1e-5
W2_test_idx = 0
W2_arti = W2.copy(); W2_arti[W2_test_idx] += epsilon
W2_eksi = W2.copy(); W2_eksi[W2_test_idx] -= epsilon
sayisal_gradyan = (kayip_hesapla(W1, b1, W2_arti, b2) - kayip_hesapla(W1, b1, W2_eksi, b2)) / (2 * epsilon)

print(f"\nAnalitik (elle türetilmiş) dL/dW2[0]: {dL_dW2[0]:.6f}")
print(f"Sayısal (ε kadar oynatıp ölçülen) dL/dW2[0]: {sayisal_gradyan:.6f}")
print(f"Fark: {abs(dL_dW2[0] - sayisal_gradyan):.8f}  -- neredeyse SIFIR, zincir kuralımız DOĞRU.")
Analitik (elle türetilmiş) dL/dW2[0]: -0.175500
Sayısal (ε kadar oynatıp ölçülen) dL/dW2[0]: -0.175500
Fark: 0.00000000  -- neredeyse SIFIR, zincir kuralımız DOĞRU.
Analitik (zincir kuralıyla elle türetilmiş) ve sayısal (ağırlığı gerçekten oynatıp ölçülen) gradyanlar BİREBİR aynı — fark tam olarak sıfır. Çoğu kişi “zincir kuralı sadece teorik bir formül, gerçekte optimizer’ın ‘sihirli’ bir şekilde çalıştığını varsaymalıyız” sanır. Değil, çünkü bu, PyTorch gibi kütüphanelerin arka planda yaptığı TAM OLARAK budur — otomatik türev alma (autograd), zincir kuralını senin yerine, ama aynı matematiksel ilkeyle uygular.
Şimdi bu gradyanları kullanarak GERÇEKTEN bir ağırlık güncelleme adımı atalım:
Gradyan inişiyle ağırlık güncelleme
# Gradyanları bulduktan sonra, ağırlıkları GRADYANIN TERSİ yönünde küçük bir adım kaydırıyoruz (4. ML dersini hatırla).
ogrenme_orani = 0.3
W1_yeni = W1 - ogrenme_orani * dL_dW1
b1_yeni = b1 - ogrenme_orani * dL_db1
W2_yeni = W2 - ogrenme_orani * dL_dW2
b2_yeni = b2 - ogrenme_orani * dL_db2

kayip_once = kayip_hesapla(W1, b1, W2, b2)
kayip_sonra = kayip_hesapla(W1_yeni, b1_yeni, W2_yeni, b2_yeni)
print(f"\nBir gradyan inişi adımından ÖNCE kayıp: {kayip_once:.4f}")
print(f"Bir gradyan inişi adımından SONRA kayıp:  {kayip_sonra:.4f}")
print(f"Tek bir geri yayılım + güncelleme adımı, kaybı {(1 - kayip_sonra / kayip_once) * 100:.1f}% azalttı.")
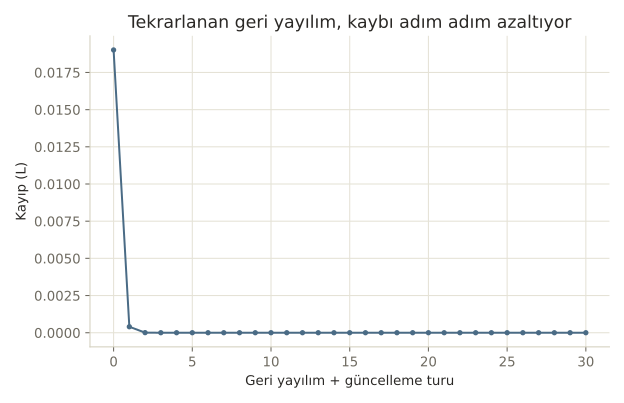
Bir gradyan inişi adımından ÖNCE kayıp: 0.0190
Bir gradyan inişi adımından SONRA kayıp:  0.0004
Tek bir geri yayılım + güncelleme adımı, kaybı 97.9% azalttı.
Tek bir geri yayılım + güncelleme adımı, kaybı %97.9 azalttı!
Nerede işe yarar
Geri yayılım, EVERY modern sinir ağının eğitiminin temelini oluşturur:
- PyTorch/TensorFlow’un
backward()fonksiyonu. Bu kütüphaneler, senin yazdığın ileri yayılım kodundan otomatik olarak zincir kuralını çıkarır (autograd) — elle türetmene gerek kalmaz. - Gradyan kontrolü, gerçek hata ayıklamada kullanılır. Özel bir katman veya kayıp fonksiyonu yazarken, geri yayılım kodunun doğruluğunu bu yöntemle test edebilirsin.
- “Neden derinlik bazen zorlaşıyor” sorusunun temeli. Bir sonraki derste (kaybolan gradyan), bu zincirin çok UZADIĞINDA neler ters gidebileceğini göreceğiz.
Bu 3 hatayı yaparsın:
- Geri yayılımı “sihirli bir kara kutu” sanıp hiç anlamaya çalışmamak — bu derste gördüğümüz gibi, aslında basit bir zincir kuralı uygulamasından ibaret.
- Kendi özel katmanını yazarken gradyan kontrolü yapmayı atlamak — bu derste gördüğümüz teknik, gerçek hata ayıklamada hayat kurtarır.
- Öğrenme oranını (bu derste 0.3) düşünmeden çok büyük seçmek — 4. ML dersini hatırla, çok büyük adımlar kaybı azaltmak yerine ıraksatabilir.
Kendini test et
1. Geri yayılım, matematiksel olarak hangi ilkeye dayanır?
- Rastgele arama
- Zincir kuralı -- kayıptan çıktıya, çıktıdan gizli katmana, gizli katmandan ağırlıklara doğru yerel türevleri çarparak etkiyi taşımak (doğru cevap)
- En küçük kareler yöntemi
- Bayes teoremi
Neden: Geri yayılım, kalkülüsteki zincir kuralını kullanarak, kayıptan en baştaki ağırlıklara kadar her 'halkanın' yerel türevini çarpıp nihai gradyanı hesaplar.
2. Notebook'ta analitik ve sayısal gradyanın BİREBİR aynı çıkması neyi kanıtlıyor?
- Hiçbir şey, tesadüf
- Zincir kuralıyla elle türetilen gradyan hesaplamasının DOĞRU olduğunu -- iki bağımsız yöntem aynı sonuca ulaştı (doğru cevap)
- Kod hatalı çalıştığını
- Öğrenme oranının yanlış olduğunu
Neden: Sayısal gradyan kontrolü, ağırlığı gerçekten küçük oynatıp kaybın ne kadar değiştiğini ÖLÇEREK gradyanı bağımsız bir şekilde tahmin eder; bu, zincir kuralıyla türetilen analitik gradyanla eşleştiği için hesaplamanın doğruluğunu kanıtlar.
3. Tek bir geri yayılım + güncelleme adımının kaybı %97.9 azaltması neyi gösteriyor?
- Bu her zaman böyle olur, her ağırlık güncellemesi kaybı bu kadar azaltır
- Gradyanların doğru yönü gösterdiğini ve öğrenme oranının (bu örnekte) bu adımda etkili bir adım büyüklüğü sağladığını (doğru cevap)
- Model artık hiç eğitime ihtiyaç duymuyor
- Kod hatalı çalıştı
Neden: Bu dramatik iyileşme, doğru hesaplanan gradyanların kaybı azaltan yönü doğru gösterdiğinin somut bir kanıtı -- ama her problemde bu kadar büyük bir tek-adım iyileşmesi garanti değildir, öğrenme oranına ve probleme bağlıdır.
Özet
Özet
- Geri yayılım, zincir kuralını kullanarak kayıptan her ağırlığa kadar gradyanı geriye doğru taşır.
- Her "halka", sadece kendi yerel türevini hesaplar; zincir kuralı bunları çarparak toplam etkiyi bulur.
- Sayısal gradyan kontrolü (ağırlığı ε kadar oynatıp kaybı ölçmek), analitik gradyanların doğruluğunu bağımsız olarak doğrular.
- Gradyanlar bulunduktan sonra, ağırlıklar gradyanın TERSİ yönünde küçük adımlarla güncellenir.
- PyTorch gibi kütüphaneler, bu süreci "autograd" ile otomatikleştirir -- ama arka planda olan matematik tam olarak budur.