

Sigmoid
Önkoşul:Kaybolan gradyan problemi
Kanca
- ML dersinde sigmoid’i lojistik regresyonda gördük — bir “ham skoru” olasılığa çeviren bir araçtı. 5. derste ise aynı fonksiyonun DERİN ağlarda gradyanı yok ettiğini gördük. Bu iki gözlemi birleştirelim: sigmoid’in şekli, TAM OLARAK neden bu iki sonucu birlikte doğuruyor?
Sezgi
Sigmoid, herhangi bir sayıyı (0, 1) aralığına sıkıştıran S şeklinde bir eğridir. Uçlarda (çok büyük veya çok küçük girdilerde) neredeyse düzleşir — çıktı 0’a veya 1’e “yapışır” ve girdideki küçük değişikliklere neredeyse hiç tepki vermez. Bu düzleşmeye doygunluk (saturation) denir.
f(x) f'(x) doygunluk bölgesi (|f'(x)| < 0.02)
Sigmoid sekmesinde, mavi çizgi (f(x)) ve turuncu kesikli çizgiyi (f’(x), türev) karşılaştır: türev sadece x=0 civarında büyük, uçlara doğru neredeyse SIFIRLANIYOR (kırmızı gölgeli bölgeler). Bu derste bu şeklin NEDEN bu kadar önemli olduğunu göreceğiz.
Mekanizma
Önce sigmoid’in temel davranışına bakalım:
Sigmoid fonksiyonu
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

x_degerleri = np.array([-10, -5, -2, 0, 2, 5, 10])
print(f"{'x':>6} {'sigmoid(x)':>12}")
for x in x_degerleri:
    print(f"{x:>6} {sigmoid(x):>12.5f}")
print("\nÇıktı HER ZAMAN (0, 1) aralığında -- 10. ML dersindeki lojistik regresyonun AYNI fonksiyonu.")
x sigmoid(x)
-10 0.00005
-5 0.00669
-2 0.11920
0 0.50000
2 0.88080
5 0.99331
10 0.99995
Çıktı HER ZAMAN (0, 1) aralığında -- 10. ML dersindeki lojistik regresyonun AYNI fonksiyonu.Çıktı her zaman (0, 1) aralığında — x=-10’da neredeyse 0, x=10’da neredeyse 1. Şimdi türevine bakalım:
Türev ve doygunluk
def sigmoid_turev(x):
    s = sigmoid(x)
    return s * (1 - s)

print(f"\n{'x':>6} {'sigmoid(x)':>12} {'türev':>10}")
for x in x_degerleri:
    print(f"{x:>6} {sigmoid(x):>12.5f} {sigmoid_turev(x):>10.6f}")
print("\nTürev x=0'da MAKSİMUM (0.25), |x| büyüdükçe HIZLA sıfıra yaklaşıyor -- 5. dersteki 'doygunluk' tam olarak bu.")
     x   sigmoid(x)      türev
   -10      0.00005   0.000045
    -5      0.00669   0.006648
    -2      0.11920   0.104994
     0      0.50000   0.250000
     2      0.88080   0.104994
     5      0.99331   0.006648
    10      0.99995   0.000045

Türev x=0'da MAKSİMUM (0.25), |x| büyüdükçe HIZLA sıfıra yaklaşıyor -- 5. dersteki 'doygunluk' tam olarak bu.
Türev x=0’da tam olarak 0.25 (maksimum), ama x=10’da sadece 0.000045! Çoğu kişi “sigmoid’in 0 ile 1 arasında çıktı vermesi, onu ‘güvenli’ bir aktivasyon yapar” sanır. Eksik, çünkü çıktının sınırlı olması, gradyanın da (türevin) sınırlı ve çoğu bölgede neredeyse SIFIR olması anlamına geliyor — bu tam olarak 5. derste gördüğümüz kaybolan gradyanın kaynağı.
Matematik
Sigmoid ve türevi
| Sembol | Anlamı |
|---|---|
| Sigmoid çıktısı — her zaman (0, 1) aralığında | |
| Türev — formülüyle hesaplanır, maksimumu ‘da 0.25 | |
| Doygunluk | büyüdükçe 0’a veya 1’e yaklaşır, sıfıra yaklaşır |
Türevin formülü zarif: ‘in kendisiyle ifade edilebiliyor, bu da hesaplamayı kolaylaştırıyor. Ama bu zarafet, 0 veya 1’e yakınsa ‘in de otomatik olarak küçük olması bedelini taşıyor.
Kod
PyTorch’un autograd’ı ile elle türettiğimiz formülü doğrulayalım:
PyTorch ile doğrulama
x_torch = torch.tensor([-10.0, -5.0, -2.0, 0.0, 2.0, 5.0, 10.0], requires_grad=True)
y_torch = torch.sigmoid(x_torch)
y_torch.sum().backward()  # her x için ayrı ayrı gradyan almak için .sum().backward() kullanıyoruz

print(f"\n{'x':>6} {'PyTorch sigmoid':>16} {'PyTorch gradyan':>16} {'Elle hesaplanan':>16}")
for i, x in enumerate(x_degerleri):
    print(f"{x:>6} {y_torch[i].item():>16.5f} {x_torch.grad[i].item():>16.6f} {sigmoid_turev(x):>16.6f}")
print("\nPyTorch'un autograd'ı ile elle türettiğimiz formül BİREBİR aynı sonucu veriyor.")
     x  PyTorch sigmoid  PyTorch gradyan  Elle hesaplanan
   -10          0.00005         0.000045         0.000045
    -5          0.00669         0.006648         0.006648
    -2          0.11920         0.104994         0.104994
     0          0.50000         0.250000         0.250000
     2          0.88080         0.104994         0.104994
     5          0.99331         0.006648         0.006648
    10          0.99995         0.000045         0.000045

PyTorch'un autograd'ı ile elle türettiğimiz formül BİREBİR aynı sonucu veriyor.
Birebir aynı sonuçlar. Şimdi bu “hassasiyet” kaybının somut etkisine bakalım:
Girdi büyüklüğünün hassasiyete etkisi
# 5. dersteki 15 katmanlı ağı hatırla: sigmoid'in doygunluğu, DERİN ağlarda gradyanı yok ediyordu.
# Burada TEK bir sigmoid katmanının, girdinin büyüklüğüne göre ne kadar "hassas" kaldığını görelim.
girdi_araligi = np.linspace(-10, 10, 5)
hassasiyet = sigmoid_turev(girdi_araligi)
print(f"\nGirdi büyüklüğü arttıkça (uzaklaştıkça) hassasiyet (türev):")
for g, h in zip(girdi_araligi, hassasiyet):
    cubuk = "█" * int(h * 100)
    print(f"  x={g:>6.1f}  türev={h:.4f}  {cubuk}")
Girdi büyüklüğü arttıkça (uzaklaştıkça) hassasiyet (türev):
  x= -10.0  türev=0.0000
  x=  -5.0  türev=0.0066
  x=   0.0  türev=0.2500  █████████████████████████
  x=   5.0  türev=0.0066
x= 10.0 türev=0.0000 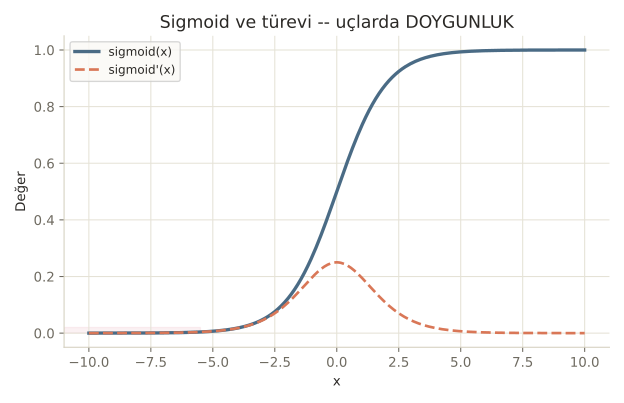
Nerede işe yarar
Sigmoid, tarihsel önemine rağmen bugün DİKKATLİ kullanılması gereken bir araçtır:
- Çıktı katmanında olasılık üretmek için hâlâ standart. 10. ML dersindeki gibi, ikili sınıflandırmanın SON katmanında sigmoid doğal bir seçimdir (gizli katmanlarda değil).
- Kapı (gate) mekanizmalarında. LSTM gibi mimarilerde (NLP kategorisinde göreceğiz), “ne kadarını geçireyim” sorusuna 0-1 arası bir cevap gerektiğinde.
- Gizli katmanlarda NADİREN tercih edilir. 5. derste gördüğümüz kaybolan gradyan riski yüzünden, modern derin ağların gizli katmanlarında genelde ReLU (8. ders) tercih edilir.
Bu 3 hatayı yaparsın:
- Derin bir ağın TÜM gizli katmanlarında sigmoid kullanmak — 5. dersteki 928 milyon kat fark bunun neden riskli olduğunu gösteriyor.
- Girdileri büyük ölçekte (örn. -100 ile 100 arası) sigmoid’e vermek — bu, neredeyse HER noktayı doygunluk bölgesine iter.
- Sigmoid’in türevini her seferinde ‘ten yeniden hesaplamak — formülü, zaten hesaplanmış ‘i yeniden kullanarak çok daha verimlidir.
Kendini test et
1. Sigmoid fonksiyonunun türevi ne zaman MAKSİMUM değerine ulaşır?
- x çok büyükken
- x çok küçükken (negatif)
- x=0 civarında (doğru cevap)
- Türev hiçbir zaman değişmez
Neden: Sigmoid'in türevi σ(x)(1-σ(x)) formülüyle hesaplanır; bu ifade σ(x)=0.5 olduğunda (yani x=0'da) maksimuma (0.25) ulaşır.
2. 'Doygunluk' (saturation) terimi neyi ifade eder?
- Modelin çok fazla veri görmesi
- Girdi büyüklüğü arttıkça, sigmoid çıktısının 0 veya 1'e "yapışması" ve türevin neredeyse sıfırlanması (doğru cevap)
- Ağırlıkların çok büyük olması
- Modelin aşırı öğrenmesi
Neden: Doygunluk, girdi |x| büyüdükçe sigmoid çıktısının 0 veya 1'e yaklaşıp türevin neredeyse sıfırlanmasıdır -- bu bölgelerde gradyan neredeyse hiç akmaz.
3. 5. dersteki kaybolan gradyan problemi ile bu dersteki sigmoid doygunluğu arasındaki bağlantı nedir?
- Aralarında bağlantı yoktur
- Sigmoid'in türevinin her zaman ≤0.25 olması ve uçlarda sıfıra yaklaşması, tam olarak derin ağlarda gradyanın katman katman küçülmesinin SEBEBİDİR (doğru cevap)
- Kaybolan gradyan sadece ReLU'da olur
- Doygunluk sadece büyük veri setlerinde görülür
Neden: 5. derste gördüğümüz kaybolan gradyan, tam olarak sigmoid'in türevinin küçük olmasından (ve derin ağlarda bu küçük değerlerin katman katman çarpılmasından) kaynaklanıyordu -- bu ders o sebebin matematiğini açıyor.
Özet
Özet
- Sigmoid, herhangi bir girdiyi (0, 1) aralığına sıkıştıran S şeklinde bir fonksiyondur.
- Türevi σ(x)(1-σ(x)) formülüyle hesaplanır, maksimumu (0.25) x=0'dadır.
- Büyük |x| değerlerinde çıktı 0 veya 1'e "yapışır" (doygunluk) ve türev neredeyse sıfırlanır.
- Bu doygunluk, 5. dersteki kaybolan gradyan probleminin doğrudan matematiksel kaynağıdır.
- Modern ağlarda genelde sadece çıktı katmanında (olasılık üretmek için) tercih edilir, gizli katmanlarda nadiren.