

Segmentasyona giriş
Önkoşul:Nesne tespitine giriş
Kanca
- derste nesne tespitinin, bir nesnenin KABA konumunu (dikdörtgen kutu) verdiğini gördük. Segmentasyon, bunu son noktasına taşıyor: dikdörtgen değil, nesnenin TAM PİKSEL SINIRLARI.
Sezgi
Semantik segmentasyon, görüntüdeki HER TEK piksele bir sınıf etiketi atamaktır. Çıktı artık tek bir etiket veya bir kutu değil — girdiyle AYNI çözünürlükte bir “maske”: her piksel için “bu piksel hangi sınıfa ait?” sorusunun cevabı.
Mekanizma
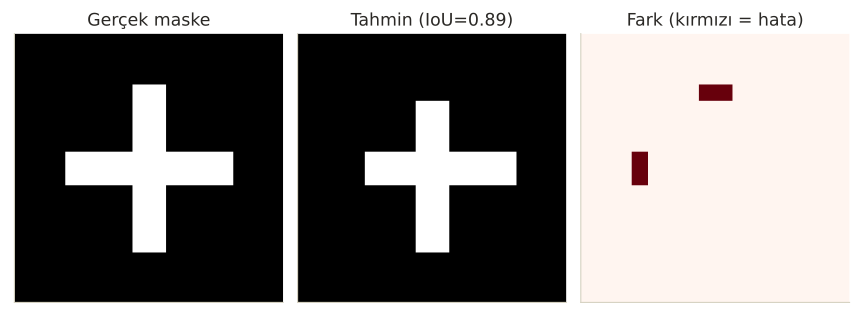
- dersteki “artı” şeklinin GERÇEK (piksel-piksel) maskesini oluşturalım:
Piksel seviyesinde etiketleme
# 34. derste nesne tespiti, bir nesnenin KABA konumunu (dikdörtgen kutu) verdi.
# Segmentasyon daha da ileri gider: HER TEK PİKSELE bir sınıf etiketi atar.
GIRDI_BOYUT = 16
gercek_maske = torch.zeros(GIRDI_BOYUT, GIRDI_BOYUT)
orta = GIRDI_BOYUT // 2
gercek_maske[orta-1:orta+1, 3:13] = 1  # 30. dersteki "artı" şeklinin GERÇEK maskesi
gercek_maske[3:13, orta-1:orta+1] = 1

print(f"Maske şekli: {tuple(gercek_maske.shape)} -- girdiyle AYNI çözünürlükte, her piksel 0 (arka plan) veya 1 (nesne)")
print(f"Nesneye ait piksel sayısı: {int(gercek_maske.sum())} / {GIRDI_BOYUT*GIRDI_BOYUT}")
Maske şekli: (16, 16) -- girdiyle AYNI çözünürlükte, her piksel 0 (arka plan) veya 1 (nesne)
Nesneye ait piksel sayısı: 36 / 256Şimdi kritik bir soru: bir segmentasyon modelini nasıl DEĞERLENDİRİRİZ?
Piksel doğruluğunun tuzağı
# Modelin gerçekçi (biraz kaymış/eksik) bir tahminini değerlendirelim.
tahmin_maske = torch.zeros(GIRDI_BOYUT, GIRDI_BOYUT)
tahmin_maske[orta-1:orta+1, 4:13] = 1  # 1 piksel kısa
tahmin_maske[4:13, orta-1:orta+1] = 1  # 1 piksel kaymış

def piksel_dogrulugu(tahmin, gercek):
    return (tahmin == gercek).float().mean().item()

print(f"\nGerçekçi (biraz hatalı) tahminin piksel doğruluğu: {piksel_dogrulugu(tahmin_maske, gercek_maske):.4f}")

# Şimdi 'hiçbir piksel işaretlenmedi' gibi KÖTÜ bir tahmini deneyelim.
bos_tahmin = torch.zeros(GIRDI_BOYUT, GIRDI_BOYUT)
print(f"'Hiçbir piksel işaretlenmedi' tahmininin piksel doğruluğu: {piksel_dogrulugu(bos_tahmin, gercek_maske):.4f}")
print("\nBoş tahmin bile %85.94 doğruluk veriyor! Çünkü arka plan piksel sayıca ÇOK baskın.")
print("Piksel doğruluğu tek başına YANILTICI -- daha iyi bir metrik gerekiyor.")
Gerçekçi (biraz hatalı) tahminin piksel doğruluğu: 0.9844
'Hiçbir piksel işaretlenmedi' tahmininin piksel doğruluğu: 0.8594

Boş tahmin bile %85.94 doğruluk veriyor! Çünkü arka plan piksel sayıca ÇOK baskın.
Piksel doğruluğu tek başına YANILTICI -- daha iyi bir metrik gerekiyor.
HİÇBİR piksel işaretlemeyen bir tahmin bile %85.94 piksel doğruluğu alıyor! Çünkü arka plan piksel sayıca ÇOK baskın. Çoğu kişi “yüksek doğruluk, iyi model” sanır. Tehlikeli bir varsayım, çünkü dengesiz sınıflarda (11. ML dersindeki dengesiz veri tartışmasını hatırla) doğruluk YANILTICI olabilir.
Matematik
IoU ve Dice katsayısı (segmentasyon için)
| Sembol | Anlamı |
|---|---|
| Modelin DOĞRU işaretlediği piksel sayısı | |
| Ya tahminde ya gerçekte (veya ikisinde de) işaretli piksel sayısı |
- dersteki IoU formülüyle AYNI fikir — ama artık dikdörtgen alanlar yerine PİKSEL kümeleri üzerinde. “Hiçbir şey işaretleme” stratejisi, IoU’da TAM SIFIR alır — piksel doğruluğunun aksine, bu metrik KANDIRILAMAZ.
Kod
Gerçekçi bir tahminle boş bir tahmini IoU/Dice üzerinden karşılaştıralım, sonra segmentasyonun MİMARİ gereksinimine bakalım:
IoU ve Dice ile dürüst değerlendirme
# IoU (34. dersten) ve Dice katsayısı, sınıf DENGESİZLİĞİNE karşı çok daha dayanıklı.
def iou_maske(tahmin, gercek):
    kesisim = (tahmin * gercek).sum()
    birlesim = ((tahmin + gercek) > 0).float().sum()
    return (kesisim / birlesim).item()

def dice_katsayisi(tahmin, gercek):
    kesisim = (tahmin * gercek).sum()
    return (2 * kesisim / (tahmin.sum() + gercek.sum())).item()

print(f"\n{'Tahmin':<24} {'Piksel doğruluğu':<18} {'IoU':<10} {'Dice':<10}")
print(f"{'Gerçekçi (hafif hatalı)':<24} {piksel_dogrulugu(tahmin_maske, gercek_maske):<18.4f} {iou_maske(tahmin_maske, gercek_maske):<10.4f} {dice_katsayisi(tahmin_maske, gercek_maske):<10.4f}")
print(f"{'Boş (hiçbir şey yok)':<24} {piksel_dogrulugu(bos_tahmin, gercek_maske):<18.4f} {iou_maske(bos_tahmin, gercek_maske):<10.4f} {'tanımsız (0/0)':<10}")
print("\nBoş tahminin piksel doğruluğu YÜKSEK (%85.94) ama IoU'su TAM SIFIR -- IoU, gerçek başarıyı çok daha dürüst yansıtıyor.")
Tahmin                   Piksel doğruluğu   IoU        Dice
Gerçekçi (hafif hatalı)  0.9844             0.8889     0.9412
Boş (hiçbir şey yok)     0.8594             0.0000     tanımsız (0/0)

Boş tahminin piksel doğruluğu YÜKSEK (%85.94) ama IoU'su TAM SIFIR -- IoU, gerçek başarıyı çok daha dürüst yansıtıyor.
Küçült, sonra büyüt (encoder-decoder)
# 30. dersteki CNN, girdiyi (16x16) GİDEREK KÜÇÜLTÜP (4x4'e) tek bir sınıfa indirgiyordu.
# Segmentasyon, TAM TERSİNE, bu küçültülmüş haritayı GİRDİ ÇÖZÜNÜRLÜĞÜNE geri BÜYÜTMELİDİR.
kucuk_harita = torch.rand(1, 1, 4, 4)  # 30. dersteki Pool2 çıktısı gibi
buyutulmus = F.interpolate(kucuk_harita, size=(16, 16), mode="nearest")

print(f"\nKüçültülmüş özellik haritası: {tuple(kucuk_harita.shape)}")
print(f"Girdi çözünürlüğüne büyütülmüş: {tuple(buyutulmus.shape)}")
print("Bu 'küçült-sonra-büyüt' (encoder-decoder) deseni, U-Net gibi segmentasyon mimarilerinin temelidir.")
Küçültülmüş özellik haritası: (1, 1, 4, 4)
Girdi çözünürlüğüne büyütülmüş: (1, 1, 16, 16)
Bu 'küçült-sonra-büyüt' (encoder-decoder) deseni, U-Net gibi segmentasyon mimarilerinin temelidir.- dersteki CNN, girdiyi GİDEREK KÜÇÜLTÜP (16×16 → 4×4) tek bir sınıfa indirgiyordu. Segmentasyon bunun TERSİNİ de yapmalı: küçültülmüş haritayı GİRDİ ÇÖZÜNÜRLÜĞÜNE geri büyütmek (
F.interpolateile). Bu “küçült-sonra-büyüt” deseni, U-Net gibi segmentasyon mimarilerinin temelidir.
Nerede işe yarar
Segmentasyon, tıbbi görüntüleme, otonom araçlar ve fotoğraf düzenleme gibi alanlarda kritik bir tekniktir:
- Semantik segmentasyon her pikseli bir SINIFA atar (örn. “yol”, “araba”, “gökyüzü”) — aynı sınıftan farklı NESNELERİ ayırt etmez.
- Örnek (instance) segmentasyon, aynı sınıftaki farklı nesneleri de AYIRT EDER (örn. “araba 1”, “araba 2”).
- IoU/Dice, sınıf dengesizliğinin YAYGIN olduğu segmentasyon problemlerinde piksel doğruluğundan çok daha güvenilir bir metriktir.
Bu 3 hatayı yaparsın:
- Segmentasyon modelini SADECE piksel doğruluğuyla değerlendirip, modelin aslında hiçbir şey öğrenmediğini fark etmemek.
- Semantik ve örnek segmentasyonu karıştırmak — biri “hangi sınıf”, diğeri “hangi SPESİFİK nesne” sorusuna cevap verir.
- Bir segmentasyon ağının SADECE küçültme (encoder) yaptığını sanıp, çıktının girdiyle AYNI çözünürlükte olması gerektiğini unutmak.
Kendini test et
1. Notebook'ta hiçbir piksel işaretlemeyen bir tahmin neden %85.94 gibi yüksek bir piksel doğruluğu aldı?
- Kod hatalıydı
- Arka plan (nesne OLMAYAN) piksel sayısı, nesneye ait piksellerden ÇOK daha fazlaydı -- "hiçbir şey yok" demek bile çoğu pikselde doğru çıkıyor (doğru cevap)
- Model gerçekten çok başarılıydı
- Piksel doğruluğu formülü yanlış uygulandı
Neden: 16×16=256 pikselin sadece küçük bir kısmı "artı" şekline aitti; geri kalan çoğunluk arka plandı -- "hiçbir şey işaretleme" stratejisi bu baskın arka planı doğru tahmin ettiği için yüksek görünen ama yanıltıcı bir doğruluk verdi.
2. IoU, piksel doğruluğuna göre neden segmentasyon için daha güvenilir bir metrik?
- IoU her zaman daha yüksek çıkar
- IoU, sadece DOĞRU pozitif örtüşmeyi ölçer -- "hiçbir şey işaretlememe" gibi kandırıcı stratejiler IoU'da TAM SIFIR alır, piksel doğruluğunda ise yüksek çıkabilir (doğru cevap)
- IoU hesaplaması daha hızlıdır
- Piksel doğruluğu segmentasyonda hiç kullanılmaz
Neden: IoU, kesişimi birleşime böler -- eğer tahmin hiçbir şey işaretlemiyorsa kesişim sıfırdır ve IoU da sıfır olur; piksel doğruluğu ise baskın arka plan sınıfını doğru bildiği için yanıltıcı şekilde yüksek çıkabilir.
3. Segmentasyon mimarilerinin (örn. U-Net) neden bir "küçült-sonra-büyüt" (encoder-decoder) yapısına ihtiyacı vardır?
- Sadece hesaplamayı hızlandırmak için
- CNN'in katmanları (30. ders) uzamsal boyutu küçültür, ama segmentasyon çıktısının GİRDİYLE AYNI çözünürlükte (her piksel için bir etiket) olması gerekir -- bu yüzden küçültülmüş haritayı geri büyütmek gerekir (doğru cevap)
- Küçültme işlemi segmentasyonda hiç kullanılmaz
- Büyütme işlemi sadece görselleştirme için yapılır
Neden: 30. dersteki CNN'in konvolüsyon+pooling blokları uzamsal boyutu küçültüp tek bir sınıflandırma çıktısına indirger; segmentasyon ise HER piksel için bir etiket istediğinden, küçültülmüş özellik haritasının girdi çözünürlüğüne geri büyütülmesi (upsampling) gerekir.
Özet
Özet
- Semantik segmentasyon, görüntüdeki her piksele bir sınıf etiketi atar -- çıktı, girdiyle aynı çözünürlükte bir maskedir.
- Piksel doğruluğu, sınıf dengesizliğinde (baskın arka plan gibi) yanıltıcı olabilir.
- IoU ve Dice katsayısı, bu tuzağa düşmeyen, kesişim/birleşim tabanlı daha dürüst metriklerdir.
- Segmentasyon mimarileri, CNN'in küçülttüğü uzamsal boyutu girdi çözünürlüğüne geri büyütmelidir (upsampling).
- Semantik segmentasyon "hangi sınıf" sorusuna, örnek segmentasyon "hangi SPESİFİK nesne" sorusuna cevap verir.