

Layer normalization
Önkoşul:Batch normalization
Kanca
- dersteki BatchNorm, her nöronu BATCH boyunca normalize ediyordu — yani bir örneğin sonucu, aynı batch’teki DİĞER örneklere bağlıydı. Layer normalization, normalize etme EKSENİNİ değiştirerek bu bağımlılığı tamamen ortadan kaldırıyor.
Sezgi
Layer normalization (LayerNorm), her ÖRNEĞİ kendi ÖZELLİKLERİ boyunca normalize eder — diğer örneklere hiç bakmaz. BatchNorm “bu nöron, batch’teki DİĞER örneklerde nasıl davranıyor?” diye sorarken, LayerNorm “bu örneğin TÜM özellikleri birlikte nasıl dağılmış?” diye sorar.
Demo’daki “LayerNorm” sekmesine bak — bu kez her SATIRIN (örneğin) std’si tam olarak 1.00.
Ham aktivasyonlar düzensiz: örnekten örneğe (satır) ve nörondan nörona (sütun) çok farklı büyüklük ve merkezlerde.
Mekanizma
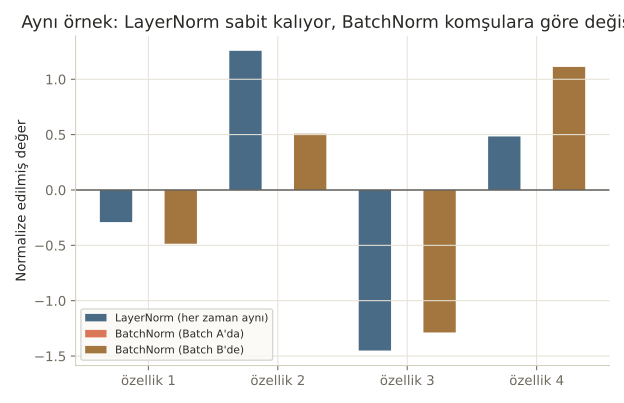
Bu farkın PRATİKTE ne anlama geldiğini somutlaştıralım: aynı örneği, çok farklı “komşularla” aynı batch’e koyalım.
LayerNorm, komşulardan bağımsız
# LayerNorm, BatchNorm'un TERSİ eksende normalize eder: her ÖRNEĞİ kendi
# ÖZELLİKLERİ boyunca normalize eder -- diğer örneklere hiç bakmaz.
ln = nn.LayerNorm(4)

x_tek = torch.tensor([[1.0, 5.0, -2.0, 3.0]])
print("Tek örnek (batch=1) ile LayerNorm:")
print(" ", ln(x_tek).tolist())

x_coklu = torch.tensor([[1.0, 5.0, -2.0, 3.0], [100.0, -50.0, 20.0, 0.0], [0.0, 0.0, 0.0, 0.0001]])
print("\nAynı örnek, çok FARKLI komşularla aynı batch içinde:")
print(" ", ln(x_coklu)[0].tolist())
ayni_mi = torch.allclose(ln(x_tek)[0], ln(x_coklu)[0], atol=1e-5)
print(f"\nİki sonuç BİREBİR aynı mı? {ayni_mi}")
print("LayerNorm, örneğin komşularından TAMAMEN bağımsız -- batch boyutu bile önemsiz.")
Tek örnek (batch=1) ile LayerNorm:
[[-0.2900207042694092, 1.2567564249038696, -1.450103521347046, 0.4833678603172302]]
Aynı örnek, çok FARKLI komşularla aynı batch içinde:
[-0.2900207042694092, 1.2567564249038696, -1.450103521347046, 0.4833678603172302]
İki sonuç BİREBİR aynı mı? True
LayerNorm, örneğin komşularından TAMAMEN bağımsız -- batch boyutu bile önemsiz.Aynı örnek [1, 5, -2, 3], komşuları ne olursa olsun (batch=1 tek başına VEYA çok farklı değerlerle bir batch içinde), LayerNorm’dan BİREBİR AYNI sonucu alıyor. Şimdi AYNI deneyi BatchNorm ile tekrarlayalım:
BatchNorm, komşulara bağımlı
# Şimdi AYNI deneyi BatchNorm ile tekrarlayalım -- sonuç ÇARPICI şekilde farklı olacak.
bn = nn.BatchNorm1d(4)
bn.train()

x_batch_a = torch.tensor([[1.0, 5.0, -2.0, 3.0], [2.0, 4.0, -1.0, 2.0], [0.0, 6.0, -3.0, 4.0]])
x_batch_b = torch.tensor([[1.0, 5.0, -2.0, 3.0], [50.0, -20.0, 10.0, 0.0], [-10.0, 10.0, 5.0, -5.0]])

print("\nAYNI ilk satır ([1,5,-2,3]), İKİ FARKLI batch içinde:")
print(f"  Batch A'daki (benzer komşularla) sonucu: {bn(x_batch_a)[0].tolist()}")
print(f"  Batch B'deki (uç değerli komşularla) sonucu: {bn(x_batch_b)[0].tolist()}")
print("\nBatchNorm'da AYNI örnek, HANGİ diğer örneklerle aynı batch'te olduğuna göre FARKLI sonuç veriyor!")
print("LayerNorm bu soruna kapalı -- bu yüzden değişken uzunluklu diziler ve küçük batch'lerde (NLP kategorisinde transformer'lar) tercih edilir.")
AYNI ilk satır ([1,5,-2,3]), İKİ FARKLI batch içinde:
  Batch A'daki (benzer komşularla) sonucu: [0.0, 0.0, 0.0, 0.0]
  Batch B'deki (uç değerli komşularla) sonucu: [-0.4856652021408081, 0.5080004334449768, -1.2868421077728271, 1.111167311668396]

BatchNorm'da AYNI örnek, HANGİ diğer örneklerle aynı batch'te olduğuna göre FARKLI sonuç veriyor!
LayerNorm bu soruna kapalı -- bu yüzden değişken uzunluklu diziler ve küçük batch'lerde (NLP kategorisinde transformer'lar) tercih edilir.
AYNI satır, Batch A’da [0, 0, 0, 0] iken Batch B’de [-0.49, 0.51, -1.29, 1.11] veriyor! Çoğu kişi “normalizasyon, normalizasyondur — hangisi kullanılırsa kullanılsın sonuç benzer olur” sanır. Yanlış, çünkü BatchNorm’un sonucu, o anki batch’in İÇERİĞİNE bağlıyken, LayerNorm’unki SADECE o örneğin kendi değerlerine bağlı.
Matematik
Layer normalization formülü
| Sembol | Anlamı |
|---|---|
| Örnek indeksi (BatchNorm’daki gibi batch boyunca DEĞİL) | |
| O örneğin özellik (nöron) sayısı — ortalama ve varyans BU eksende hesaplanır | |
| SADECE . örneğin kendi özelliklerinin ortalaması ve varyansı |
BatchNorm’un formülüyle (23. ders) karşılaştır: TEK fark, ortalama/varyansın hangi eksende ( mi mi) hesaplandığı — ama bu tek fark, tüm davranışı değiştiriyor.
Kod
Formülü elle uygulayıp PyTorch’un nn.LayerNorm’uyla doğrulayalım:
Elle hesaplama vs PyTorch
# LayerNorm'un formülünü elle uygulayıp PyTorch'un sonucuyla karşılaştıralım.
x = torch.tensor([2.0, 8.0, -4.0, 6.0])
ort = x.mean()
std = x.std(unbiased=False)  # LayerNorm, POPULASYON std'si kullanır (n'e böler, n-1'e değil)
elle_normalize = (x - ort) / (std + 1e-5)

ln_dogrulama = nn.LayerNorm(4, elementwise_affine=False)  # gamma/beta'sız, saf normalizasyon
pytorch_sonucu = ln_dogrulama(x)

print(f"\nElle hesaplanan: {elle_normalize.tolist()}")
print(f"PyTorch LayerNorm: {pytorch_sonucu.tolist()}")
print(f"Birebir aynı mı? {torch.allclose(elle_normalize, pytorch_sonucu, atol=1e-4)}")
Elle hesaplanan: [-0.2182174026966095, 1.091086983680725, -1.5275218486785889, 0.6546522378921509]
PyTorch LayerNorm: [-0.21821783483028412, 1.091089129447937, -1.5275248289108276, 0.6546534895896912]
Birebir aynı mı? True
Elle hesaplanan ve PyTorch’un sonucu BİREBİR aynı (not: LayerNorm, popülasyon standart sapması — yani n’e bölen versiyonu — kullanır).
Nerede işe yarar
LayerNorm, özellikle DEĞİŞKEN uzunluklu veya küçük batch’li senaryolarda BatchNorm’a tercih edilir:
- Transformer’lar (NLP kategorisinde amiral gemisi konumuz) standart olarak LayerNorm kullanır — diziler farklı uzunlukta olabilir, batch bağımlılığı istenmez.
- Batch boyutu ne olursa olsun AYNI davranır — 23. dersteki batch=1 hatası, LayerNorm’da hiç yaşanmaz.
- train() ve eval() arasında fark YOKTUR — running statistics gerekmez, çünkü her zaman o anki örneğin kendi istatistiği kullanılır.
Bu 3 hatayı yaparsın:
- Görüntü işleme (CNN, bir sonraki bölüm) gibi BATCH bağlamının anlamlı olduğu yerlerde LayerNorm’u BatchNorm yerine kullanmak — her ikisinin de güçlü olduğu farklı bağlamlar var.
- LayerNorm’un da running statistics tuttuğunu sanmak — tutmaz, her forward pass’te o anki örnekten hesaplar.
- Hangi normalizasyonun “daha iyi” olduğunu evrensel bir kural sanmak — CNN’lerde genelde BatchNorm, transformer’larda genelde LayerNorm tercih edilir; bu bağlama bağlıdır.
Kendini test et
1. Notebook'ta aynı örnek, iki farklı batch'te (A ve B) BatchNorm'dan neden FARKLI sonuçlar aldı ama LayerNorm'dan HER ZAMAN aynı sonucu aldı?
- Rastgele bir hata
- BatchNorm, normalizasyon istatistiklerini batch'teki DİĞER örneklerden hesaplar; LayerNorm ise SADECE o örneğin kendi özelliklerinden hesaplar (doğru cevap)
- LayerNorm her zaman sıfır döndürür
- BatchNorm ve LayerNorm aynı formülü kullanır
Neden: BatchNorm'un ortalama/varyansı batch boyunca (diğer örnekler dahil) hesaplanır, bu yüzden komşular değişince sonuç değişir; LayerNorm'unki sadece o örneğin d özelliği üzerinden hesaplanır, komşulardan tamamen bağımsızdır.
2. LayerNorm neden transformer tabanlı modellerde (NLP kategorisi) BatchNorm'a tercih edilir?
- LayerNorm her zaman daha hızlıdır
- Diziler değişken uzunlukta olabilir ve batch bağımlılığı istenmez -- LayerNorm her örneği komşularından bağımsız, tutarlı şekilde işler (doğru cevap)
- BatchNorm transformer'larda çalışmaz
- LayerNorm daha az parametre kullanır
Neden: Transformer girdileri (cümleler gibi) değişken uzunlukta olabilir ve bir örneğin işlenişinin batch'teki diğer örneklere bağlı olması istenmez -- LayerNorm'un batch-bağımsızlığı bu senaryoya tam uyuyor.
3. LayerNorm'da train() ve eval() modları arasında (BatchNorm'un aksine) neden fark yoktur?
- LayerNorm hiçbir zaman normalizasyon yapmaz
- LayerNorm, running statistics BİRİKTİRMEZ -- her forward pass'te doğrudan o anki örnekten ortalama/varyans hesaplar, bu yüzden mod farketmeksizin aynı davranır (doğru cevap)
- LayerNorm sadece eval() modunda çalışır
- train() ve eval() LayerNorm için aynı şeydir çünkü rastgelelik yoktur
Neden: BatchNorm'un train/eval farkı, batch istatistikleri (train) ile biriktirilmiş running istatistiklerin (eval) farklı olmasından kaynaklanır; LayerNorm hiç running istatistik tutmadığı için bu ayrıma ihtiyaç duymaz.
Özet
Özet
- LayerNorm, her örneği kendi özellikleri boyunca normalize eder -- BatchNorm'un aksine batch'teki diğer örneklere bakmaz.
- Aynı örnek, hangi batch'te olursa olsun LayerNorm'dan her zaman aynı sonucu alır.
- LayerNorm, running statistics tutmaz -- train() ve eval() arasında davranış farkı yoktur.
- Batch boyutu 1 bile olsa LayerNorm sorunsuz çalışır -- BatchNorm'un 23. dersteki kısıtlaması burada yoktur.
- CNN'lerde genelde BatchNorm, transformer'larda (NLP kategorisi) genelde LayerNorm tercih edilir -- bağlama bağlı bir seçim.