

CNN mimarisinin tamamı
Önkoşul:Pooling katmanları
Kanca
25-29. derste CNN’in her PARÇASINI ayrı ayrı gördük: piksel/kanal (25), neden tam bağlı ağ yetmez (26), konvolüsyon (27), stride/padding (28), pooling (29). Bu derste hepsini BİR ARAYA getirip, gerçek bir CNN’in baştan sona nasıl çalıştığını izliyoruz.
Sezgi
Tipik bir CNN, konvolüsyon+ReLU+pooling bloklarını art arda tekrarlayıp, en sonunda tam bağlı bir katmanla sınıflandırma yapar. Her blok, uzamsal boyutu KÜÇÜLTÜRKEN, kanal (özellik) sayısını ARTIRIR — “daha az yer, daha çok anlam” deseni.
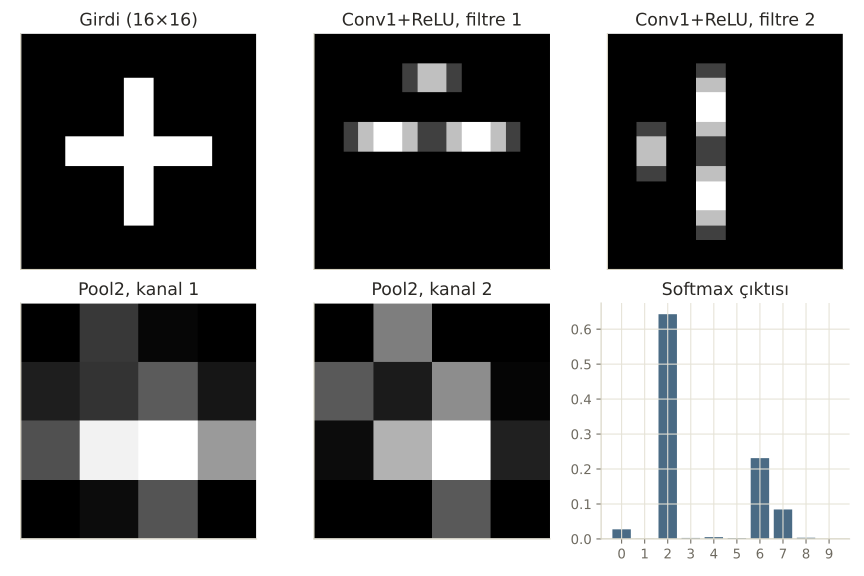
Aşağıdaki gezginde, önhesaplanmış GERÇEK aktivasyonlarla (bir “artı” şekli görselinin) katman katman nasıl dönüştüğünü izle.
16×16, 1 kanal -- bir "artı" şekli (25. ders: piksel ızgarası).
Mekanizma
Notebook’ta AYNI ağı, AYNI görseli kullanarak baştan sona kuralım:
Girdi ve ilk konvolüsyon
# 25-29. derste öğrendiğimiz HER PARÇAYI birleştirip GERÇEK bir CNN'in ileri
# geçişini baştan sona izleyelim. Girdi: 16x16'lık bir "artı" şekli.
GIRDI_BOYUT = 16
girdi = torch.zeros(1, 1, GIRDI_BOYUT, GIRDI_BOYUT)
orta = GIRDI_BOYUT // 2
girdi[0, 0, orta-1:orta+1, 3:13] = 1.0  # yatay kol
girdi[0, 0, 3:13, orta-1:orta+1] = 1.0  # dikey kol

# Conv1: 4 elle-tasarlanmış çekirdek (27. dersteki gibi) -- ilk katmanlar genelde
# kenar/doku gibi BASİT örüntüleri öğrenir, biz burada bunu elle taklit ediyoruz.
k_yatay = torch.tensor([[-1., -2, -1], [0, 0, 0], [1, 2, 1]])
k_dikey = torch.tensor([[-1., 0, 1], [-2, 0, 2], [-1, 0, 1]])
k_capraz = torch.tensor([[2., 1, 0], [1, 0, -1], [0, -1, -2]])
k_blur = torch.ones(3, 3) / 9
conv1_kernel = torch.stack([k_yatay, k_dikey, k_capraz, k_blur]).unsqueeze(1)  # (4 filtre, 1 giriş kanalı, 3, 3)

conv1_cikis = F.conv2d(girdi, conv1_kernel, padding=1)  # "same" padding (28. ders)
print(f"Girdi şekli: {tuple(girdi.shape)} -> Conv1 çıkış şekli: {tuple(conv1_cikis.shape)}")
print("4 filtre, 4 farklı özellik haritası üretti -- her biri farklı bir örüntüye duyarlı.")
Girdi şekli: (1, 1, 16, 16) -> Conv1 çıkış şekli: (1, 4, 16, 16)
4 filtre, 4 farklı özellik haritası üretti -- her biri farklı bir örüntüye duyarlı.ReLU ve ilk pooling
# ReLU (8. ders) negatifleri sıfırlar; MaxPool (29. ders) boyutu yarıya indirir.
relu1_cikis = F.relu(conv1_cikis)
pool1_cikis = F.max_pool2d(relu1_cikis, kernel_size=2, stride=2)

print(f"\nReLU1 sonrası şekil: {tuple(relu1_cikis.shape)} (değişmedi -- ReLU boyutu etkilemez)")
print(f"Pool1 sonrası şekil: {tuple(pool1_cikis.shape)} (16x16 -> 8x8, MaxPool boyutu yarıya indirdi)")
print(f"Negatif değer oranı (ReLU öncesi): {(conv1_cikis < 0).float().mean().item():.2%}")
print(f"Negatif değer oranı (ReLU sonrası): {(relu1_cikis < 0).float().mean().item():.2%}")
ReLU1 sonrası şekil: (1, 4, 16, 16) (değişmedi -- ReLU boyutu etkilemez)
Pool1 sonrası şekil: (1, 4, 8, 8) (16x16 -> 8x8, MaxPool boyutu yarıya indirdi)
Negatif değer oranı (ReLU öncesi): 9.57%
Negatif değer oranı (ReLU sonrası): 0.00%
16×16’lık girdi, Conv1+ReLU1’den sonra HÂLÂ 16×16 (4 kanal) — ama Pool1’den sonra 8×8’e iniyor. Çoğu kişi “her katman boyutu küçültür” sanır. Yanlış, çünkü konvolüsyon (same padding’le) ve ReLU boyutu DEĞİŞTİRMEZ — boyutu küçülten SADECE pooling (ve stride’lı konvolüsyon).
Matematik
Tipik bir CNN bloğunun akışı
| Katman | Boyuta etkisi | Kanal sayısına etkisi |
|---|---|---|
| Konvolüsyon (same padding) | Değiştirmez | ARTIRIR (filtre sayısı kadar) |
| ReLU | Değiştirmez | Değiştirmez |
| Pooling | KÜÇÜLTÜR (genelde yarıya) | Değiştirmez |
Bu üçü ard arda tekrarlandıkça, ağın “görüş alanı” (receptive field) büyür — son katmanlardaki her nöron, girdinin GİDEREK DAHA GENİŞ bir bölgesinden etkilenir.
Kod
İkinci bloğu ve sınıflandırma adımını tamamlayalım:
İkinci konvolüsyon bloğu
# İkinci konvolüsyon bloğu: 4 kanaldan 8 kanala. Bu katmanın çekirdekleri artık
# elle tasarlanmıyor -- gerçek bir ağda geri yayılımla ÖĞRENİLİR (biz burada
# rastgele başlatılmış haliyle gösteriyoruz -- henüz eğitilmemiş bir ağ gibi).
conv2_kernel = torch.randn(8, 4, 3, 3) * 0.3
conv2_cikis = F.conv2d(pool1_cikis, conv2_kernel, padding=1)
relu2_cikis = F.relu(conv2_cikis)
pool2_cikis = F.max_pool2d(relu2_cikis, kernel_size=2, stride=2)

print(f"\nConv2 çıkış şekli: {tuple(conv2_cikis.shape)} -- 4 kanaldan 8 kanala ÇIKTI")
print(f"Pool2 sonrası şekil: {tuple(pool2_cikis.shape)} -- 8x8 -> 4x4")
print("Her konvolüsyon+pool bloğu, uzamsal boyutu KÜÇÜLTÜP kanal (özellik) sayısını ARTIRIYOR.")
print("Bu, CNN mimarilerinin karakteristik deseni: derinleştikçe 'daha az yer, daha çok anlam'.")
Conv2 çıkış şekli: (1, 8, 8, 8) -- 4 kanaldan 8 kanala ÇIKTI
Pool2 sonrası şekil: (1, 8, 4, 4) -- 8x8 -> 4x4
Her konvolüsyon+pool bloğu, uzamsal boyutu KÜÇÜLTÜP kanal (özellik) sayısını ARTIRIYOR.
Bu, CNN mimarilerinin karakteristik deseni: derinleştikçe 'daha az yer, daha çok anlam'.
Düzleştirme, tam bağlı katman, softmax
# Son adım: uzamsal haritayı DÜZLEŞTİRİP (flatten) tam bağlı bir katmana ver --
# 26. derste sorguladığımız o "tam bağlı ağ" burada, ama artık HAM piksellere değil,
# CNN'in çıkardığı YÜKSEK SEVİYELİ özelliklere uygulanıyor.
duzlestir = pool2_cikis.flatten()
fc_agirlik = torch.randn(10, duzlestir.shape[0]) * 0.1
fc_bias = torch.randn(10) * 0.1
fc_cikis = fc_agirlik @ duzlestir + fc_bias
softmax_cikis = F.softmax(fc_cikis, dim=0)

print(f"\nDüzleştirilmiş vektör boyutu: {duzlestir.shape[0]} (4×4×8)")
print(f"FC çıkış (10 'sınıf' için ham logit): {[f'{v:.2f}' for v in fc_cikis.tolist()]}")
print(f"Softmax sonrası olasılıklar: {[f'{v:.3f}' for v in softmax_cikis.tolist()]}")
print(f"En yüksek olasılıklı sınıf: {softmax_cikis.argmax().item()} (olasılık={softmax_cikis.max().item():.3f})")
print("\nBu 'sınıf' rastgele başlatılmış (eğitilmemiş) ağırlıklarla üretildi -- gerçek bir sınıflandırma değil,")
print("sadece 27-30. derste gördüğümüz TÜM parçaların (konv, ReLU, pool, FC, softmax) nasıl ZİNCİRLENDİĞİNİ gösteriyor.")
Düzleştirilmiş vektör boyutu: 128 (4×4×8)
FC çıkış (10 'sınıf' için ham logit): ['-0.41', '-4.89', '2.74', '-2.64', '-2.08', '-2.80', '1.72', '0.71', '-2.50', '-6.39']
Softmax sonrası olasılıklar: ['0.027', '0.000', '0.643', '0.003', '0.005', '0.003', '0.231', '0.084', '0.003', '0.000']
En yüksek olasılıklı sınıf: 2 (olasılık=0.643)

Bu 'sınıf' rastgele başlatılmış (eğitilmemiş) ağırlıklarla üretildi -- gerçek bir sınıflandırma değil,
sadece 27-30. derste gördüğümüz TÜM parçaların (konv, ReLU, pool, FC, softmax) nasıl ZİNCİRLENDİĞİNİ gösteriyor.
Son adımda, 4×4×8’lik uzamsal harita düzleştirilip (26. dersteki “tam bağlı ağ” fikri BURADA geri dönüyor — ama artık ham piksellere değil, CNN’in çıkardığı YÜKSEK SEVİYELİ özelliklere uygulanıyor) 10 “sınıf” üzerinde bir softmax (9. ders) dağılımı üretiliyor.
Nerede işe yarar
Bu “konv+ReLU+pool bloklarını tekrarla, sonunda FC+softmax” deseni, neredeyse TÜM klasik CNN mimarilerinin (31. ders) iskeletidir:
- Erken bloklar (girdiye yakın) BASİT örüntüleri (kenar, doku) yakalar — notebook’taki elle tasarladığımız Conv1 filtreleri gibi.
- Derin bloklar (çıktıya yakın) KARMAŞIK, SOYUT örüntüleri (şekil, nesne parçası) yakalar — gerçek ağlarda bu, eğitimle kendiliğinden ortaya çıkar.
- Bu derste kullandığımız ağırlıklar RASTGELE (eğitilmemiş) — softmax çıktısı anlamlı bir sınıflandırma değil, sadece MİMARİNİN nasıl aktığını gösteriyor.
Bu 3 hatayı yaparsın:
- Her katmanın boyutu küçülttüğünü sanmak — sadece pooling (veya stride>1 konvolüsyon) boyutu küçültür.
- Kanal sayısı ile uzamsal boyutu karıştırmak — derinleştikçe biri artar, diğeri azalır.
- CNN’in “sihirli” olduğunu düşünmek — aslında sadece 25-29. derste gördüğümüz basit işlemlerin (konvolüsyon, ReLU, pooling, FC, softmax) sıralı bir zinciri.
Kendini test et
1. Notebook'ta Conv1+ReLU1'den sonra görüntü hâlâ 16×16 iken, Pool1'den sonra neden 8×8'e indi?
- Conv1 ve ReLU1 hatalıydı
- Konvolüsyon (same padding'le) ve ReLU boyutu DEĞİŞTİRMEZ -- boyutu küçülten katman SADECE pooling (doğru cevap)
- Her katman otomatik olarak boyutu yarıya indirir
- Girdi boyutu yanlış hesaplandı
Neden: Same padding'li konvolüsyon çıkış boyutunu girdiyle aynı tutar (28. ders); ReLU sadece değerleri değiştirir, şekli değil (8. ders); boyutu küçülten tek işlem MaxPool'dur (29. ders).
2. CNN derinleştikçe (girdiden çıktıya doğru ilerledikçe) uzamsal boyut ve kanal sayısı nasıl değişir?
- İkisi de artar
- Uzamsal boyut genelde KÜÇÜLÜR, kanal (özellik) sayısı genelde ARTAR -- "daha az yer, daha çok anlam" (doğru cevap)
- İkisi de sabit kalır
- Uzamsal boyut artar, kanal sayısı azalır
Neden: Notebook'ta girdi 16×16×1'den başlayıp Pool2 sonrası 4×4×8'e ulaştı -- uzamsal boyut küçülürken (16->8->4) kanal sayısı büyüdü (1->4->8), bu klasik CNN deseni.
3. Bu dersteki CNN'in softmax çıktısının rastgele (eğitilmemiş) ağırlıklarla üretilmiş olması ne anlama gelir?
- Softmax formülü yanlış uygulandı
- Çıktı, gerçek bir sınıflandırma DEĞİLDİR -- amaç, mimarinin katmanlarının nasıl ZİNCİRLENDİĞİNİ göstermektir; gerçek bir ağ bu ağırlıkları eğitimle öğrenir (doğru cevap)
- Model zaten mükemmel eğitilmiş
- Rastgele ağırlıklar hiçbir çıktı üretemez
Neden: Bu dersin amacı bir sınıflandırıcı EĞİTMEK değil, CNN mimarisinin BİLEŞENLERİNİN (konv, ReLU, pool, FC, softmax) nasıl bir araya geldiğini göstermektir -- gerçek bir uygulamada bu ağırlıklar veri üzerinde eğitilir.
Özet
Özet
- Tipik bir CNN, konvolüsyon+ReLU+pooling bloklarını tekrarlayıp sonunda tam bağlı katman+softmax ile biter.
- Konvolüsyon (same padding) ve ReLU boyutu değiştirmez; pooling boyutu küçültür.
- Derinleştikçe uzamsal boyut küçülür, kanal (özellik) sayısı artar.
- Erken katmanlar basit örüntüleri (kenar, doku), derin katmanlar soyut örüntüleri yakalar.
- Bu mimari iskelet, 31. derste göreceğimiz TÜM klasik CNN mimarilerinin (LeNet, ResNet) temelidir.