

Kayıp ve maliyet fonksiyonları
Önkoşul:Aktivasyon fonksiyonu özet kartı
Kanca
- derste “kayıp” kelimesini kullandık ama hiç durup “neden kareyi alıyoruz, neden bu spesifik formülü seçiyoruz” diye sormadık. Bu kısa derste, kayıp fonksiyonlarının ARKASINDAKİ tasarım kararlarını inceleyelim.
Sezgi
Kayıp (loss), TEK bir örnek için modelin ne kadar yanıldığını ölçer; maliyet (cost), TÜM veri setindeki kayıpların ORTALAMASIDIR. Bu terimler günlük konuşmada birbirinin yerine kullanılsa da, gradyan inişi (4. ML dersi) aslında MALİYETİ küçültmeye çalışır — tek bir örneğin kaybını değil.
Bir kayıp fonksiyonunun İYİ olması için iki şart var: (1) hatayı ANLAMLI ölçmeli, (2) türevi ALINABİLİR olmalı (gradyan inişi için şart).
Mekanizma
Kayıp ve maliyet arasındaki farkı somutlaştıralım:
Kayıp vs maliyet
# "Kayıp (loss)" TEK bir örnek için hata; "maliyet (cost)" TÜM veri setindeki ORTALAMA kayıp.
# Bu ikisi sık sık birbirinin yerine kullanılır ama teknik olarak farklıdır.
tahminler = np.array([2.1, 2.9, 5.2, 3.8])
gercekler = np.array([2.0, 3.0, 5.0, 4.0])

kayiplar = (tahminler - gercekler) ** 2  # her örnek için AYRI bir kayıp
maliyet = kayiplar.mean()  # TÜM veri setinin maliyeti

print("Örnek başına kayıp (her biri kendi hatası):")
for t, g, k in zip(tahminler, gercekler, kayiplar):
    print(f"  tahmin={t}, gerçek={g}, kayıp={k:.3f}")
print(f"\nMaliyet (tüm örneklerin ORTALAMASI): {maliyet:.4f}")
print("Gradyan inişi, MALİYETİ küçültmeye çalışır -- tek bir örneğin kaybını değil.")
Örnek başına kayıp (her biri kendi hatası):
tahmin=2.1, gerçek=2.0, kayıp=0.010
tahmin=2.9, gerçek=3.0, kayıp=0.010
tahmin=5.2, gerçek=5.0, kayıp=0.040
tahmin=3.8, gerçek=4.0, kayıp=0.040
Maliyet (tüm örneklerin ORTALAMASI): 0.0250
Gradyan inişi, MALİYETİ küçültmeye çalışır -- tek bir örneğin kaybını değil.Şimdi kritik bir soru: neden hatayı DOĞRUDAN değil, KARESİNİ alıyoruz?
Neden kare alıyoruz?
# Neden hatayı DOĞRUDAN (tahmin - gerçek) değil, KARESİNİ alıyoruz?
hata_dogrudan = (tahminler - gercekler).mean()
hata_mutlak = np.abs(tahminler - gercekler).mean()
hata_kare = ((tahminler - gercekler) ** 2).mean()
print(f"\nDoğrudan hata ortalaması: {hata_dogrudan:.4f}  -- pozitif ve negatif hatalar birbirini YOK ediyor!")
print(f"Mutlak hata ortalaması: {hata_mutlak:.4f}")
print(f"Kare hata ortalaması: {hata_kare:.4f}")
print("Doğrudan ortalama YANILTICI -- +0.1 ve -0.1 hatalar birbirini götürüp 'mükemmel' görünebilir.")
Doğrudan hata ortalaması: 0.0000  -- pozitif ve negatif hatalar birbirini YOK ediyor!
Mutlak hata ortalaması: 0.1500
Kare hata ortalaması: 0.0250
Doğrudan ortalama YANILTICI -- +0.1 ve -0.1 hatalar birbirini götürüp 'mükemmel' görünebilir.
Doğrudan hata ortalaması tam olarak 0.0000 çıktı — model “mükemmel” görünüyor! Ama gerçekte HİÇBİR tahmin tam doğru değildi (+0.1, -0.1, +0.2, -0.2 hataları). Çoğu kişi “ortalama hata, modelin ne kadar iyi olduğunu gösterir” sanır. Tehlikeli bir varsayım, çünkü pozitif ve negatif hatalar birbirini İPTAL edebilir — kare almak (veya mutlak değer almak), bu yanıltıcı iptali önler.
Matematik
Kayıp, maliyet ve türevlenebilirlik
| Özellik | Neden önemli |
|---|---|
| Türevlenebilirlik | Gradyan inişi, kaybın türevine ihtiyaç duyar — türevsiz bir fonksiyon optimize edilemez |
| Konvekslik (idealde) | Tek bir “vadi” varsa, gradyan inişi global minimumu güvenle bulur |
| Pozitiflik | Hataların birbirini iptal etmesini önler (kare veya mutlak değer bu yüzden kullanılır) |
Kod
Türevlenebilirliğin PyTorch’ta neden önemli olduğunu görelim:
Türevlenebilirlik ve autograd
# Kayıp fonksiyonunun DİĞER kritik özelliği: türevi alınabilir olmalı (gradyan inişi için).
def kare_kayip(tahmin, gercek):
    return (tahmin - gercek) ** 2

tahmin_torch = torch.tensor(2.1, requires_grad=True)
gercek_torch = torch.tensor(2.0)
kayip = kare_kayip(tahmin_torch, gercek_torch)
kayip.backward()
print(f"\nKare kayıp, tahmin=2.1 gerçek=2.0 için: {kayip.item():.4f}")
print(f"Gradyan (d(kayıp)/d(tahmin)): {tahmin_torch.grad.item():.4f}")
print("PyTorch bu gradyanı sorunsuz hesaplayabildi -- çünkü kare fonksiyonu HER YERDE türevlenebilir.")
Kare kayıp, tahmin=2.1 gerçek=2.0 için: 0.0100
Gradyan (d(kayıp)/d(tahmin)): 0.2000
PyTorch bu gradyanı sorunsuz hesaplayabildi -- çünkü kare fonksiyonu HER YERDE türevlenebilir.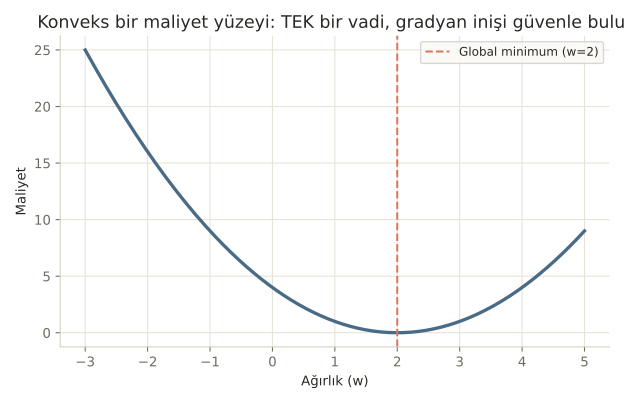
Nerede işe yarar
Kayıp fonksiyonu seçimi, bir modelin NE ÖĞRENDİĞİNİ doğrudan belirler:
- Sonraki iki derste (regresyon ve sınıflandırma kayıpları) detaylandıracağız. Farklı görevler, farklı kayıp fonksiyonları gerektirir.
- Kayıp fonksiyonu, modelin “neyi önemsediğini” tanımlar. Büyük hataları mı yoksa her hatayı eşit mi cezalandırmak istediğin, kayıp fonksiyonu seçiminle belirlenir (11. ML dersindeki MAE/MSE tartışmasını hatırla).
- PyTorch’ta
nn.MSELoss,nn.CrossEntropyLossgibi hazır fonksiyonlar. Kendi kayıp fonksiyonunu yazmak da mümkün, ama türevlenebilir olmasına dikkat etmek gerekir.
Bu 3 hatayı yaparsın:
- Model performansını DOĞRUDAN hata ortalamasıyla (kare almadan) ölçmek — bu derste gördüğümüz gibi yanıltıcı bir “mükemmellik” izlenimi verebilir.
- Türevlenemeyen bir kayıp fonksiyonu tasarlamak (örn. adım fonksiyonu içeren) — gradyan inişi bu fonksiyonu optimize edemez.
- “Kayıp” ve “maliyet”i her zaman aynı şey sanıp, hangisinin optimize edildiğini karıştırmak — pratikte fark genelde önemsiz olsa da, kavramsal netlik önemlidir.
Kendini test et
1. Notebook'ta doğrudan hata ortalaması (kare almadan) neden tam olarak 0.0000 çıktı?
- Model gerçekten mükemmeldi
- Pozitif hatalar (+0.1, +0.2) ile negatif hatalar (-0.1, -0.2) birbirini İPTAL ederek ortalamayı sıfırladı (doğru cevap)
- Kod hatalıydı
- Veri seti çok küçüktü
Neden: Hataların işaretleri (pozitif/negatif) doğrudan toplandığında birbirini götürebilir; bu, modelin gerçekte hiç hatasız OLMADIĞI halde ortalamanın sıfır çıkmasına yol açar.
2. Bir kayıp fonksiyonunun türevlenebilir olması neden şarttır?
- Sadece hesaplamayı hızlandırmak için
- Gradyan inişi (4. ML dersi), kaybın türevini kullanarak ağırlıkları günceller -- türevsiz bir fonksiyon bu süreçte kullanılamaz (doğru cevap)
- Türevlenebilirlik önemli değildir
- Sadece görselleştirme için gereklidir
Neden: Gradyan inişi, ağırlıkları güncellemek için kaybın gradyanına (türevine) ihtiyaç duyar; türevi tanımsız olan bir fonksiyon, bu optimizasyon sürecinde kullanılamaz.
3. "Kayıp" (loss) ile "maliyet" (cost) arasındaki fark nedir?
- Aralarında hiçbir fark yoktur
- Kayıp TEK bir örnek için hesaplanır; maliyet, TÜM veri setindeki kayıpların ORTALAMASIDIR (doğru cevap)
- Kayıp sadece sınıflandırmada, maliyet sadece regresyonda kullanılır
- Maliyet her zaman kayıptan küçüktür
Neden: Kayıp, tek bir örneğin hatasını ölçer; maliyet, tüm veri setindeki (veya bir grup örnekteki) kayıpların ortalamasıdır -- gradyan inişi maliyeti optimize eder.
Özet
Özet
- Kayıp, tek bir örnek için hatayı; maliyet, tüm veri setindeki ortalama kaybı ölçer.
- Hatayı doğrudan ortalamak yanıltıcıdır -- pozitif ve negatif hatalar birbirini iptal edebilir.
- Kare alma veya mutlak değer alma, bu iptali önler ve hatayı anlamlı şekilde ölçer.
- Bir kayıp fonksiyonu, gradyan inişiyle optimize edilebilmesi için TÜREVLENEBİLİR olmalıdır.
- Konveks (tek vadili) bir maliyet yüzeyinde, gradyan inişi global minimumu güvenle bulur.