

Perceptron
Kanca
Makine öğrenmesi kategorisinde onlarca algoritma gördük — ama hiçbiri “sinir ağı” değildi. Bu derste, tüm modern yapay zekânın (bu sitedeki her CNN, her transformer dahil) atası olan en basit yapı taşıyla başlıyoruz: tek bir yapay nöron.
Sezgi
Perceptron, girdileri ağırlıklandırıp toplayan ve bir eşiği geçip geçmediğine bakan en basit yapay nörondur. 1958’de Frank Rosenblatt tarafından tasarlandı ve kendi öğrenme kuralına sahipti: yanlış tahmin ettiğinde, ağırlıklarını hatanın yönünde küçük bir adım kaydırır.
Doğruluk: %100 -- kaydırıcıları ayarlayıp (veya düğmeye basıp) 4 noktayı da doğru sınıflandırmayı dene.
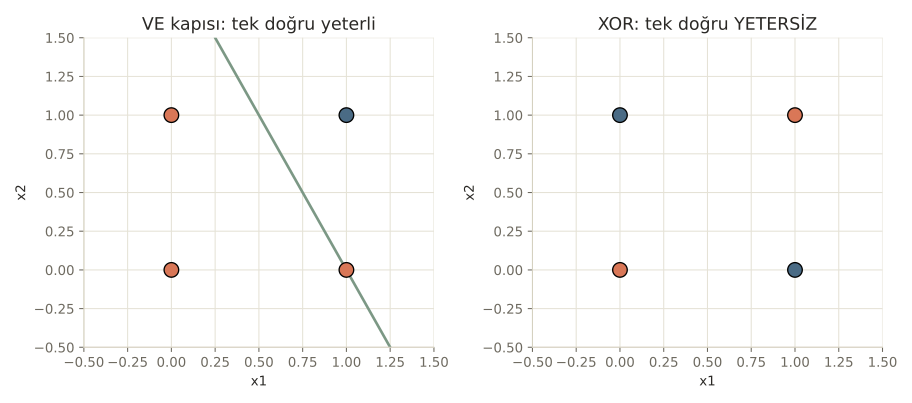
“VE kapısı” sekmesinde ağırlıkları (w1, w2) ve eşiği (b) ayarla — 4 noktayı ayıran bir doğru bulmak mümkün. Şimdi “XOR kapısı”na geç ve aynı şeyi dene: kaydırıcıları ne kadar oynatırsan oynat, kırmızı kenarlıklı (yanlış sınıflandırılmış) en az bir nokta HEP kalacak. Bu, 1969’da Minsky ve Papert’in perceptron’un ciddi bir sınırı olduğunu matematiksel olarak kanıtladığı, yapay zeka tarihinin dönüm noktalarından biri.
Mekanizma
Perceptron’un öğrenme kuralını gerçek bir örnekte görelim:
Perceptron öğrenme kuralı
# Perceptron öğrenme kuralı (Rosenblatt, 1958): yanlış tahmin edilen HER örnekte
# ağırlıkları, hatanın yönünde küçük bir adım kaydır. Gradyan inişi (4. ML dersi) DEĞİL --
# çok daha eski ve daha basit bir kural.
def perceptron_egit(X, y, ogrenme_orani=0.1, maks_tur=50):
    w = np.zeros(X.shape[1])
    b = 0.0
    gecmis_dogruluk = []
    for tur in range(maks_tur):
        hata_sayisi = 0
        for i in range(len(X)):
            tahmin = 1 if (X[i] @ w + b) >= 0 else 0
            hata = y[i] - tahmin
            if hata != 0:
                w += ogrenme_orani * hata * X[i]
                b += ogrenme_orani * hata
                hata_sayisi += 1
        tahminler = ((X @ w + b) >= 0).astype(int)
        dogruluk = (tahminler == y).mean()
        gecmis_dogruluk.append(dogruluk)
        if hata_sayisi == 0:
            break
    return w, b, gecmis_dogruluk
Bu blok yazdırılan bir çıktı üretmiyor.
VE kapısını öğrenmek
# VE (AND) mantık kapısı: sadece HER İKİ giriş de 1 ise çıktı 1.
X_ve = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
y_ve = np.array([0, 0, 0, 1])

w_ve, b_ve, dogruluk_ve = perceptron_egit(X_ve, y_ve)
print(f"VE kapısı -- {len(dogruluk_ve)} turda yakınsadı")
print(f"Bulunan ağırlıklar: w={w_ve.round(2)}, b={b_ve:.2f}")
print(f"Son doğruluk: {dogruluk_ve[-1]:.2f}")
for x, hedef in zip(X_ve, y_ve):
    tahmin = 1 if (x @ w_ve + b_ve) >= 0 else 0
    print(f"  giriş={x.astype(int)}  hedef={hedef}  tahmin={tahmin}")
VE kapısı -- 4 turda yakınsadı
Bulunan ağırlıklar: w=[0.2 0.1], b=-0.20
Son doğruluk: 1.00
giriş=[0 0] hedef=0 tahmin=0
giriş=[0 1] hedef=0 tahmin=0
giriş=[1 0] hedef=0 tahmin=0
giriş=[1 1] hedef=1 tahmin=1Sadece 4 turda, 4 örneğin hepsini doğru sınıflandıran ağırlıkları buluyor. Şimdi aynı algoritmayı XOR’a uygulayalım:
XOR kapısında perceptron
# XOR: girişler FARKLIYSA çıktı 1. Perceptron'un tarihi sınırını burada göreceğiz.
X_xor = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
y_xor = np.array([0, 1, 1, 0])

w_xor, b_xor, dogruluk_xor = perceptron_egit(X_xor, y_xor, maks_tur=200)
print(f"\nXOR kapısı -- {len(dogruluk_xor)} tur sonunda hâlâ yakınsamadı (maks_tur sınırına çarptı)")
print(f"Son 10 turun doğruluğu: {[round(float(d), 2) for d in dogruluk_xor[-10:]]}")
print("Doğruluk asla %100'e ulaşmıyor -- sürekli 0.5 ile 0.75 arasında SALINIYOR, hiç durmuyor.")
XOR kapısı -- 200 tur sonunda hâlâ yakınsamadı (maks_tur sınırına çarptı)
Son 10 turun doğruluğu: [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5]
Doğruluk asla %100'e ulaşmıyor -- sürekli 0.5 ile 0.75 arasında SALINIYOR, hiç durmuyor.
200 tur boyunca eğitilmesine rağmen doğruluk asla %100’e ulaşmıyor — son 10 turda sabit %50’de SALINIYOR. Çoğu kişi “daha uzun eğitirsek ya da öğrenme oranını değiştirirsek sonunda öğrenir” sanır. Yanlış, çünkü bu bir eğitim sorunu değil, GEOMETRİK bir imkansızlık.
Matematik
Perceptron'un karar kuralı
| Sembol | Anlamı |
|---|---|
| Her girdinin ne kadar “önemli” olduğunu belirleyen ağırlıklar | |
| Bias — karar sınırını kaydıran sabit terim | |
| Karar SINIRI — 2 boyutta bu her zaman bir DOĞRUDUR |
Perceptron’un çıktısı, girdilerin DOĞRUSAL bir kombinasyonuna dayanır — bu yüzden karar sınırı her zaman düz bir çizgi (veya yüksek boyutta bir düzlem) olmak zorundadır. XOR’un 4 noktası, hiçbir düz çizgiyle tam olarak ayrılamayacak şekilde dizilmiştir.
Kod
Bu imkansızlığı, rastgele binlerce doğru deneyerek doğrulayalım:
Rastgele arama ile üst sınırı bulmak
# Rastgele yüzlerce (w, b) deneyip XOR'da en iyi ne kadar doğruluk elde edilebildiğine bakalım.
en_iyi_dogruluk = 0
for _ in range(2000):
    w_deneme = rng.uniform(-3, 3, 2)
    b_deneme = rng.uniform(-3, 3)
    tahminler = ((X_xor @ w_deneme + b_deneme) >= 0).astype(int)
    dogruluk = (tahminler == y_xor).mean()
    en_iyi_dogruluk = max(en_iyi_dogruluk, dogruluk)
print(f"\n2000 rastgele (w, b) denemesinden en iyi doğruluk: {en_iyi_dogruluk:.2f}")
print("TEK bir doğru, XOR'un 4 noktasının EN FAZLA 3 tanesini doğru ayırabilir -- matematiksel bir imkansızlık,")
print("daha iyi bir öğrenme kuralı veya daha uzun eğitimle çözülecek bir sorun DEĞİL.")
2000 rastgele (w, b) denemesinden en iyi doğruluk: 0.75
TEK bir doğru, XOR'un 4 noktasının EN FAZLA 3 tanesini doğru ayırabilir -- matematiksel bir imkansızlık,
daha iyi bir öğrenme kuralı veya daha uzun eğitimle çözülecek bir sorun DEĞİL.
2000 rastgele denemenin EN İYİSİ bile %75’i (4 noktadan 3’ü) geçemiyor. Bu, daha iyi bir öğrenme kuralı veya daha uzun eğitimle asla aşılamayacak matematiksel bir tavan.
Nerede işe yarar
Perceptron’un tarihi önemi, bugünkü pratik kullanımından daha büyüktür:
- Sinir ağlarının kavramsal temeli. Her modern sinir ağı katmanı, aslında birçok perceptron benzeri birimin bir araya gelmesidir.
- Doğrusal ayrılabilirliğin sınırlarını anlamak. Bir problemin ne zaman TEK katmanlı bir modelle çözülemeyeceğini erken fark etmek.
- “Neden derin öğrenme?” sorusunun cevabı. XOR problemi, sonraki derste göreceğimiz ÇOK KATMANLI ağların neden gerekli olduğunun tarihi motivasyonudur.
Bu 3 hatayı yaparsın:
- XOR başarısızlığını bir “hata” veya “eksik eğitim” sanıp daha fazla tur denemek — bu derste gördüğümüz gibi, sorun matematikseldir, eğitim süresiyle çözülmez.
- Perceptron’un modern sinir ağlarıyla AYNI şey olduğunu düşünmek — perceptron’un öğrenme kuralı, gradyan inişinden (bir sonraki bölümde göreceğiz) farklıdır ve tek bir katmanla sınırlıdır.
- “Doğrusal ayrılabilirlik” kavramını sadece 2 boyutta düşünmek — yüksek boyutlarda da aynı fikir geçerlidir: karar sınırı her zaman düz bir HİPERDÜZLEM olur.
Kendini test et
1. Perceptron, bir girdiyi nasıl sınıflandırır?
- Rastgele bir sınıf atar
- Girdilerin ağırlıklı toplamını hesaplayıp bir eşiği (genelde 0) geçip geçmediğine bakar (doğru cevap)
- En yakın komşuya bakar
- Bir karar ağacı kurar
Neden: Perceptron, w1*x1 + w2*x2 + b değerini hesaplar; bu değer 0 veya üzerindeyse 1, altındaysa 0 tahmin eder.
2. Notebook'ta perceptron neden XOR'u hiçbir zaman %100 doğrulukla öğrenemedi?
- Öğrenme oranı yanlış seçilmişti
- XOR'un 4 noktası, doğrusal olarak ayrılabilir DEĞİL -- tek bir doğru bu noktaların hepsini asla doğru ayıramaz (doğru cevap)
- Yeterince uzun eğitilmedi
- Veri seti çok küçüktü
Neden: XOR'un 4 noktası, sınıfların çapraz köşegenlerde yer aldığı bir düzende dizilmiştir -- bu geometrik yapı hiçbir tek doğruyla tam olarak ayrılamaz, eğitim süresi bunu değiştirmez.
3. 2000 rastgele (w, b) denemesinden en iyi doğruluk neden tam olarak %75 çıktı?
- Tesadüf
- XOR'un 4 noktasından en fazla 3'ü tek bir doğruyla aynı tarafta doğru gruplanabilir -- 4. nokta her zaman yanlış kalır (doğru cevap)
- Rastgele arama hatalıydı
- Öğrenme oranı çok düşüktü
Neden: XOR'un geometrik yapısı gereği, herhangi bir doğru en fazla 3 noktayı doğru sınıflandırabilir -- 4. nokta kaçınılmaz olarak yanlış tarafta kalır, bu da %75'lik (3/4) tavanı açıklar.
Özet
Özet
- Perceptron, girdilerin ağırlıklı toplamını bir eşikle karşılaştıran en basit yapay nörondur.
- Kendi öğrenme kuralı vardır: yanlış tahminde ağırlıkları hatanın yönünde küçük adımlarla günceller.
- Karar sınırı her zaman doğrusaldır (düz bir çizgi veya hiperdüzlem).
- XOR gibi doğrusal olarak ayrılamayan problemler, tek bir perceptron ile ASLA tam doğrulukla çözülemez.
- Bu sınırlama, çok katmanlı sinir ağlarının (bir sonraki ders) neden gerekli olduğunun tarihi motivasyonudur.