

Regresyon kayıp fonksiyonları
Önkoşul:Kayıp ve maliyet fonksiyonları
Kanca
- derste “neden kare alıyoruz” sorusuna genel bir cevap verdik. Ama regresyonda kare almanın da bir bedeli var: tek bir kötü tahmin, TÜM eğitim sürecini domine edebilir. Bu derste MSE, MAE ve Huber’i aynı veri üzerinde karşılaştırıp, bu üç kayıp fonksiyonunun bir aykırı değere ne kadar FARKLI tepki verdiğini görelim.
Sezgi
5 ev fiyatı tahmin eden bir model düşün. 4 tahmin gayet iyi, ama 1 tanesi (belki veri hatası, belki gerçekten sıra dışı bir ev) çok yanlış. Bu TEK aykırı tahmin, modelin toplam kaybını ne kadar etkilemeli?
3. evin tahmini gerçek değerden 0.2 uzaklaştıkça MSE en hızlı büyüyen, MAE en ölçülü kalan kayıp oluyor. Şu an aykırı değer yok -- üçü de birbirine yakın küçük değerler veriyor.
- evin tahminini kaydırıcıyla değiştir (gerçek değer 5.0). Tahmin gerçeğe yakın kaldıkça üç çubuk da birbirine yakın; ama tahmini 15-20’ye çektiğinde MSE çubuğu diğerlerini gölgede bırakacak kadar büyüyor.
Mekanizma
Aynı senaryoyu notebook’ta sayısal olarak inceleyelim: önce aykırı değer YOKKEN üç kaybı hesaplayalım.
Temiz veride MSE/MAE/Huber
# 5 ev fiyatı tahmini (milyon TL), model gerçeğe YAKIN tahminler üretiyor.
gercekler = np.array([3.0, 4.0, 5.0, 6.0, 7.0])
tahminler_iyi = np.array([3.1, 3.9, 5.2, 5.8, 7.1])

print("Temiz veri (aykırı değer YOK):")
print(f"  MSE   = {mse(gercekler, tahminler_iyi):.4f}")
print(f"  MAE   = {mae(gercekler, tahminler_iyi):.4f}")
print(f"  Huber = {huber(gercekler, tahminler_iyi):.4f}")
print("Üç kayıp fonksiyonu da birbirine yakın küçük değerler veriyor -- normal.")
Temiz veri (aykırı değer YOK):
MSE = 0.0220
MAE = 0.1400
Huber = 0.0110
Üç kayıp fonksiyonu da birbirine yakın küçük değerler veriyor -- normal.Şimdi TEK bir tahmine büyük bir hata ekleyelim (3. ev için 15.0 tahmin edildi, gerçek değer 5.0 idi):
Aykırı değer eklenince ne olur?
# Şimdi TEK bir tahmine büyük bir hata ekleyelim (3. ev için 15.0 tahmin edildi, gerçek 5.0).
tahminler_aykiri = tahminler_iyi.copy()
tahminler_aykiri[2] = 15.0  # gerçek hedef 5.0 idi

mse_iyi, mse_aykiri = mse(gercekler, tahminler_iyi), mse(gercekler, tahminler_aykiri)
mae_iyi, mae_aykiri = mae(gercekler, tahminler_iyi), mae(gercekler, tahminler_aykiri)
huber_iyi, huber_aykiri = huber(gercekler, tahminler_iyi), huber(gercekler, tahminler_aykiri)

print(f"\n{'Kayıp':<8} {'Temiz veri':<12} {'Aykırı VAR':<12} {'Kaç kat arttı':<14}")
print(f"{'MSE':<8} {mse_iyi:<12.4f} {mse_aykiri:<12.4f} {mse_aykiri / mse_iyi:<14.1f}")
print(f"{'MAE':<8} {mae_iyi:<12.4f} {mae_aykiri:<12.4f} {mae_aykiri / mae_iyi:<14.1f}")
print(f"{'Huber':<8} {huber_iyi:<12.4f} {huber_aykiri:<12.4f} {huber_aykiri / huber_iyi:<14.1f}")
print("\nMSE, TEK bir aykırı değerle bile onlarca kat büyüyor -- çünkü hatayı KARESİYLE cezalandırıyor.")
print("MAE çok daha ölçülü tepki veriyor -- hatayı DOĞRUSAL cezalandırıyor.")
print("Huber ikisi arasında: küçük hatalarda MSE gibi (pürüzsüz), büyük hatalarda MAE gibi (ölçülü) davranıyor.")
Kayıp    Temiz veri   Aykırı VAR   Kaç kat arttı
MSE      0.0220       20.0140      909.7
MAE      0.1400       2.1000       15.0
Huber    0.0110       1.9070       173.4

MSE, TEK bir aykırı değerle bile onlarca kat büyüyor -- çünkü hatayı KARESİYLE cezalandırıyor.
MAE çok daha ölçülü tepki veriyor -- hatayı DOĞRUSAL cezalandırıyor.
Huber ikisi arasında: küçük hatalarda MSE gibi (pürüzsüz), büyük hatalarda MAE gibi (ölçülü) davranıyor.
MSE, aykırı değerle birlikte 909.7 kat büyüdü. MAE sadece 15 kat, Huber ise 173.4 kat büyüdü. Çoğu kişi “kayıp fonksiyonu seçimi teknik bir detay” sanır. Yanlış, çünkü MSE kullanan bir model, eğitim sırasında bu TEK aykırı örneği düzeltmeye o kadar çok odaklanır ki, diğer 4 iyi tahmini bozabilir.
Matematik
Üç kayıp fonksiyonunun formülleri
| Kayıp | Küçük hatalarda | Büyük hatalarda | Aykırı değere dayanıklılık |
|---|---|---|---|
| MSE | Pürüzsüz, hassas | Karesel büyür | Düşük — aykırı değerlere çok duyarlı |
| MAE | Doğrusal | Doğrusal büyür | Yüksek — her hatayı eşit cezalandırır |
| Huber | MSE gibi (pürüzsüz) | MAE gibi (doğrusal) | Orta — delta parametresiyle ayarlanabilir |
Kod
PyTorch’un hazır kayıp fonksiyonlarıyla çapraz kontrol edip, delta parametresinin Huber’i nasıl değiştirdiğine bakalım:
PyTorch ile doğrulama
# PyTorch'un hazır kayıp fonksiyonlarıyla (nn.MSELoss, nn.L1Loss, nn.HuberLoss) çapraz kontrol.
y_torch = torch.tensor(gercekler, dtype=torch.float32)
yhat_torch = torch.tensor(tahminler_aykiri, dtype=torch.float32)

mse_fn, mae_fn, huber_fn = nn.MSELoss(), nn.L1Loss(), nn.HuberLoss(delta=1.0)
print(f"\nPyTorch (aykırı veri): MSE={mse_fn(yhat_torch, y_torch).item():.4f}, "
      f"MAE={mae_fn(yhat_torch, y_torch).item():.4f}, Huber={huber_fn(yhat_torch, y_torch).item():.4f}")
print("Elle hesapladığımız değerlerle BİREBİR aynı -- PyTorch'un formülleri bizimkiyle tutarlı.")
PyTorch (aykırı veri): MSE=20.0140, MAE=2.1000, Huber=1.9070
Elle hesapladığımız değerlerle BİREBİR aynı -- PyTorch'un formülleri bizimkiyle tutarlı.
Delta parametresinin etkisi
# Huber'in "delta" parametresi, MSE ile MAE arasındaki geçiş noktasını belirler.
for delta_test in [0.1, 0.5, 1.0, 3.0, 10.0]:
    h = huber(gercekler, tahminler_aykiri, delta=delta_test)
    print(f"  delta={delta_test:<5} -> Huber={h:.4f}")
print("\ndelta küçüldükçe Huber, MAE'ye (aykırı değere daha dayanıklı) yaklaşır.")
print("delta büyüdükçe Huber, MSE'ye (büyük hataları daha ağır cezalandıran) yaklaşır.")
delta=0.1 -> Huber=0.2050
delta=0.5 -> Huber=0.9820
delta=1.0 -> Huber=1.9070
delta=3.0 -> Huber=5.1070
delta=10.0 -> Huber=10.0070
delta küçüldükçe Huber, MAE'ye (aykırı değere daha dayanıklı) yaklaşır.
delta büyüdükçe Huber, MSE'ye (büyük hataları daha ağır cezalandıran) yaklaşır.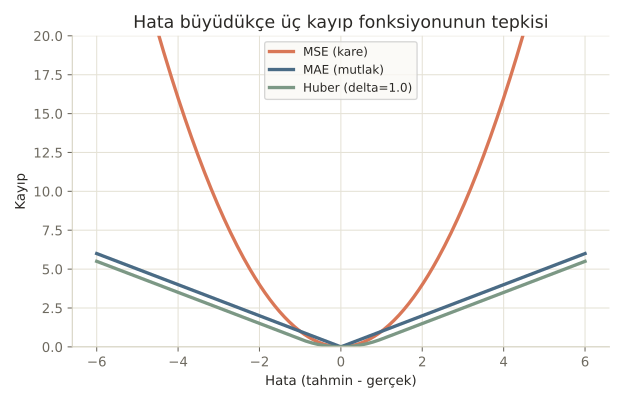
Nerede işe yarar
Hangi kaybı ne zaman seçmeli:
- Verinde aykırı değer (outlier) riski düşükse → MSE. Pürüzsüz gradyanı sayesinde optimizasyon genelde daha kararlı.
- Verinde aykırı değer riski yüksekse (ölçüm hataları, nadir uç durumlar) → MAE veya Huber. Tek bir kötü örneğin eğitimi domine etmesini önler.
- İkisinin dengesini istiyorsan → Huber, delta’yı verinin tipik hata büyüklüğüne göre ayarla. Küçük delta → MAE’ye yakın; büyük delta → MSE’ye yakın.
Bu 3 hatayı yaparsın:
- Verinde bilinen aykırı değerler varken körü körüne MSE kullanmak — model, o birkaç örneği düzeltmeye aşırı odaklanıp genel performansı düşürebilir.
- Huber’in delta parametresini hiç ayarlamadan varsayılan (genelde 1.0) bırakmak — verinin ölçeğine göre bu değer çok küçük veya çok büyük olabilir.
- “Kayıp küçük çıktı, model iyi” diye düşünüp hangi kayıp fonksiyonunun kullanıldığını göz ardı etmek — MAE=2.1 ile MSE=2.1 aynı “iyilik” seviyesini göstermez, birimleri farklıdır.
Kendini test et
1. Notebook'ta tek bir aykırı tahmin eklendiğinde MSE neden MAE'den çok daha fazla büyüdü (909.7 kat vs 15 kat)?
- MSE hesaplama hatası içeriyor
- MSE hatayı KARESİYLE cezalandırır, bu yüzden büyük bir hata orantısız şekilde büyür; MAE hatayı DOĞRUSAL cezalandırır (doğru cevap)
- MAE her zaman MSE'den büyük çıkar
- Aralarında fark yoktur, tesadüf
Neden: MSE'de hata karesi alındığı için (ör. hata=10 iken kare=100) büyük hatalar orantısız şekilde kayba katkı yapar; MAE'de hata doğrudan (mutlak değeriyle) kayba eklenir, bu yüzden tepkisi çok daha ölçülüdür.
2. Huber kaybının delta parametresi ne işe yarar?
- Öğrenme oranını belirler
- MSE (pürüzsüz, küçük hatalarda) ile MAE (doğrusal, büyük hatalarda) davranışları arasındaki geçiş noktasını belirler (doğru cevap)
- Sadece görselleştirme içindir, hesaplamayı etkilemez
- Veri setinin boyutunu belirler
Neden: Hata, delta'dan küçükse Huber MSE gibi (kare) davranır; delta'dan büyükse MAE gibi (doğrusal) davranır -- delta, bu iki davranış arasındaki eşik değeridir.
3. Verinde ölçüm hatalarından kaynaklanan bilinen aykırı değerler varsa hangi kayıp fonksiyonu genelde daha güvenli bir seçimdir?
- MSE, çünkü daha popüler
- MAE veya Huber, çünkü aykırı değerlere karşı daha dayanıklıdır (doğru cevap)
- Hiçbiri fark etmez
- Sadece sınıflandırma kayıpları kullanılmalı
Neden: MAE (ve uygun delta ile Huber), tek bir aykırı örneğin toplam kaybı ve dolayısıyla eğitim sürecini domine etmesini MSE'ye göre çok daha az riske sokar.
Özet
Özet
- MSE hatayı karesiyle, MAE hatayı doğrusal, Huber ikisinin karışımıyla cezalandırır.
- Tek bir aykırı değer MSE'yi MAE'den çok daha fazla büyütür -- MSE aykırı değerlere daha duyarlıdır.
- Huber'in delta parametresi, MSE-benzeri ve MAE-benzeri davranış arasındaki geçiş noktasını kontrol eder.
- Kayıp fonksiyonu seçimi, verinin aykırı değer riskine göre yapılmalı -- teknik bir detay değil, tasarım kararıdır.
- Kayıp değerlerinin mutlak büyüklüğü, hangi fonksiyonun kullanıldığına bağlıdır -- MAE ve MSE değerleri doğrudan karşılaştırılamaz.