

Sınıflandırma kayıp fonksiyonları
Önkoşul:Regresyon kayıp fonksiyonları
Kanca
- derste regresyon (sürekli sayı) tahminleri için MSE/MAE/Huber’i karşılaştırdık. Peki model bir OLASILIK tahmin ediyorsa (9. ders: softmax, 6. ders: sigmoid) hangi kayıp fonksiyonu kullanılmalı? Cevap MSE değil — cross-entropy (çapraz entropi).
Sezgi
Cross-entropy, modelin doğru sınıfa verdiği olasılığın LOGARİTMASINI (eksi işaretiyle) alır. Model doğru sınıfa yüksek olasılık verirse kayıp küçük; düşük olasılık verirse kayıp BÜYÜK — ve bu büyüme doğrusal değil, logaritmik.
Bunu somutlaştıralım: bir spam filtresi düşün. Gerçekten spam olan bir e-postaya model ne kadar düşük olasılık verirse (yani ne kadar “emin yanlış” olursa), kayıp ne kadar artar?
Mekanizma
Doğru yönde emin olmak vs yanlış yönde emin olmak
# Gerçek sınıf y=1 (örnek gerçekten "spam"). Model üç farklı olasılık üretiyor.
y_gercek = 1
for p_tahmin in [0.51, 0.9, 0.99, 0.999]:
    kayip = ikili_capraz_entropi(np.array([y_gercek]), np.array([p_tahmin]))
    print(f"  p={p_tahmin:<6} (doğru yönde) -> kayıp={kayip:.4f}")

print()
for p_tahmin in [0.49, 0.1, 0.01, 0.001]:
    kayip = ikili_capraz_entropi(np.array([y_gercek]), np.array([p_tahmin]))
    print(f"  p={p_tahmin:<6} (YANLIŞ yönde) -> kayıp={kayip:.4f}")

print("\nModel YANLIŞ yönde ne kadar 'emin' olursa (p küçüldükçe), kayıp SONSUZA yaklaşıyor.")
print("Doğru yönde emin olmak neredeyse ödülsüz (kayıp ~0'a iniyor) ama yanlış yönde emin olmak ağır cezalandırılıyor.")
p=0.51 (doğru yönde) -> kayıp=0.6733
p=0.9 (doğru yönde) -> kayıp=0.1054
p=0.99 (doğru yönde) -> kayıp=0.0101
p=0.999 (doğru yönde) -> kayıp=0.0010
p=0.49 (YANLIŞ yönde) -> kayıp=0.7133
p=0.1 (YANLIŞ yönde) -> kayıp=2.3026
p=0.01 (YANLIŞ yönde) -> kayıp=4.6052
p=0.001 (YANLIŞ yönde) -> kayıp=6.9078
Model YANLIŞ yönde ne kadar 'emin' olursa (p küçüldükçe), kayıp SONSUZA yaklaşıyor.
Doğru yönde emin olmak neredeyse ödülsüz (kayıp ~0'a iniyor) ama yanlış yönde emin olmak ağır cezalandırılıyor.p=0.001’e (yanlış yönde neredeyse tam emin) kadar düşürdüğümüzde kayıp 6.9078’e fırlıyor — p=0.999 (doğru yönde emin) iken kayıp sadece 0.0010. Şimdi bunu MSE ile karşılaştıralım:
Cross-entropy vs MSE
# Aynı senaryoyu MSE ile karşılaştıralım -- neden sınıflandırmada cross-entropy tercih edilir?
def kare_kayip(y, p):
    return np.mean((y - p) ** 2)

print(f"\n{'p (yanlış yönde)':<20} {'Cross-entropy':<16} {'MSE':<10}")
for p_tahmin in [0.5, 0.1, 0.01, 0.001]:
    ce = ikili_capraz_entropi(np.array([y_gercek]), np.array([p_tahmin]))
    mse_ = kare_kayip(np.array([y_gercek]), np.array([p_tahmin]))
    print(f"{p_tahmin:<20} {ce:<16.4f} {mse_:<10.4f}")

print("\nMSE, p küçüldükçe en fazla 1.0'a yaklaşıyor (sınırlı) -- cross-entropy ise SINIRSIZ büyüyor.")
print("Bu fark, gradyanda da görünüyor: MSE + sigmoid kombinasyonu, çok yanlış tahminlerde bile KÜÇÜK gradyan üretebilir (5. ders: kaybolan gradyan).")
p (yanlış yönde)     Cross-entropy    MSE
0.5                  0.6931           0.2500
0.1                  2.3026           0.8100
0.01                 4.6052           0.9801
0.001                6.9078           0.9980

MSE, p küçüldükçe en fazla 1.0'a yaklaşıyor (sınırlı) -- cross-entropy ise SINIRSIZ büyüyor.
Bu fark, gradyanda da görünüyor: MSE + sigmoid kombinasyonu, çok yanlış tahminlerde bile KÜÇÜK gradyan üretebilir (5. ders: kaybolan gradyan).
Çoğu kişi “ikisi de hatayı ölçüyor, hangisi kullanılırsa kullanılsın sonuç benzer olur” sanır. Yanlış, çünkü MSE en fazla 1.0’a yaklaşabilirken (sınırlı), cross-entropy sınırsız büyüyebilir — bu da GRADYANLARINI çok farklı yapar.
Matematik
Binary ve kategorik cross-entropy
| Sembol | Anlamı |
|---|---|
| Gerçek etiket (0 veya 1, ikili sınıflandırmada) | |
| Modelin tahmin ettiği olasılık (sigmoid çıktısı) | |
| Softmax çıktısında, gerçek sınıfa karşılık gelen olasılık |
BCE’de sadece ‘ye karşılık gelen terim hayatta kalır — ise , ise . Kategorik versiyon da aynı mantığı çok sınıfa genişletir: sadece doğru sınıfın olasılığı önemlidir.
Kod
Bu farkın gradyanlara nasıl yansıdığını PyTorch autograd ile ölçelim:
Gradyan karşılaştırması: BCE vs MSE
# PyTorch autograd ile, aynı çok-yanlış tahminde iki kaybın gradyanını karşılaştıralım.
z = torch.tensor(-5.0, requires_grad=True)  # çok negatif bir logit -- model "spam değil" diyor ama gerçek spam
p = torch.sigmoid(z)
y = torch.tensor(1.0)

bce = nn.functional.binary_cross_entropy(p, y)
bce.backward()
grad_bce = z.grad.item()

z2 = torch.tensor(-5.0, requires_grad=True)
p2 = torch.sigmoid(z2)
mse_kayip = (p2 - y) ** 2
mse_kayip.backward()
grad_mse = z2.grad.item()

print(f"\nz=-5.0 (çok yanlış tahmin) için d(kayıp)/dz:")
print(f"  Binary cross-entropy: {grad_bce:.5f}  (BÜYÜK -- ağırlıklar hızla düzelir)")
print(f"  MSE (sigmoid çıktıyla): {grad_mse:.5f}  (küçük -- sigmoid doygunluğu gradyanı boğuyor)")
print("Cross-entropy'nin gradyanı, sigmoid'in türevini SADELEŞTİRDİĞİ için doygunluktan etkilenmiyor.")
z=-5.0 (çok yanlış tahmin) için d(kayıp)/dz:
  Binary cross-entropy: -0.99331  (BÜYÜK -- ağırlıklar hızla düzelir)
  MSE (sigmoid çıktıyla): -0.01321  (küçük -- sigmoid doygunluğu gradyanı boğuyor)
Cross-entropy'nin gradyanı, sigmoid'in türevini SADELEŞTİRDİĞİ için doygunluktan etkilenmiyor.
Çok yanlış bir tahminde (z=-5.0) cross-entropy’nin gradyanı -0.99331 iken MSE+sigmoid’inki sadece -0.01321 — MSE, 6. derste gördüğümüz sigmoid doygunluğuna takılıp gradyanı boğuyor. Cross-entropy’nin formülü, sigmoid’in türevini matematiksel olarak SADELEŞTİRDİĞİ için bu tuzağa düşmüyor.
Çok sınıflı: kategorik cross-entropy
# Çok sınıflı (softmax + kategorik cross-entropy) versiyonu.
def kategorik_capraz_entropi(y_indeksi, olasiliklar, eps=1e-12):
    return -np.log(np.clip(olasiliklar[y_indeksi], eps, 1))

olasiliklar_iyi = np.array([0.7, 0.2, 0.1])   # model doğru sınıfa (0) yüksek olasılık verdi
olasiliklar_kotu = np.array([0.1, 0.2, 0.7])  # model doğru sınıfa (0) düşük olasılık verdi
gercek_sinif = 0

print(f"\nGerçek sınıf: {gercek_sinif}")
print(f"  İyi tahmin {olasiliklar_iyi} -> kayıp={kategorik_capraz_entropi(gercek_sinif, olasiliklar_iyi):.4f}")
print(f"  Kötü tahmin {olasiliklar_kotu} -> kayıp={kategorik_capraz_entropi(gercek_sinif, olasiliklar_kotu):.4f}")

# PyTorch nn.CrossEntropyLoss ile doğrulama (ham logit alır, kendi içinde softmax uygular)
logitler = torch.tensor([[2.0, 0.5, -0.5]])  # olasiliklar_iyi'ye yakın bir dağılım üretir
hedef = torch.tensor([0])
ce_fn = nn.CrossEntropyLoss()
print(f"\nPyTorch CrossEntropyLoss (ham logit'lerden): {ce_fn(logitler, hedef).item():.4f}")
Gerçek sınıf: 0
  İyi tahmin [0.7 0.2 0.1] -> kayıp=0.3567
  Kötü tahmin [0.1 0.2 0.7] -> kayıp=2.3026

PyTorch CrossEntropyLoss (ham logit'lerden): 0.2664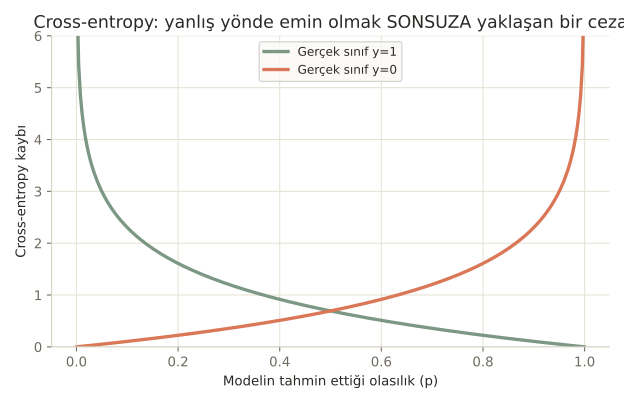
Nerede işe yarar
Cross-entropy, sınıflandırma görevlerinin standart kaybıdır:
- İkili sınıflandırma (sigmoid çıktı) → binary cross-entropy. PyTorch’ta
nn.BCELoss(olasılık girdisi) veyann.BCEWithLogitsLoss(ham logit girdisi, sayısal olarak daha kararlı). - Çok sınıflı sınıflandırma (softmax çıktı) → kategorik cross-entropy. PyTorch’ta
nn.CrossEntropyLoss, ham logit’leri alır ve içeride softmax’ı kendisi uygular. - Regresyona cross-entropy, sınıflandırmaya MSE koymak → ikisi de yanlış. 12. dersteki MSE/MAE/Huber sürekli değerler için; cross-entropy olasılık/sınıf tahminleri için tasarlanmıştır.
Bu 3 hatayı yaparsın:
nn.CrossEntropyLoss’a softmax UYGULANMIŞ olasılıkları vermek — bu fonksiyon softmax’ı kendi içinde uygular, ham logit beklenir; iki kere softmax uygulamak yanlış sonuç verir.- Sınıflandırma modelinde MSE kullanmak — bu derste gördüğümüz gibi, çok yanlış tahminlerde gradyan sönümlenebilir ve eğitim yavaşlar.
- Cross-entropy’nin p=0 veya p=1 sınırlarında nedeniyle patlayabileceğini unutup epsilon ile kırpma (clipping) yapmamak.
Kendini test et
1. Gerçek sınıf y=1 iken model p=0.001 (yanlış yönde neredeyse tam emin) tahmin ederse cross-entropy kaybı neden çok büyük çıkar?
- Kod hatası nedeniyle
- -log(p) fonksiyonu p sıfıra yaklaştıkça SONSUZA yaklaşır -- model yanlış yönde ne kadar emin olursa ceza o kadar ağırlaşır (doğru cevap)
- Her zaman sabit bir kayıp döner
- p=0.001 aslında doğru bir tahmindir
Neden: Cross-entropy formülündeki -log(p) terimi, p sıfıra yaklaştıkça matematiksel olarak sonsuza ıraksar; bu, "yanlış yönde emin olmayı" ağır şekilde cezalandırır.
2. Notebook'ta z=-5.0 (çok yanlış logit) için cross-entropy'nin gradyanı (-0.993) neden MSE+sigmoid'in gradyanından (-0.013) çok daha büyük çıktı?
- Rastgele bir sonuç, tekrarlanabilir değil
- Cross-entropy'nin formülü sigmoid'in türevini matematiksel olarak sadeleştirir, bu yüzden sigmoid doygunluğundan etkilenmez; MSE ise doygunluğa takılıp gradyanı boğar (doğru cevap)
- MSE her zaman daha büyük gradyan üretir
- z değeri hesaplamayı etkilemez
Neden: Cross-entropy'nin gradyan formülünde sigmoid'in türevi (p(1-p) terimi) matematiksel olarak sadeleşir; MSE'de bu sadeleşme olmadığı için sigmoid'in doygunluk bölgesindeki küçük türevi doğrudan gradyana yansır ve onu küçültür.
3. PyTorch'ta nn.CrossEntropyLoss fonksiyonuna hangi girdi verilmelidir?
- Softmax uygulanmış olasılıklar
- Ham logit'ler -- fonksiyon softmax'ı kendi içinde uygular (doğru cevap)
- Sadece 0 ve 1 değerleri
- Sigmoid uygulanmış değerler
Neden: nn.CrossEntropyLoss, sayısal kararlılık için softmax'ı kendi içinde uygular; softmax uygulanmış olasılıkları vermek, softmax'ı iki kez uygulamış olmak anlamına gelir ve yanlış sonuç üretir.
Özet
Özet
- Cross-entropy, modelin doğru sınıfa verdiği olasılığın logaritmasını (eksi işaretle) alır.
- Yanlış yönde emin olmak, cross-entropy'de logaritmik olarak sonsuza yaklaşan bir ceza alır.
- MSE + sigmoid kombinasyonu, çok yanlış tahminlerde bile küçük gradyan üretebilir -- cross-entropy bu tuzağa düşmez.
- İkili sınıflandırmada binary cross-entropy (nn.BCEWithLogitsLoss), çok sınıflıda kategorik cross-entropy (nn.CrossEntropyLoss) kullanılır.
- nn.CrossEntropyLoss ham logit bekler -- softmax'ı kendi içinde uygular.