

Patlayan gradyan ve clipping
Önkoşul:Adam
Kanca
- derste ağırlık w=1’ken sigmoid’in gradyanının katman katman KAYBOLDUĞUNU gördük. Şimdi aynanın diğer yüzüne bakalım: ağırlık 1’den BÜYÜKSE, gradyan katman katman tam tersi yönde — PATLAR.
Sezgi
Patlayan gradyan, geri yayılımda her katmanda çarpılan değerler 1’den büyükse, gradyanın katman sayısıyla ÜSTEL olarak büyümesidir. Kaybolan gradyanın “sinyal hiç ulaşmıyor” sorunu yerine, burada “sinyal o kadar büyüyor ki güncelleme anlamsızlaşıyor” sorunu var.
Mekanizma
- dersteki AYNI deney kurulumunu kullanalım — ama bu kez ağırlığı w=1 yerine w=1.5 yapalım:
w=1.5 ile gradyan patlaması
# 5. derste ağırlık w=1 iken sigmoid'in KAYBOLAN gradyanını görmüştük.
# Şimdi tam TERSİ: ağırlık 1'den BÜYÜKSE (w=1.5), gradyan katman katman PATLAR.
def derin_ag_olustur(katman_sayisi, agirlik):
    katmanlar = []
    for _ in range(katman_sayisi):
        katman = nn.Linear(1, 1, bias=False)
        with torch.no_grad():
            katman.weight.fill_(agirlik)
        katmanlar.append(katman)
    return nn.Sequential(*katmanlar)

print(f"{'Katman sayısı':<16} {'İlk katman gradyanı':<20}")
for katman_sayisi in [1, 5, 10, 15, 20]:
    ag = derin_ag_olustur(katman_sayisi, agirlik=1.5)
    x = torch.tensor([[1.0]], requires_grad=True)
    y = ag(x)
    y.backward()
    print(f"{katman_sayisi:<16} {ag[0].weight.grad.item():<20.4e}")

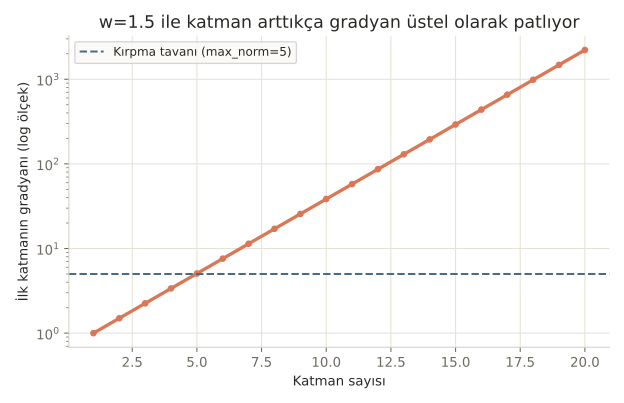
print("\nw=1.5 (sadece %50 büyük) ile 20 katmanda gradyan 2216 KATINA çıkıyor -- vadi problemi 5. dersin AYNASI.")
Katman sayısı İlk katman gradyanı
1 1.0000e+00
5 5.0625e+00
10 3.8443e+01
15 2.9193e+02
20 2.2168e+03
w=1.5 (sadece %50 büyük) ile 20 katmanda gradyan 2216 KATINA çıkıyor -- vadi problemi 5. dersin AYNASI.Sadece %50 büyük bir ağırlıkla (1.5 vs 1.0), 20 katmanlı bir ağda gradyan 2216 KATINA çıkıyor. Çoğu kişi “ağırlıklar 1’e yakınsa sorun olmaz” sanır. Yanlış, çünkü çarpımlar katman sayısıyla ÜSTEL büyür — küçük bir sapma bile devasa bir sonuca dönüşür.
Matematik
Patlayan gradyan ve kırpma (clipping)
| Sembol | Anlamı |
|---|---|
| katmanlı bir ağda, gradyanın büyüklüğü yaklaşık olarak ağırlığın . kuvvetiyle orantılıdır | |
| (tau) | Kırpma tavanı — gradyan normunun izin verilen maksimum büyüklüğü |
| Gradyan normu tavanı AŞARSA küçültme oranı; aşmıyorsa 1 (değişiklik yok) |
Kırpma, gradyanın YÖNÜNÜ korur — sadece büyüklüğünü sınırlar. Bu yüzden “hangi yöne gidileceği” bilgisi kaybolmaz, sadece adım boyutu makul kalır.
Kod
Bu patlamanın PRATİKTE neden tehlikeli olduğunu, sonra PyTorch’un hazır çözümünü görelim:
Tek güncelleme, anlamsız bir ağırlık
# Patlayan gradyan, tek bir kötü güncellemeyle ağırlıkları anlamsız (hatta NaN) değerlere savurabilir.
w = torch.tensor(0.5, requires_grad=True)
ag_20 = derin_ag_olustur(20, agirlik=1.5)
x = torch.tensor([[1.0]])
y = ag_20(x)
y.backward()
gradyan = ag_20[0].weight.grad.item()
ogrenme_orani = 0.01
yeni_agirlik = ag_20[0].weight.item() - ogrenme_orani * gradyan
print(f"\nAğırlık {ag_20[0].weight.item():.3f} idi, TEK bir güncellemeyle {yeni_agirlik:.3f} oldu!")
print("Öğrenme oranı 0.01 gibi KÜÇÜK bir değer olsa bile, gradyan bu kadar büyükse ağırlık anlamsız bir yere savrulabilir.")
Ağırlık 1.500 idi, TEK bir güncellemeyle -20.668 oldu!
Öğrenme oranı 0.01 gibi KÜÇÜK bir değer olsa bile, gradyan bu kadar büyükse ağırlık anlamsız bir yere savrulabilir.
Öğrenme oranı küçük (0.01) olsa bile, ağırlık TEK adımda 1.5’ten -20.668’e savruluyor — bu, modelin o ana kadar öğrendiği her şeyi silebilir.
torch.nn.utils.clip_grad_norm_ ile çözüm
# Çözüm: gradient clipping -- gradyanın NORMUNU (büyüklüğünü) bir tavana sabitlemek.
ag_20_clip = derin_ag_olustur(20, agirlik=1.5)
x = torch.tensor([[1.0]])
y = ag_20_clip(x)
y.backward()

norm_oncesi = torch.nn.utils.get_total_norm([p.grad for p in ag_20_clip.parameters()])
gradyan_normu = torch.nn.utils.clip_grad_norm_(ag_20_clip.parameters(), max_norm=5.0)
norm_sonrasi = torch.nn.utils.get_total_norm([p.grad for p in ag_20_clip.parameters()])

print(f"\nKırpma ÖNCESİ toplam gradyan normu: {norm_oncesi.item():.1f}")
print(f"Kırpma SONRASI toplam gradyan normu: {norm_sonrasi.item():.4f}")
print(f"İlk katmanın gradyanı: {ag_20_clip[0].weight.grad.item():.4f} (kırpmadan önce {ag_20[0].weight.grad.item():.1f} idi)")
print("clip_grad_norm_, TÜM gradyan vektörünü aynı ORANLA küçültür -- yönü korur, sadece büyüklüğü sınırlar.")
Kırpma ÖNCESİ toplam gradyan normu: 9914.0
Kırpma SONRASI toplam gradyan normu: 5.0000
İlk katmanın gradyanı: 1.1180 (kırpmadan önce 2216.8 idi)
clip_grad_norm_, TÜM gradyan vektörünü aynı ORANLA küçültür -- yönü korur, sadece büyüklüğü sınırlar.
Kırpma öncesi toplam gradyan normu 9914.0 iken, kırpma sonrası tam olarak 5.0000 — tavanı aştığı için oranla küçültüldü.
Nerede işe yarar
Gradient clipping, özellikle RNN’lerde (NLP kategorisinde göreceğiz) ve çok derin ağlarda standart bir güvenlik önlemidir:
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=...), backward() sonrası, optimizer.step() öncesi çağrılır.- max_norm tipik olarak 1.0-5.0 arasında seçilir — probleme göre deneysel olarak ayarlanır.
- Kırpma, patlamayı ÖNLEMEZ, sonucunu SINIRLAR — kök neden (kötü ağırlık ilklendirme, çok yüksek öğrenme oranı) hâlâ ayrıca ele alınmalıdır (20. derste ağırlık ilklendirmeyi göreceğiz).
Bu 3 hatayı yaparsın:
- Kaybın aniden NaN olduğunu görüp mimariyi değiştirmeye başlamak — önce gradient clipping eklemeyi dene, çoğu zaman kök neden budur.
- Clipping’i optimizer.step()‘TEN SONRA çağırmak — kırpma, backward() ile step() ARASINDA yapılmalıdır.
- max_norm’u rastgele çok küçük seçip (örn. 0.01) her adımı aşırı kısıtlamak — bu da öğrenmeyi yavaşlatabilir.
Kendini test et
1. Notebook'ta w=1.5 ile 20 katmanlı bir ağda gradyan neden 2216 katına çıktı?
- Kod hatalıydı
- Geri yayılımda her katman gradyanı w ile çarpar; w>1 olduğunda bu çarpım katman sayısıyla ÜSTEL olarak büyür (doğru cevap)
- PyTorch bir hata yaptı
- Öğrenme oranı çok yüksekti
Neden: Zincir kuralı gereği, gradyan her katmanda w ile çarpılır; w=1.5 gibi 1'den büyük bir değer, L katman sonunda yaklaşık w üzeri L kadar büyür -- bu da üstel bir patlamadır.
2. Gradient clipping (gradyan kırpma) tam olarak neyi değiştirir?
- Gradyanın yönünü tersine çevirir
- Gradyan normu bir tavanı aşarsa, YÖNÜ koruyarak sadece BÜYÜKLÜĞÜNÜ o tavana kadar küçültür (doğru cevap)
- Öğrenme oranını sıfırlar
- Ağırlıkları rastgele değiştirir
Neden: Kırpma, gradyan vektörünü normu tavanı aşıyorsa aynı yönde ama daha küçük bir büyüklüğe ölçekler -- "hangi yöne gidileceği" bilgisi korunur, sadece adım boyutu sınırlanır.
3. torch.nn.utils.clip_grad_norm_ ne zaman çağrılmalıdır?
- optimizer.step()'ten SONRA
- loss.backward() ile optimizer.step() ARASINDA (doğru cevap)
- Eğitim başlamadan önce, bir kere
- Hiç önemli değil, herhangi bir sırada çağrılabilir
Neden: Gradyanlar backward() ile hesaplandıktan SONRA, ama optimizer bu gradyanları kullanarak ağırlıkları güncellemeden (step()) ÖNCE kırpılmalıdır -- aksi halde kırpma hiçbir etki yapmaz.
Özet
Özet
- Patlayan gradyan, ağırlıklar 1'den büyükken (veya benzer bir çarpan etkisiyle) geri yayılımda gradyanın katman sayısıyla üstel büyümesidir.
- Bu, kaybolan gradyanın (5. ders) tam tersi problemidir -- ama sonucu aynı derecede yıkıcı olabilir.
- Tek bir kötü güncelleme, ağırlıkları anlamsız (hatta NaN) değerlere savurabilir.
- Gradient clipping (clip_grad_norm_), gradyan normunu bir tavana sabitleyerek bu riski kontrol eder.
- Kırpma, patlamanın SONUCUNU sınırlar; kök nedeni (ağırlık ilklendirme, öğrenme oranı) ayrıca ele almak gerekir.