

L1/L2 düzenlileştirme
Önkoşul:Ağırlık ilklendirme
Kanca
Makine Öğrenmesi kategorisinde Ridge/Lasso ile L1/L2 cezalarını klasik regresyon bağlamında görmüştük. Sinir ağlarında bu fikirler AYNI matematikle ama farklı bir isim ve farklı bir amaçla karşımıza çıkıyor: weight decay, aşırı öğrenmeyi önlemenin en temel yollarından biri.
Sezgi
Düzenlileştirme (regularization), kayıp fonksiyonuna ağırlıkların BÜYÜKLÜĞÜNÜ cezalandıran bir terim ekler. Fikir basit: büyük ağırlıklar genelde “ezberlemenin” işaretidir — model, veri setindeki gürültüye bile aşırı hassas hale gelmiştir. Ağırlıkları küçük tutmaya ZORLAMAK, modeli daha “genel” bir çözüme itiyor.
Mekanizma
Önce ML kategorisindeki L1/L2 farkını hızlıca hatırlayalım:
L1 (Lasso) vs L2 (Ridge) hatırlatması
# ML kategorisindeki Ridge/Lasso dersinde L1 (Lasso) ve L2 (Ridge) cezalarını görmüştük.
# Hızlı bir hatırlatma: L1, gereksiz özellikleri TAM SIFIRA çekerken, L2 küçültür ama sıfırlamaz.
np.random.seed(0)
N = 100
X = np.random.randn(N, 5)
gercek_w = np.array([3.0, -2.0, 0.0, 0.0, 0.0])  # sadece ilk 2 özellik GERÇEKTEN önemli
y = X @ gercek_w + np.random.randn(N) * 0.1

lasso = Lasso(alpha=0.1).fit(X, y)
ridge = Ridge(alpha=1.0).fit(X, y)
print("Gerçek ağırlıklar:", gercek_w)
print("Lasso (L1):        ", np.round(lasso.coef_, 4))
print("Ridge (L2):        ", np.round(ridge.coef_, 4))
print("\nLasso, önemsiz 3 özelliği TAM SIFIRA çekiyor -- Ridge küçültüyor ama sıfırlamıyor.")
print("Sinir ağlarında bu tür 'özellik seçimi' nadiren hedeftir -- asıl mesele AŞIRI ÖĞRENMEYİ önlemek.")
Gerçek ağırlıklar: [ 3. -2. 0. 0. 0.]
Lasso (L1): [ 2.9079 -1.8922 0. -0. -0. ]
Ridge (L2): [ 2.9741e+00 -1.9724e+00 2.0600e-02 -6.0000e-04 -1.1200e-02]
Lasso, önemsiz 3 özelliği TAM SIFIRA çekiyor -- Ridge küçültüyor ama sıfırlamıyor.
Sinir ağlarında bu tür 'özellik seçimi' nadiren hedeftir -- asıl mesele AŞIRI ÖĞRENMEYİ önlemek.Lasso (L1), önemsiz özellikleri TAM sıfıra çekiyor; Ridge (L2) küçültüyor ama sıfırlamıyor. Sinir ağlarında ise asıl mesele “hangi özellik önemli” değil — aşırı öğrenmeyi önlemek. Küçük, gürültülü bir veri setinde büyük bir ağ eğitelim:
weight_decay, aşırı öğrenmeyi nasıl önler
# Sinir ağlarında L2, genelde 'weight decay' olarak optimizer İÇİNDE uygulanır.
# Küçük, gürültülü bir veri setinde büyük bir ağ -- aşırı öğrenmeye MÜKEMMEL bir aday.
torch.manual_seed(0)
N_egitim = 15
x_egitim = torch.linspace(-3, 3, N_egitim).unsqueeze(1)
y_egitim = torch.sin(x_egitim) + torch.randn(N_egitim, 1) * 0.3

N_test = 100
x_test = torch.linspace(-3, 3, N_test).unsqueeze(1)
y_test = torch.sin(x_test)

def ag_olustur():
    torch.manual_seed(1)
    return nn.Sequential(nn.Linear(1, 64), nn.Tanh(), nn.Linear(64, 64), nn.Tanh(), nn.Linear(64, 1))

def egit(weight_decay, epochs=2000, lr=0.01):
    ag = ag_olustur()
    optimizer = torch.optim.Adam(ag.parameters(), lr=lr, weight_decay=weight_decay)
    for _ in range(epochs):
        optimizer.zero_grad()
        tahmin = ag(x_egitim)
        kayip = torch.mean((tahmin - y_egitim) ** 2)
        kayip.backward()
        optimizer.step()
    egitim_kaybi = torch.mean((ag(x_egitim) - y_egitim) ** 2).item()
    test_kaybi = torch.mean((ag(x_test) - y_test) ** 2).item()
    agirlik_normu = sum(p.abs().sum().item() for p in ag.parameters())
    return egitim_kaybi, test_kaybi, agirlik_normu

print(f"\n{'weight_decay':<14} {'Eğitim kaybı':<14} {'Test kaybı':<12} {'Ağırlık normu':<14}")
sonuclar = {}
for wd in [0.0, 0.001, 0.01, 0.1]:
    et, tt, an = egit(wd)
    sonuclar[wd] = (et, tt, an)
    print(f"{wd:<14} {et:<14.4f} {tt:<12.4f} {an:<14.1f}")

print("\nwd=0: eğitim kaybı NEREDEYSE SIFIR (ezberlemiş) ama ağırlık normu devasa (666.1) -- klasik aşırı öğrenme.")
print("wd=0.01: eğitim kaybı biraz arttı ama TEST kaybı en düşük -- bu, düzenlileştirmenin 'tatlı noktası'.")
print("wd=0.1: eğitim kaybı çok arttı (yetersiz öğrenme) -- aşırı düzenlileştirme yeni bir sorun yaratıyor.")
weight_decay   Eğitim kaybı   Test kaybı   Ağırlık normu
0.0            0.0000         0.0696       666.1
0.001          0.0106         0.0596       174.0
0.01           0.0719         0.0165       84.8
0.1            0.2257         0.0675       31.5

wd=0: eğitim kaybı NEREDEYSE SIFIR (ezberlemiş) ama ağırlık normu devasa (666.1) -- klasik aşırı öğrenme.
wd=0.01: eğitim kaybı biraz arttı ama TEST kaybı en düşük -- bu, düzenlileştirmenin 'tatlı noktası'.
wd=0.1: eğitim kaybı çok arttı (yetersiz öğrenme) -- aşırı düzenlileştirme yeni bir sorun yaratıyor.
weight_decay=0 iken eğitim kaybı NEREDEYSE SIFIR (ağ, 15 noktayı ezberlemiş) ama ağırlık normu 666.1 — devasa. weight_decay=0.01’de eğitim kaybı biraz artıyor ama TEST kaybı en düşük noktaya (0.0165) iniyor. Çoğu kişi “düzenlileştirme ne kadar güçlü olursa o kadar iyi” sanır. Yanlış, çünkü weight_decay=0.1’de eğitim kaybı da test kaybı da KÖTÜLEŞİYOR — model artık yetersiz öğreniyor.
Matematik
Düzenlileştirilmiş kayıp fonksiyonu
| Sembol | Anlamı |
|---|---|
| (lambda) | Düzenlileştirme gücü — 0 ise ceza yok, büyüdükçe ağırlıklar daha çok baskılanır |
| L1 cezası | Ağırlıkların MUTLAK DEĞERLERİNİN toplamı — sıfıra çeken (seyreklik) etkisi |
| L2 cezası | Ağırlıkların KARELERİNİN toplamı — büyük ağırlıkları orantısız cezalandırır, ama sıfırlamaz |
PyTorch’ta L2, weight_decay parametresiyle optimizer’ın İÇİNDE, ayrı bir loss terimi yazmaya GEREK KALMADAN uygulanır.
Kod
PyTorch’ta bu ne kadar basit, görelim:
weight_decay tek satır
# PyTorch'ta weight_decay, optimizer'a TEK bir parametreyle eklenir -- L2 cezasını elle
# loss'a eklemeye GEREK YOK, optimizer bunu otomatik yapar.
print("\ntorch.optim.Adam(model.parameters(), lr=0.01, weight_decay=0.01)")
print("Bu satır, her güncellemede ağırlıklara otomatik olarak w -= lr * weight_decay * w ekler.")
print("Elle eklemek isteseydik: kayip = kayip + weight_decay * sum(w**2 for w in agirliklar)")
torch.optim.Adam(model.parameters(), lr=0.01, weight_decay=0.01)
Bu satır, her güncellemede ağırlıklara otomatik olarak w -= lr * weight_decay * w ekler.
Elle eklemek isteseydik: kayip = kayip + weight_decay * sum(w**2 for w in agirliklar)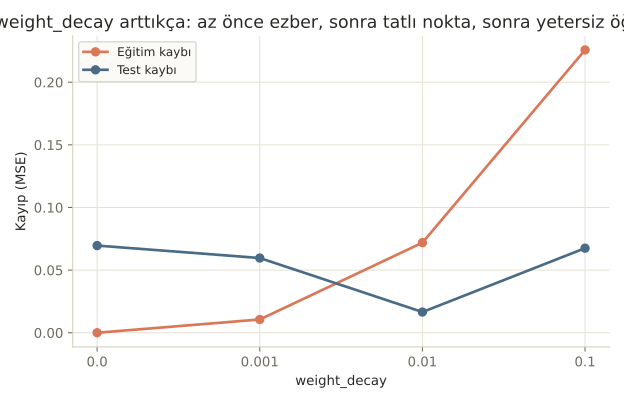
Nerede işe yarar
Weight decay, pratikte en yaygın kullanılan düzenlileştirme tekniklerinden biridir:
- PyTorch’ta
torch.optim.Adam(params, lr=..., weight_decay=...)ile tek parametre. Tipik değerler 1e-5 ile 1e-2 arası. - L2 (weight decay), sinir ağlarında L1’den ÇOK daha yaygın kullanılır — ağırlıkları tam sıfırlamak (seyreklik) nadiren hedeftir; amaç sadece büyümelerini sınırlamaktır.
- 22-24. derste (Dropout, Batch/Layer normalization) başka düzenlileştirme tekniklerini göreceğiz — weight decay bunlarla BİRLİKTE kullanılabilir.
Bu 3 hatayı yaparsın:
- weight_decay’i hiç kullanmayıp modelin küçük veri setlerinde ezberlediğini fark etmemek.
- weight_decay’i çok yükseğe ayarlayıp modelin yetersiz öğrenmesine (underfitting) neden olmak — notebook’taki wd=0.1 örneği gibi.
- Adam ile weight_decay kullanırken “AdamW” adlı düzeltilmiş versiyonun varlığından habersiz olmak — klasik Adam’da weight_decay’in matematiği hafifçe farklı davranır (NLP kategorisinde bu detaya döneceğiz).
Kendini test et
1. Notebook'ta weight_decay=0 iken eğitim kaybı neredeyse sıfırken test kaybının (0.0696) yüksek kalması neyi gösteriyor?
- Kod hatası
- Model, eğitim verisini EZBERLEMİŞ (aşırı öğrenme) -- eğitim verisinde mükemmel ama görmediği veride kötü performans gösteriyor (doğru cevap)
- Model hiç öğrenmedi
- Test verisi hatalıydı
Neden: Eğitim kaybının neredeyse sıfır ama test kaybının yüksek olması, klasik aşırı öğrenme belirtisidir -- model, eğitim verisindeki GÜRÜLTÜYE bile uyum sağlamış (büyük ağırlık normu 666.1 bunun kanıtı).
2. weight_decay değerini çok yükseğe (örn. 0.1) ayarlamanın notebook'taki sonucu neydi?
- Test kaybı sürekli düşmeye devam etti
- Hem eğitim hem test kaybı KÖTÜLEŞTİ -- model artık yetersiz öğreniyor (underfitting) (doğru cevap)
- Hiçbir etkisi olmadı
- Sadece eğitim hızını etkiledi
Neden: wd=0.1'de eğitim kaybı 0.2257'ye (en yüksek), test kaybı da 0.0675'e çıktı -- aşırı düzenlileştirme, modelin veri deki gerçek örüntüyü bile öğrenmesini engelliyor.
3. Sinir ağlarında L2 (weight decay), L1'den neden daha yaygın kullanılır?
- L1 matematiksel olarak yanlıştır
- Sinir ağlarında amaç genelde "hangi ağırlık önemsiz, onu tam sıfırla" (seyreklik) değil, sadece ağırlıkların büyümesini sınırlamaktır -- L2 bunun için daha uygundur (doğru cevap)
- L2 her zaman daha hızlı hesaplanır
- L1, PyTorch'ta desteklenmez
Neden: L1'in seyreklik (bazı ağırlıkları tam sıfırlama) etkisi klasik regresyonda özellik seçimi için değerlidir, ama sinir ağlarında genelde istenen şey sadece ağırlık büyüklüklerini kontrol altında tutmaktır -- bu da L2'nin doğal alanıdır.
Özet
Özet
- Düzenlileştirme, kayıp fonksiyonuna ağırlık büyüklüğünü cezalandıran bir terim ekleyerek aşırı öğrenmeyi önler.
- L1 (Lasso), ağırlıkları tam sıfıra çekebilir (seyreklik); L2 (Ridge/weight decay) küçültür ama sıfırlamaz.
- Sinir ağlarında L2, weight_decay parametresiyle optimizer içinde uygulanır ve L1'den çok daha yaygındır.
- Düzenlileştirme gücü (λ / weight_decay) bir "tatlı nokta" gerektirir -- çok azı aşırı öğrenmeyi önlemez, çok fazlası yetersiz öğrenmeye yol açar.
- Bir sonraki derste (Dropout), ağırlık büyüklüğünü değil, ağın YAPISINI hedefleyen farklı bir düzenlileştirme tekniği göreceğiz.