

RMSprop ve Adadelta
Önkoşul:Adagrad
Kanca
- dersin sonunda Adagrad’ın büyük zayıflığını gördük: efektif öğrenme oranı SÜREKLİ küçülüyor, uzun eğitimlerde öğrenme neredeyse duruyor. RMSprop, bu sorunu TEK bir değişiklikle çözüyor.
Sezgi
RMSprop, Adagrad’ın “tüm geçmişi biriktir” yaklaşımı yerine, SADECE YAKIN GEÇMİŞİ ağırlıklı olarak hatırlayan bir üstel hareketli ortalama kullanır. Bu küçük değişiklik, efektif öğrenme oranının sıfıra sürüklenmesini önler.
Optimizer yarışında RMSprop’u (turuncu-kahve) Adagrad ile karşılaştır — ikisi de “uyarlanabilir” ama farklı hızlarda hareket ediyorlar.
Adım: 0
SGD'nin dar vadide nasıl ZİGZAG çizdiğine, momentumun ise bu salınımı nasıl yumuşatıp hızlandırdığına dikkat et.
Mekanizma
- dersteki Adagrad deneyini UZATALIM — 200 adım boyunca sabit bir gradyan alan bir ağırlığın efektif öğrenme oranı ne olur?
Adagrad, 200 adımda
# 16. derste Adagrad'ın efektif öğrenme oranının SÜREKLİ küçüldüğünü görmüştük.
# Bunu UZUN bir eğitimde (200 adım) izleyelim -- sabit gradyan alan bir ağırlık için.
def adagrad_efektif_lr(adim_sayisi, lr=0.4):
    cache = 0.0
    lrlar = []
    for t in range(adim_sayisi):
        cache += 1.0 ** 2  # sabit gradyan=1
        lrlar.append(lr / (np.sqrt(cache) + 1e-8))
    return lrlar

adagrad_lrlar = adagrad_efektif_lr(200)
print("Adagrad efektif öğrenme oranı (sabit gradyanla):")
for t in [1, 10, 50, 100, 150, 200]:
    print(f"  adım {t}: {adagrad_lrlar[t-1]:.5f}")
print("Sürekli küçülüyor -- 200. adımda başlangıcın SADECE %7'si kadar.")
Adagrad efektif öğrenme oranı (sabit gradyanla):
adım 1: 0.40000
adım 10: 0.12649
adım 50: 0.05657
adım 100: 0.04000
adım 150: 0.03266
adım 200: 0.02828
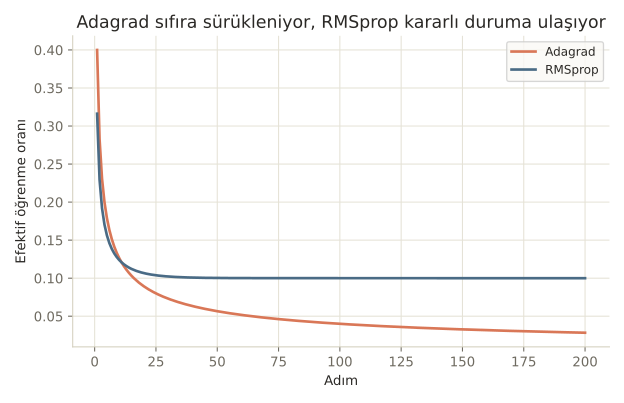
Sürekli küçülüyor -- 200. adımda başlangıcın SADECE %7'si kadar.RMSprop, aynı 200 adımda
# RMSprop, TÜM geçmişi biriktirmek yerine bir ÜSTEL HAREKETLİ ORTALAMA kullanır.
# Bu, efektif öğrenme oranının bir noktada SABİTLENMESİNİ sağlar.
def rmsprop_efektif_lr(adim_sayisi, lr=0.1, decay=0.9):
    cache = 0.0
    lrlar = []
    for t in range(adim_sayisi):
        cache = decay * cache + (1 - decay) * 1.0 ** 2
        lrlar.append(lr / (np.sqrt(cache) + 1e-8))
    return lrlar

rmsprop_lrlar = rmsprop_efektif_lr(200)
print("\nRMSprop efektif öğrenme oranı (aynı sabit gradyanla):")
for t in [1, 10, 50, 100, 150, 200]:
    print(f"  adım {t}: {rmsprop_lrlar[t-1]:.5f}")
print("100. adımdan sonra SABİTLENİYOR (0.1) -- Adagrad'ın aksine sıfıra gitmiyor.")
RMSprop efektif öğrenme oranı (aynı sabit gradyanla):
  adım 1: 0.31623
  adım 10: 0.12391
  adım 50: 0.10026
  adım 100: 0.10000
  adım 150: 0.10000
  adım 200: 0.10000
100. adımdan sonra SABİTLENİYOR (0.1) -- Adagrad'ın aksine sıfıra gitmiyor.
Adagrad’ın efektif lr’ı 200. adımda başlangıcın sadece %7’sine (0.028) inerken, RMSprop’unki 100. adım civarında 0.1’de SABİTLENİYOR. Çoğu kişi “uyarlanabilir optimizer’lar hep aynı şekilde davranır” sanır. Yanlış, çünkü Adagrad’ın “toplam” hafızası sınırsız büyürken, RMSprop’un “hareketli ortalama” hafızası sabit bir ufka bakar.
Matematik
RMSprop güncelleme kuralı
| Sembol | Anlamı |
|---|---|
| (rho) | Bozunma katsayısı (genelde 0.9) — geçmişin ne kadarının “unutulacağı” |
| Kareli gradyanların ÜSTEL HAREKETLİ ORTALAMASI — Adagrad’daki gibi TOPLAM değil |
Tek fark Adagrad’ın formülüyle burada: RMSprop ile geçmişi “unutturuyor”, Adagrad hiç unutmuyor. Bu tek terim, tüm uzun-vadeli davranışı değiştiriyor.
Kod
PyTorch’un torch.optim.RMSprop’u ile doğrulayalım, sonra RMSprop’un “öğrenme oranı bile gerektirmeyen” kuzeni Adadelta’ya kısaca bakalım:
PyTorch ile doğrulama
# PyTorch torch.optim.RMSprop ile karşılaştıralım.
w = torch.tensor(5.0, requires_grad=True)
optimizer = torch.optim.RMSprop([w], lr=0.1, alpha=0.9)
for t in range(30):
    optimizer.zero_grad()
    w.grad = torch.tensor(1.0)
    optimizer.step()
print(f"\nPyTorch RMSprop, 30 adım sonra w={w.item():.4f}")
PyTorch RMSprop, 30 adım sonra w=1.1052Adadelta -- öğrenme oranı bile gerektirmez
# Adadelta, RMSprop'un bir adım ötesi: öğrenme oranını BİLE elle belirlemeye gerek bırakmaz.
# Geçmiş GÜNCELLEME büyüklüklerini de (Edelta) biriktirip, adım boyutunu kendi kendine ölçeklendirir.
def adadelta(adim_sayisi, decay=0.9, eps=1e-6):
    w, Eg, Edelta = 5.0, 0.0, 0.0
    yol = [w]
    for _ in range(adim_sayisi):
        g = 1.0
        Eg = decay * Eg + (1 - decay) * g ** 2
        delta_w = -(np.sqrt(Edelta + eps) / np.sqrt(Eg + eps)) * g
        w += delta_w
        Edelta = decay * Edelta + (1 - decay) * delta_w ** 2
        yol.append(w)
    return yol

yol_adadelta = adadelta(30)
print(f"\nAdadelta (öğrenme oranı BELİRTİLMEDEN), 30 adım sonra w={yol_adadelta[-1]:.4f}")
print("İlk adımlar çok KÜÇÜK (Edelta henüz 'ısınmadı') -- bu Adadelta'nın bilinen yavaş başlangıç özelliği.")
Adadelta (öğrenme oranı BELİRTİLMEDEN), 30 adım sonra w=4.8925
İlk adımlar çok KÜÇÜK (Edelta henüz 'ısınmadı') -- bu Adadelta'nın bilinen yavaş başlangıç özelliği.
Adadelta, RMSprop’un fikrini bir adım ileri götürüp GEÇMİŞ GÜNCELLEME büyüklüklerini de takip ediyor ve adım boyutunu kendi kendine ölçekliyor — ama ilk adımları ÇOK küçük kalıyor (henüz “ısınmadığı” için).
Nerede işe yarar
RMSprop, pratikte Adagrad’ın neredeyse her zaman tercih edilen yerine geçtiği bir yöntemdir:
- Uzun eğitimlerde RMSprop, Adagrad’a göre çok daha güvenlidir — öğrenme oranı sıfıra sürüklenmez.
- (bozunma katsayısı) genelde 0.9 veya 0.99 olarak bırakılır — nadiren ayarlanır.
- Adadelta, öğrenme oranı seçme derdini bile ortadan kaldırır ama yavaş başlangıcı nedeniyle pratikte RMSprop veya Adam kadar yaygın kullanılmaz.
Bu 3 hatayı yaparsın:
- Adagrad’ı hâlâ kullanıp “neden eğitim durdu” diye şaşırmak — RMSprop bu spesifik sorunu çözer.
- RMSprop’un ‘sunu çok düşük (örn. 0.5) ayarlayıp “hareketli ortalamayı” neredeyse anlıksız hale getirmek — bu da gürültüyü geri getirir.
- Adadelta’nın yavaş başlangıcını “bozuk” sanıp erken durdurmak — bu, Edelta’nın henüz “ısınmamış” olmasından kaynaklanan BEKLENEN bir davranış.
Kendini test et
1. RMSprop, Adagrad'ın 'efektif öğrenme oranı sıfıra sürükleniyor' sorununu nasıl çözer?
- Öğrenme oranını sabit tutarak
- Tüm geçmiş gradyanları TOPLAMAK yerine, SADECE yakın geçmişi ağırlıklı hatırlayan bir üstel hareketli ortalama kullanarak (doğru cevap)
- Gradyanı sıfırlayarak
- Momentum ekleyerek
Neden: Adagrad'ın cache'i sınırsız TOPLAM iken RMSprop'unki üstel hareketli ORTALAMADIR -- bu sayede eski gradyanlar zamanla 'unutulur' ve efektif öğrenme oranı bir kararlı duruma ulaşıp orada kalır.
2. Notebook'ta 200 adım sonra Adagrad'ın efektif öğrenme oranı ile RMSprop'unki arasındaki temel fark neydi?
- İkisi de aynı şekilde davrandı
- Adagrad sürekli küçülmeye devam etti (başlangıcın %7'sine indi); RMSprop 100. adım civarında sabitlendi (doğru cevap)
- RMSprop sıfıra indi, Adagrad sabit kaldı
- İkisi de sıfıra indi
Neden: Adagrad'ın efektif lr'ı 200. adımda 0.02828'e (başlangıcın ~%7'si) düşerken, RMSprop'unki 0.1'de sabitlendi -- bu, RMSprop'un 'unutan hafızasının' doğrudan sonucudur.
3. Adadelta, RMSprop'tan hangi ek özelliğiyle ayrılır?
- Daha hızlı çalışır
- Geçmiş GÜNCELLEME büyüklüklerini de (Edelta) takip ederek, öğrenme oranını elle belirlemeyi bile gereksiz kılar (doğru cevap)
- Sadece görüntü verisinde çalışır
- Momentum kullanmaz
Neden: Adadelta, RMSprop'un gradyan-karesi hafızasına ek olarak geçmiş güncelleme büyüklüklerinin (Edelta) hareketli ortalamasını da tutar ve bunu adım boyutunu kendi kendine ölçeklemek için kullanır -- bu yüzden ayrı bir öğrenme oranı belirtmeye gerek kalmaz.
Özet
Özet
- RMSprop, Adagrad'ın "tüm geçmişi topla" yaklaşımını "yakın geçmişi ağırlıklı hatırla" (üstel hareketli ortalama) ile değiştirir.
- Bu değişiklik, efektif öğrenme oranının sıfıra sürüklenmesini önler -- bir kararlı duruma ulaşıp orada kalır.
- RMSprop, pratikte Adagrad'ın yerini almış, uzun eğitimler için çok daha güvenli bir yöntemdir.
- Adadelta, RMSprop'un fikrini genişletip öğrenme oranını bile elle belirlemeyi gereksiz kılar -- ama yavaş başlar.
- Bir sonraki derste, momentum ve RMSprop'un fikirlerini BİRLEŞTİREN Adam'ı göreceğiz.