

İleri yayılım
Önkoşul:Yapay sinir ağına giriş
Kanca
- derste bir gizli katmanın XOR’u çözdüğünü gördük ama “içeride ne oluyor” sorusunu es geçtik. Bu derste, bir sinir ağının bir girdiyi alıp bir tahmine dönüştürme sürecini — “ileri yayılım” — gerçek sayılarla, adım adım açacağız.
Sezgi
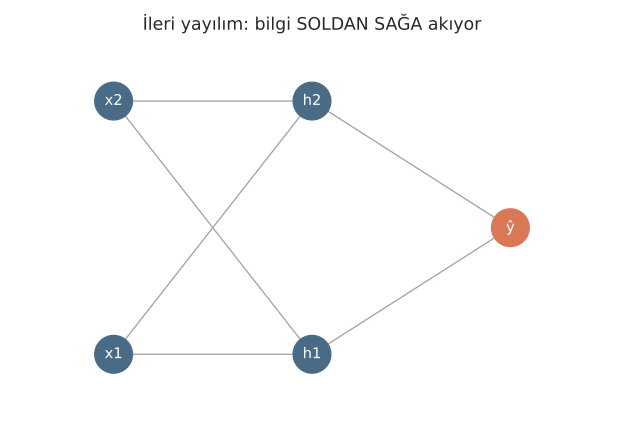
İleri yayılım, bir girdinin ağın katmanlarından SIRAYLA geçerek bir tahmine dönüşme sürecidir. Her katman, bir öncekinin çıktısını alır, kendi ağırlıklarıyla çarpıp toplar, bir aktivasyon fonksiyonundan geçirir ve sonucu bir sonraki katmana aktarır. Bilgi hep TEK YÖNDE, girdiden çıktıya doğru akar.
Gizli nöron 1: z₁ = 0.5·1 + 0.3·1 + 0.1 = 0.900 → h₁ = ReLU(z₁) = 0.900
Gizli nöron 2: z₂ = -0.4·1 + 0.6·1 + -0.15 = 0.050 → h₂ = ReLU(z₂) = 0.050
Çıktı nöronu: ŷ = 0.7·0.900 + (-0.5)·0.050 + 0.2 = 0.805
Kayıp: L = ½(ŷ − y)² = ½(0.805 − 1)² = 0.0190
Girdiler ağdan SIRAYLA (soldan sağa) geçiyor: önce gizli katman, sonra çıktı, sonra kayıp.
“İleri yayılım” sekmesinde, x1, x2 ve hedef y’yi değiştirip her adımın nasıl yeniden hesaplandığını izle. Her satır, bir öncekinin sonucunu KULLANIYOR — bu sıralı bağımlılık, “ileri yayılım” adının kaynağı.
Mekanizma
Aynı 2-2-1 ağı (2 girdi, 2 gizli nöron, 1 çıktı) NumPy ile elle kuralım:
Ağ ağırlıkları
# İnteraktif bileşendeki AYNI 2-2-1 ağ -- 2 girdi, 2 gizli nöron (ReLU), 1 çıktı nöronu (doğrusal).
W1 = np.array([[0.5, -0.4], [0.3, 0.6]])   # (girdi x gizli) -- sütun 1: nöron 1'in ağırlıkları
b1 = np.array([0.1, -0.15])
W2 = np.array([0.7, -0.5])                  # (gizli x çıktı)
b2 = 0.2

def relu(z):
    return np.maximum(0, z)
Bu blok yazdırılan bir çıktı üretmiyor.
Tek bir örnek için ileri yayılım
x = np.array([1.0, 1.0])
z1 = x @ W1 + b1
h1 = relu(z1)
z_cikti = h1 @ W2 + b2
y_tahmin = z_cikti  # çıktı katmanı doğrusal (aktivasyonsuz)

print(f"Girdi: x = {x}")
print(f"Gizli katman ön-aktivasyonu: z1 = {z1.round(3)}")
print(f"Gizli katman aktivasyonu (ReLU sonrası): h1 = {h1.round(3)}")
print(f"Çıktı: ŷ = {y_tahmin:.3f}")
print("\nBu SIRALI hesaplama -- her katman, bir öncekinin ÇIKTISINI girdi olarak alıyor. Buna 'ileri yayılım' deniyor.")
Girdi: x = [1. 1.]
Gizli katman ön-aktivasyonu: z1 = [0.9 0.05]
Gizli katman aktivasyonu (ReLU sonrası): h1 = [0.9 0.05]
Çıktı: ŷ = 0.805
Bu SIRALI hesaplama -- her katman, bir öncekinin ÇIKTISINI girdi olarak alıyor. Buna 'ileri yayılım' deniyor.ŷ=0.805 — interaktif bileşendeki AYNI sayı! Bu hesaplamayı genel bir fonksiyona dönüştürelim, çünkü her katmanda AYNI işlem tekrarlanıyor:
Genel katman fonksiyonu
# Genel bir "katman" fonksiyonu yazalım -- her katmanda AYNI işlem tekrarlanıyor.
def katman_ileri(girdi, W, b, aktivasyon=None):
    z = girdi @ W + b
    a = aktivasyon(z) if aktivasyon else z
    return z, a

z1_tekrar, h1_tekrar = katman_ileri(x, W1, b1, relu)
_, y_tekrar = katman_ileri(h1_tekrar, W2, b2)
print(f"Genel katman fonksiyonuyla bulunan ŷ: {y_tekrar:.3f}  (elle hesaplananla birebir aynı: {y_tahmin:.3f})")
Genel katman fonksiyonuyla bulunan ŷ: 0.805 (elle hesaplananla birebir aynı: 0.805)Matematik
İleri yayılımın genel formülü
| Sembol | Anlamı |
|---|---|
| Katman indeksi (1, 2, …, son katman) | |
| Bir ÖNCEKİ katmanın çıktısı (aktivasyonu) — bu katmanın girdisi | |
| Bu katmanın öğrenilebilir ağırlıkları ve bias’ları | |
| Bu katmanın aktivasyon fonksiyonu (ReLU, sigmoid, veya YOK — doğrusal) |
Bu formül, KAÇ katman olursa olsun aynı kalır — sadece arttıkça tekrarlanır. Modern derin öğrenme çerçeveleri (PyTorch gibi), tam olarak bu tekrarlanan yapıyı otomatikleştirir.
Kod
Gerçek eğitimde tek bir örnek değil, YÜZLERCE/BİNLERCE örnek aynı anda işlenir:
Vektörleştirilmiş ileri yayılım
# Gerçek eğitimde TEK BİR örnek değil, YÜZLERCE örnek aynı anda işlenir -- matris çarpımı bunu bedavaya getirir.
X_grup = np.array([
    [1.0, 1.0],
    [2.0, -1.0],
    [-1.0, 0.5],
    [0.0, 2.0],
])
Z1_grup, H1_grup = katman_ileri(X_grup, W1, b1, relu)
_, Y_grup = katman_ileri(H1_grup, W2, b2)
print(f"\n4 örnek AYNI ANDA işlendi (tek matris çarpımıyla):")
for xi, yi in zip(X_grup, Y_grup):
    print(f"  x={xi}  ->  ŷ={yi:.3f}")
4 örnek AYNI ANDA işlendi (tek matris çarpımıyla):
  x=[1. 1.]  ->  ŷ=0.805
  x=[ 2. -1.]  ->  ŷ=0.760
  x=[-1.   0.5]  ->  ŷ=-0.075
  x=[0. 2.]  ->  ŷ=0.165
4 örnek, TEK bir matris çarpımıyla işlendi — döngü YOK. Bunun hız açısından ne kadar önemli olduğunu ölçelim:
Döngü vs vektörleştirme
from time import perf_counter

X_buyuk = np.random.default_rng(1).normal(0, 1, size=(10000, 2))

baslangic = perf_counter()
for i in range(len(X_buyuk)):
    z1_i = X_buyuk[i] @ W1 + b1
    h1_i = relu(z1_i)
    _ = h1_i @ W2 + b2
sure_dongu = perf_counter() - baslangic

baslangic = perf_counter()
Z1_b, H1_b = katman_ileri(X_buyuk, W1, b1, relu)
_ = H1_b @ W2 + b2
sure_matris = perf_counter() - baslangic

print(f"\n10.000 örnek, TEK TEK döngüyle: {sure_dongu:.4f} saniye")
print(f"10.000 örnek, TEK matris çarpımıyla: {sure_matris:.4f} saniye")
print(f"Matris çarpımı {sure_dongu / sure_matris:.1f}x daha hızlı -- bu yüzden PyTorch/NumPy her zaman VEKTÖRLEŞTİRİLMİŞ işlem kullanır.")
10.000 örnek, TEK TEK döngüyle: 0.0549 saniye
10.000 örnek, TEK matris çarpımıyla: 0.0003 saniye
Matris çarpımı 178.8x daha hızlı -- bu yüzden PyTorch/NumPy her zaman VEKTÖRLEŞTİRİLMİŞ işlem kullanır.
179 kat daha hızlı! Çoğu kişi “döngü ile matris çarpımı sonuçta aynı işi yapıyor, hız farkı önemsiz” sanır. Değil, çünkü NumPy/PyTorch’un matris çarpımı, optimize edilmiş, düşük seviye (C/CUDA) kod kullanır ve birden fazla hesaplamayı PARALEL yürütebilir — Python’un yavaş döngüsü bu avantajdan tamamen mahrum kalır. Bu yüzden gerçek sinir ağı kütüphaneleri ASLA Python döngüsüyle ileri yayılım yapmaz.
Nerede işe yarar
İleri yayılım, bir sinir ağının “çalışma zamanı” (inference) davranışının tamamıdır:
- Eğitilmiş bir modelle tahmin yapmak. Bir model eğitildikten sonra, yeni bir girdi için sadece ileri yayılım çalıştırılır — geri yayılım (bir sonraki ders) artık gerekmez.
- Vektörleştirmenin önemini kavramak. Bu ders boyunca göreceğimiz PyTorch kodlarının neden hep matris işlemleriyle yazıldığını anlamak.
- Model mimarisini okuyabilmek. Bir sinir ağı diyagramını gördüğünde, “bilgi nasıl akıyor” sorusuna doğrudan cevap verebilmek.
Bu 3 hatayı yaparsın:
- İleri yayılımı Python döngüleriyle elle yazmak — bu derste gördüğümüz gibi, vektörleştirilmiş matris işlemlerinden onlarca-yüzlerce kat daha yavaştır.
- Katmanlar arası boyut uyumsuzluğunu (matris çarpımı için gereken şekil uyumu) göz ardı etmek — ‘nin şekli, bir önceki katmanın çıktı boyutuyla eşleşmelidir.
- Aktivasyon fonksiyonunu her katmanda uygulamayı unutmak — 2. derste gördüğümüz gibi, aktivasyonsuz katmanlar matematiksel olarak tek bir doğrusal dönüşüme “çöker”.
Kendini test et
1. İleri yayılım sürecinde bilgi hangi yönde akar?
- Çıktıdan girdiye doğru
- Girdiden çıktıya doğru, katman katman SIRAYLA (doğru cevap)
- Rastgele bir yönde
- Aynı anda her iki yönde
Neden: İleri yayılım, girdiyi alıp katman katman işleyerek çıktıya doğru TEK YÖNDE ilerler; her katman bir öncekinin çıktısını girdi olarak kullanır.
2. Notebook'ta matris çarpımı, Python döngüsünden neden 179 kat daha hızlı çıktı?
- Rastgele bir ölçüm hatası
- NumPy'ın matris çarpımı optimize edilmiş, düşük seviye kod kullanır ve hesaplamaları paralel yürütebilir; Python döngüsü bu avantajlardan mahrumdur (doğru cevap)
- Matris çarpımı daha az doğru sonuç verir
- Veri seti çok küçüktü
Neden: NumPy'ın (ve PyTorch'un) matris işlemleri, C/CUDA gibi düşük seviye, optimize edilmiş kodlarla ve paralel hesaplamayla çalışır; yorumlanan (interpreted) Python döngüsü bu optimizasyonlardan yararlanamaz.
3. İleri yayılım formülünde z^(l) = a^(l-1) W^(l) + b^(l) yazılırken, a^(l-1) terimi ne anlama gelir?
- Rastgele bir başlangıç değeri
- Bir ÖNCEKİ katmanın çıktısı (aktivasyonu) -- şu anki katmanın girdisi olarak kullanılır (doğru cevap)
- Modelin son çıktısı
- Kayıp fonksiyonunun değeri
Neden: a^(l-1), bir önceki katmanın aktivasyon çıktısıdır; ileri yayılımın sıralı yapısı gereği, her katman bir öncekinin çıktısını kendi girdisi olarak kullanır.
Özet
Özet
- İleri yayılım, bir girdinin katmanlardan sırayla geçerek bir tahmine dönüşme sürecidir.
- Her katman aynı formülü tekrarlar: girdiyi ağırlıklarla çarp, bias ekle, aktivasyon fonksiyonundan geçir.
- Gerçek sistemler, tek tek örnekler yerine TÜM bir grubu (batch) tek bir matris çarpımıyla işler.
- Vektörleştirilmiş matris işlemleri, Python döngülerinden onlarca-yüzlerce kat daha hızlıdır.
- İleri yayılım, eğitilmiş bir modelin yeni tahminler üretirken yaptığı TEK işlemdir.