

Transfer öğrenme
Önkoşul:Veri artırma
Kanca
- derste ResNet’in ImageNet’te (1000 sınıf, milyonlarca görsel) haftalarca eğitildiğini gördük. Kendi küçük problemin için AYNI süreci tekrarlamana gerek yok — transfer öğrenme, bu “öğrenilmiş görme bilgisini” yeniden kullanmanı sağlıyor.
Sezgi
Transfer öğrenme, büyük bir veri setinde önceden eğitilmiş bir modeli alıp, KENDİ (genelde çok daha küçük) problemine uyarlamaktır. Fikir: bir ağın erken katmanlarının öğrendiği kenar/doku/şekil algılama becerisi, hemen hemen HER görsel probleminde faydalıdır — bu yüzden sıfırdan öğrenmeye gerek yok.
Mekanizma
torchvision.models, ResNet gibi mimarileri (genelde ImageNet üzerinde önceden eğitilmiş ağırlıklarla) hazır sunar:
Hazır bir mimariyi yüklemek
# 31. derste ResNet'i tanımıştık. torchvision, bu mimarileri HAZIR sunar --
# genelde milyonlarca ImageNet görseliyle ÖNCEDEN eğitilmiş ağırlıklarla birlikte.
model = models.resnet18(weights=None)  # NOT: gerçek kullanımda weights="IMAGENET1K_V1" ile önceden eğitilmiş ağırlıklar indirilir
toplam_param = sum(p.numel() for p in model.parameters())
print(f"ResNet18 toplam parametre sayısı: {toplam_param:,}")
print("Bu ağ, ImageNet'te (1000 sınıf, 1M+ görsel) haftalarca GPU süresiyle eğitilmiştir.")
print("Transfer öğrenmenin fikri: bu 'öğrenilmiş görme bilgisini' SIFIRDAN eğitmeden yeniden kullanmak.")
ResNet18 toplam parametre sayısı: 11,689,512
Bu ağ, ImageNet'te (1000 sınıf, 1M+ görsel) haftalarca GPU süresiyle eğitilmiştir.
Transfer öğrenmenin fikri: bu 'öğrenilmiş görme bilgisini' SIFIRDAN eğitmeden yeniden kullanmak.İlk strateji — “feature extraction”: TÜM ağı dondurup SADECE son katmanı değiştirmek.
Ağı dondurup son katmanı değiştirmek
# Strateji 1 (feature extraction): TÜM ağı dondur, sadece son katmanı değiştirip eğit.
for parametre in model.parameters():
    parametre.requires_grad = False  # gradyan hesaplanmasın -- ağırlıklar SABİT kalsın

print(f"\nOrijinal son katman: {model.fc}")
model.fc = nn.Linear(model.fc.in_features, 5)  # kendi problemimiz için: 5 sınıf
print(f"Yeni son katman (5 sınıf için): {model.fc}")

egitilebilir = sum(p.numel() for p in model.parameters() if p.requires_grad)
print(f"\nEğitilebilir parametre sayısı: {egitilebilir:,} (toplamın sadece %{100*egitilebilir/toplam_param:.3f}'i)")
print("Yeni katman rastgele başlatıldığı için varsayılan olarak requires_grad=True -- geri kalan HER ŞEY dondurulmuş durumda.")
Orijinal son katman: Linear(in_features=512, out_features=1000, bias=True)
Yeni son katman (5 sınıf için): Linear(in_features=512, out_features=5, bias=True)

Eğitilebilir parametre sayısı: 2,565 (toplamın sadece %0.022'i)
Yeni katman rastgele başlatıldığı için varsayılan olarak requires_grad=True -- geri kalan HER ŞEY dondurulmuş durumda.
Eğitilebilir parametre sayısı, 11.7 milyonun sadece %0.022’sine iniyor! Çoğu kişi “transfer öğrenme, tüm ağı yeniden eğitmek” sanır. Yanlış, çünkü en yaygın strateji, ağın ÖĞRENDİKLERİNİ SABİT tutup sadece yeni bir “karar katmanı” eklemektir.
Matematik
requires_grad: dondurma mekanizması
| Strateji | Ne dondurulur | Eğitilebilir oran |
|---|---|---|
| Feature extraction | Sınıflandırıcı DIŞINDA her şey | Çok düşük (~%0.02) |
| Fine-tuning (kısmi) | Sadece erken katmanlar | Orta (~%70+) |
| Sıfırdan eğitim | Hiçbir şey | %100 |
requires_grad=False, PyTorch’a o parametre için gradyan HESAPLAMAMASINI söyler — bu hem hesaplamayı hızlandırır hem de o ağırlığın değişmeden KALMASINI garanti eder.
Kod
Dondurmayı KISMEN geri alıp “fine-tuning” stratejisini deneyelim, sonra ağın hâlâ doğru çalıştığını doğrulayalım:
Fine-tuning: son bloğu çözmek
# Strateji 2 (fine-tuning): dondurmayı KISMEN geri al -- son bloğu da eğitilebilir yap.
for parametre in model.layer4.parameters():
    parametre.requires_grad = True

egitilebilir_ince_ayar = sum(p.numel() for p in model.parameters() if p.requires_grad)
print(f"\nSon blok + sınıflandırıcı çözüldükten sonra eğitilebilir parametre: {egitilebilir_ince_ayar:,}")
print(f"Toplamın %{100*egitilebilir_ince_ayar/toplam_param:.2f}'i artık eğitilebilir.")
print("\nFeature extraction: HIZLI, AZ veri gerektirir, ama esneklik düşük.")
print("Fine-tuning: DAHA YAVAŞ, daha fazla veri ister, ama probleme daha iyi UYUM sağlayabilir.")
Son blok + sınıflandırıcı çözüldükten sonra eğitilebilir parametre: 8,396,293
Toplamın %71.83'i artık eğitilebilir.

Feature extraction: HIZLI, AZ veri gerektirir, ama esneklik düşük.
Fine-tuning: DAHA YAVAŞ, daha fazla veri ister, ama probleme daha iyi UYUM sağlayabilir.
Değiştirilmiş ağ hâlâ çalışıyor mu?
# Değiştirilmiş ağın hâlâ çalıştığını doğrulayalım.
girdi = torch.randn(1, 3, 224, 224)  # tek bir 'sahte' RGB görsel
cikis = model(girdi)
print(f"\nÖrnek girdi ({tuple(girdi.shape)}) ile çıkış şekli: {tuple(cikis.shape)}")
print("Çıkış artık 1000 değil, 5 boyutlu -- ResNet'in 'görme becerisini' kendi 5-sınıflı problemimize UYARLADIK.")
Örnek girdi ((1, 3, 224, 224)) ile çıkış şekli: (1, 5)
Çıkış artık 1000 değil, 5 boyutlu -- ResNet'in 'görme becerisini' kendi 5-sınıflı problemimize UYARLADIK.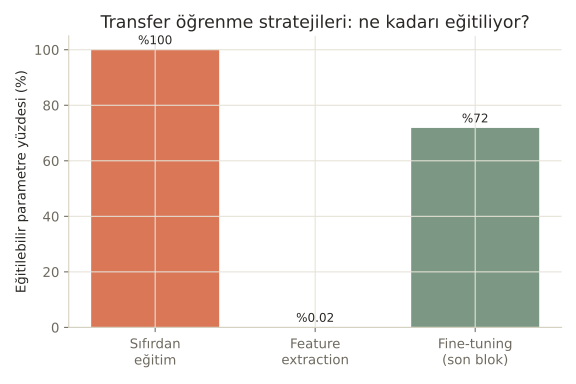
Nerede işe yarar
Transfer öğrenme, özellikle SINIRLI veri veya hesaplama gücüyle çalışırken standart pratiktir:
- Az veri varsa (yüzlerce-binlerce görsel) feature extraction tercih edilir — az parametre eğitildiği için aşırı öğrenme (21-22. ders) riski düşüktür.
- Daha fazla veri varsa fine-tuning daha iyi sonuç verebilir — ağ, probleme daha ÖZGÜ hale gelir.
- 32. dersteki veri artırma, transfer öğrenmeyle SIK sık birlikte kullanılır — ikisi de az veriyle iyi genelleme sağlamayı hedefler.
Bu 3 hatayı yaparsın:
requires_grad = Falseayarlamadan “dondurduğunu” sanmak — bu satır olmadan TÜM ağ eğitilmeye devam eder.- Son katmanı DEĞİŞTİRMEYİ unutup, orijinal 1000 sınıflık çıktıyı kendi 5 sınıflı problemine zorla uydurmaya çalışmak.
- Çok küçük bir veri setiyle TÜM ağı fine-tune etmeye çalışıp, önceden öğrenilmiş faydalı bilgiyi “unutturmak” (catastrophic forgetting).
Kendini test et
1. Notebook'ta feature extraction stratejisinde eğitilebilir parametre oranı neden sadece %0.022 çıktı?
- Model bozuktu
- TÜM parametrelerin requires_grad'ı False yapıldı, sadece YENİ eklenen son katman (5 sınıflık) varsayılan olarak eğitilebilir kaldı (doğru cevap)
- ResNet18 zaten çok az parametre içerir
- PyTorch parametrelerin çoğunu otomatik dondurur
Neden: requires_grad=False döngüsü TÜM parametreleri dondurdu; sadece SONRADAN eklenen yeni nn.Linear katmanı (rastgele başlatıldığı için varsayılan olarak requires_grad=True) eğitilebilir kaldı -- bu da toplamın çok küçük bir kısmı.
2. Feature extraction ile fine-tuning stratejileri arasındaki temel fark nedir?
- İkisi de aynı şeydir
- Feature extraction neredeyse tüm ağı dondurur (sadece yeni katman eğitilir); fine-tuning bazı önceden eğitilmiş katmanları da çözüp eğitilebilir yapar (doğru cevap)
- Fine-tuning her zaman daha hızlıdır
- Feature extraction sadece görüntülerde çalışır
Neden: Feature extraction, önceden öğrenilmiş TÜM özellikleri sabit tutup sadece yeni bir sınıflandırıcı ekler; fine-tuning bu dondurmayı kısmen geri alıp bazı katmanların da probleme özgü şekilde güncellenmesine izin verir.
3. Neden çok küçük bir veri setiyle TÜM ağı (fine-tuning ile) eğitmek riskli olabilir?
- Hiçbir riski yoktur
- Az veriyle çok fazla parametre eğitmek aşırı öğrenmeye (21-22. ders) yol açabilir VE önceden öğrenilmiş faydalı bilgiyi bozabilir (catastrophic forgetting) (doğru cevap)
- Model çok yavaş çalışır
- PyTorch bunu engeller
Neden: Küçük veri setleriyle milyonlarca parametreyi eğitmek, 21-22. dersteki aşırı öğrenme riskini artırır; ayrıca büyük güncellemeler, önceden eğitilmiş ağırlıkların taşıdığı faydalı genel bilgiyi 'unutturabilir'.
Özet
Özet
- Transfer öğrenme, önceden eğitilmiş bir modeli kendi (genelde küçük) problemine uyarlamaktır.
- requires_grad=False, bir parametreyi "dondurup" gradyan hesaplanmasını ve güncellenmesini engeller.
- Feature extraction: neredeyse tüm ağı dondurup sadece yeni bir sınıflandırıcı katmanı eğitmek.
- Fine-tuning: dondurmayı kısmen geri alıp bazı katmanları da probleme özgü şekilde eğitmek.
- Az veriyle feature extraction, daha fazla veriyle fine-tuning genelde daha iyi sonuç verir.