

AdaBoost
Önkoşul:Random Forest
Kanca
19-20. derste bagging ve Random Forest’ı gördük — ağaçlar birbirinden BAĞIMSIZ, PARALEL olarak kuruluyordu. Ya bunun yerine, her yeni ağaç bir öncekinin HATALARINI görüp onlara odaklansa?
Sezgi
Boosting, modelleri SIRAYLA kurar — her yeni model, bir öncekinin yanlış yaptığı örneklere daha çok DİKKAT eder. AdaBoost (Adaptive Boosting), bunu somut bir şekilde yapar: her turda, yanlış sınıflandırılan örneklerin AĞIRLIĞINI artırır, böylece bir sonraki zayıf model bu “zor” örneklere odaklanmaya zorlanır.
Burada kullanılan model genelde bir karar kütüğü (decision stump) — sadece TEK bir bölünme yapan, en sığ karar ağacı. Tek başına çok zayıf bir model, ama AdaBoost onlarca kütüğü akıllıca birleştirerek çok güçlü bir sınıflandırıcı oluşturur.
Mekanizma
İç içe daire verisiyle (13-14. dersten hatırla) ilerleyelim:
İç içe daire verisi
# İç içe daireler -- 13/14. dersten hatırla, düz bir sınırla ayrılamıyor.
n = 200
aci = rng.uniform(0, 2 * np.pi, n)
ic_yaricap = 0.5 + rng.normal(0, 0.15, n // 2)
dis_yaricap = 2.0 + rng.normal(0, 0.2, n // 2)
X = np.vstack([
    np.column_stack([ic_yaricap * np.cos(aci[:n // 2]), ic_yaricap * np.sin(aci[:n // 2])]),
    np.column_stack([dis_yaricap * np.cos(aci[n // 2:]), dis_yaricap * np.sin(aci[n // 2:])]),
])
y = np.array([0] * (n // 2) + [1] * (n // 2))
print(f"{n} nokta, iç içe iki daire")
200 nokta, iç içe iki daireTek bir karar kütüğü
# Bir "karar kütüğü" (decision stump): sadece TEK bir bölünme yapan, en sığ karar ağacı.
stump = DecisionTreeClassifier(max_depth=1, random_state=1)
skor_stump = cross_val_score(stump, X, y, cv=5).mean()
print(f"Tek bir karar kütüğü (max_depth=1), çapraz doğrulama doğruluğu: {skor_stump:.3f}")
print("Rastgele tahminden (0.5) biraz iyi ama zayıf -- tek bir eksen bölünmesi, dairesel yapıyı yakalayamaz.")
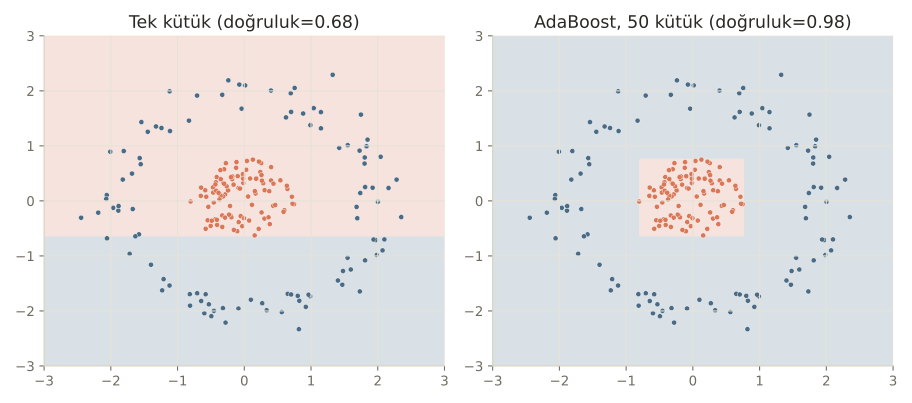
Tek bir karar kütüğü (max_depth=1), çapraz doğrulama doğruluğu: 0.680
Rastgele tahminden (0.5) biraz iyi ama zayıf -- tek bir eksen bölünmesi, dairesel yapıyı yakalayamaz.%68 doğruluk — rastgeleden (%50) biraz iyi ama zayıf. Şimdi AdaBoost’un çekirdek mekanizmasını, ağırlık güncellemesini, elle görelim:
Örnek ağırlıklarının güncellenmesi
# AdaBoost'un çekirdek fikri: yanlış sınıflandırılan noktaların AĞIRLIĞINI artır, sıradaki
# zayıf öğrenici bu noktalara daha çok odaklansın.
stump.fit(X, y)
tahmin = stump.predict(X)
yanlis = tahmin != y
agirlikli_hata = yanlis.mean()
alfa = 0.5 * np.log((1 - agirlikli_hata) / agirlikli_hata)
print(f"\nİlk kütüğün hata oranı: {agirlikli_hata:.3f}")
print(f"Bu kütüğe verilen 'güven' ağırlığı (alfa): {alfa:.3f}")

agirliklar = np.full(n, 1 / n)
agirliklar[yanlis] *= np.exp(alfa)
agirliklar[~yanlis] *= np.exp(-alfa)
agirliklar /= agirliklar.sum()
print(f"Yanlış sınıflandırılan noktaların ORTALAMA yeni ağırlığı: {agirliklar[yanlis].mean():.5f}")
print(f"Doğru sınıflandırılan noktaların ORTALAMA yeni ağırlığı:  {agirliklar[~yanlis].mean():.5f}")
print("Yanlış sınıflandırılanların ağırlığı belirgin şekilde arttı -- sıradaki kütük onlara odaklanacak.")
İlk kütüğün hata oranı: 0.285
Bu kütüğe verilen 'güven' ağırlığı (alfa): 0.460
Yanlış sınıflandırılan noktaların ORTALAMA yeni ağırlığı: 0.00877
Doğru sınıflandırılan noktaların ORTALAMA yeni ağırlığı:  0.00350
Yanlış sınıflandırılanların ağırlığı belirgin şekilde arttı -- sıradaki kütük onlara odaklanacak.
Yanlış sınıflandırılan noktaların ortalama ağırlığı (0.00877), doğru sınıflandırılanlardan (0.00350) 2.5 kat daha yüksek çıktı — bir sonraki kütük, eğitilirken bu ağırlıklı örnekleme göre “zor” noktalara daha çok önem verecek. Şimdi 50 kütüğü tam AdaBoost ile birleştirelim:
Tam AdaBoost topluluğu
ada = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1), n_estimators=50, random_state=1)
ada.fit(X, y)
skor_ada = cross_val_score(ada, X, y, cv=5).mean()
print(f"\n50 kütüğün AdaBoost topluluğu, çapraz doğrulama doğruluğu: {skor_ada:.3f}")
print(f"Tek kütükten ({skor_stump:.3f}) {skor_ada / skor_stump:.2f} kat daha iyi.")
50 kütüğün AdaBoost topluluğu, çapraz doğrulama doğruluğu: 0.985
Tek kütükten (0.680) 1.45 kat daha iyi.
%98.5 doğruluk — tek kütükten 1.45 kat daha iyi! Çoğu kişi “zayıf modelleri birleştirmek, en fazla ortalama bir sonuç verir” sanır. Değil, çünkü AdaBoost’taki modeller BAĞIMSIZ değil, birbirinin HATALARINI düzeltmek üzere TASARLANMIŞ — her kütük, öncekinin bıraktığı boşluğu doldurmaya odaklanıyor, bu da toplamda çok güçlü bir sınıflandırıcı ortaya çıkarıyor.
Matematik
AdaBoost'un ağırlıklandırma formülü
| Sembol | Anlamı |
|---|---|
| ‘inci kütüğün AĞIRLIKLI hata oranı | |
| O kütüğe verilen “güven” ağırlığı — düşük hatalı kütükler daha yüksek alır | |
| Yanlış sınıflandırılan bir örneğin ağırlığı ARTAR | |
| Doğru sınıflandırılan bir örneğin ağırlığı AZALIR |
Nihai tahmin, tüm kütüklerin ile ağırlıklandırılmış oylarının toplamıdır — daha güvenilir (düşük hatalı) kütükler, nihai kararda daha fazla söz sahibi olur.
Kod
Kütük sayısının etkisine bakalım:
Kütük sayısının etkisi
for n_est in [1, 5, 20, 50, 100]:
    m = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1), n_estimators=n_est, random_state=1)
    skor = cross_val_score(m, X, y, cv=5).mean()
    print(f"n_estimators={n_est:<4} çapraz doğrulama doğruluğu: {skor:.3f}")
print("Her yeni kütük, öncekilerin ZAYIF kaldığı noktalara odaklanarak ormanın toplam gücünü artırıyor.")
n_estimators=1 çapraz doğrulama doğruluğu: 0.680
n_estimators=5 çapraz doğrulama doğruluğu: 0.855
n_estimators=20 çapraz doğrulama doğruluğu: 0.985
n_estimators=50 çapraz doğrulama doğruluğu: 0.985
n_estimators=100 çapraz doğrulama doğruluğu: 0.985
Her yeni kütük, öncekilerin ZAYIF kaldığı noktalara odaklanarak ormanın toplam gücünü artırıyor.1 kütükten 20 kütüğe çıkarken doğruluk 0.680’den 0.985’e fırlıyor, sonra düzleşiyor.
Nerede işe yarar
AdaBoost, özellikle basit modellerin birleşiminden güçlü sonuçlar almak istediğinde kullanılır:
- Zayıf ama hızlı modellerden güçlü bir sınıflandırıcı kurmak. Karar kütükleri gibi çok basit modeller, tek tek ucuz ama BİRLİKTE çok güçlü hale gelir.
- Yüz tanıma gibi klasik bilgisayarlı görü uygulamaları. AdaBoost, Viola-Jones yüz tespit algoritmasının temelini oluşturan tarihi bir başarı hikâyesine sahiptir.
- Gradient Boosting’in (22. ders) kavramsal atası. AdaBoost’u anlamak, çok daha yaygın kullanılan Gradient Boosting, XGBoost, LightGBM gibi yöntemlerin (23-24. ders) mantığını kavramayı kolaylaştırır.
Bu 3 hatayı yaparsın:
- AdaBoost’u Random Forest gibi PARALEL bir yöntem sanmak — AdaBoost SIRALI çalışır, her model bir öncekine bağımlıdır, bu yüzden paralelleştirilmesi zordur.
- Gürültülü (aykırı değerli) verilerde dikkatsizce AdaBoost kullanmak — yanlış sınıflandırılan aykırı değerlerin ağırlığı SÜREKLİ artabilir, bu da modelin onlara aşırı odaklanmasına (aşırı öğrenme) yol açabilir.
- Kütük sayısını gereksiz yere çok artırmak — bu derste gördüğümüz gibi, bir noktadan sonra (burada ~20) ekstra kütükler neredeyse hiçbir şey katmıyor.
Kendini test et
1. AdaBoost, bagging/Random Forest'tan (19-20. ders) temel olarak nasıl farklıdır?
- AdaBoost sadece regresyon problemlerinde çalışır
- AdaBoost, modelleri SIRAYLA kurar ve her yeni model bir öncekinin hatalarına (yanlış sınıflandırılan örneklere) odaklanır; bagging modelleri BAĞIMSIZ ve PARALEL kurar (doğru cevap)
- AdaBoost her zaman tek bir model kullanır
- Aralarında hiçbir fark yoktur
Neden: Bagging/Random Forest'taki modeller birbirinden bağımsız ve paralel kurulurken, AdaBoost'taki modeller sıralıdır -- her biri bir öncekinin yanlış sınıflandırdığı örneklere daha fazla ağırlık vererek eğitilir.
2. Notebook'ta yanlış sınıflandırılan noktaların ağırlığı neden arttı?
- Rastgele bir işlemdi
- AdaBoost, bir sonraki zayıf öğreniciyi bu "zor" noktalara odaklanmaya zorlamak için onların ağırlığını kasıtlı olarak artırır (doğru cevap)
- Bu noktalar veri setinden çıkarılacaktı
- Ağırlık artışı bir hataydı
Neden: AdaBoost'un çekirdek mekanizması budur: yanlış sınıflandırılan örneklerin ağırlığını artırarak, sonraki modelin bu örnekleri doğru sınıflandırmaya öncelik vermesini sağlar.
3. Tek bir karar kütüğü (%68 doğruluk) ile 50 kütüğün AdaBoost'u (%98.5 doğruluk) arasındaki farkı en iyi ne açıklar?
- Sadece daha fazla veri kullanıldı
- Her kütük, öncekilerin zayıf kaldığı noktalara odaklanarak birlikte, tek başına hiçbirinin yakalayamayacağı karmaşık (dairesel) bir sınırı yaklaşık olarak öğrenebildi (doğru cevap)
- Kütük sayısı arttıkça veri seti değişti
- Tesadüf
Neden: Her kütük tek başına sadece düz bir çizgi çizebilir, ama art arda eklenen ve önceki hatalara odaklanan çok sayıda kütük, birlikte dairesel sınırı yaklaşık olarak öğrenebiliyor.
Özet
Özet
- AdaBoost, zayıf öğrenicileri (genelde karar kütükleri) SIRAYLA kurarak güçlü bir sınıflandırıcı oluşturur.
- Her turda, yanlış sınıflandırılan örneklerin ağırlığı artırılır -- bir sonraki model bu zor örneklere odaklanır.
- Her modele, hata oranına göre bir "güven" ağırlığı (alfa) verilir; nihai tahmin bu ağırlıklı oyların toplamıdır.
- Bagging/Random Forest'tan farklı olarak modeller PARALEL değil, SIRALI ve birbirine BAĞIMLI kurulur.
- Kütük sayısı arttıkça performans hızla yükselir ama bir noktadan sonra düzleşir.