

LightGBM
Önkoşul:XGBoost
Kanca
- derste XGBoost’un sklearn’den hızlı olduğunu gördük. LightGBM, adının içinde “hafif” (light) kelimesini taşıyor — ve daha da büyük veri setlerinde bu farkı hissettiriyor. Ama hız, NEREDEN geliyor?
Sezgi
LightGBM’in temel farkı, ağaçları nasıl BÜYÜTTÜĞÜ. XGBoost (varsayılan olarak) seviye bazlı büyür — her seviyedeki TÜM düğümleri böler, ağaç simetrik kalır. LightGBM ise yaprak bazlı büyür — her seferinde, kaybı EN ÇOK azaltacak TEK yaprağı böler, ağaç asimetrik ve derinliği dengesiz olabilir ama daha AZ hesaplamayla daha DÜŞÜK kayba ulaşır.
Ayrıca LightGBM, kategorik öznitelikleri (şehir, kategori gibi metin/etiket verisi) ELLE sayısala çevirmeden (one-hot encoding olmadan) doğrudan işleyebilir — bu da hem hız hem kullanım kolaylığı kazandırır.
Mekanizma
Daha büyük bir veri setinde hız farkını ölçelim:
20.000 satırlık veri
# XGBoost'tan (2000 satır) daha büyük bir veri seti -- LightGBM'in hız avantajı büyük veride belirginleşir.
n = 20000
yas = rng.uniform(18, 65, n)
gelir = rng.uniform(3, 25, n)
gurultu = rng.normal(0, 1, size=(n, 5))
skor = (yas - 40) / 15 + (gelir - 12) / 8 + rng.normal(0, 0.6, n)
satin_aldi = (skor > 0).astype(int)
X = np.column_stack([yas, gelir, gurultu])
print(f"{n} müşteri, {X.shape[1]} öznitelik")
20000 müşteri, 7 öznitelikHız karşılaştırması
baslangic = perf_counter()
xgb = XGBClassifier(n_estimators=200, max_depth=6, random_state=21, eval_metric="logloss")
skor_xgb = cross_val_score(xgb, X, satin_aldi, cv=3).mean()
sure_xgb = perf_counter() - baslangic

baslangic = perf_counter()
lgbm = LGBMClassifier(n_estimators=200, max_depth=6, random_state=21, verbose=-1)
skor_lgbm = cross_val_score(lgbm, X, satin_aldi, cv=3).mean()
sure_lgbm = perf_counter() - baslangic

print(f"XGBoost:  doğruluk={skor_xgb:.3f}, süre={sure_xgb:.2f}s")
print(f"LightGBM: doğruluk={skor_lgbm:.3f}, süre={sure_lgbm:.2f}s")
print(f"LightGBM {sure_xgb / sure_lgbm:.1f}x daha hızlı -- {n} satırlık veride fark belirginleşiyor.")
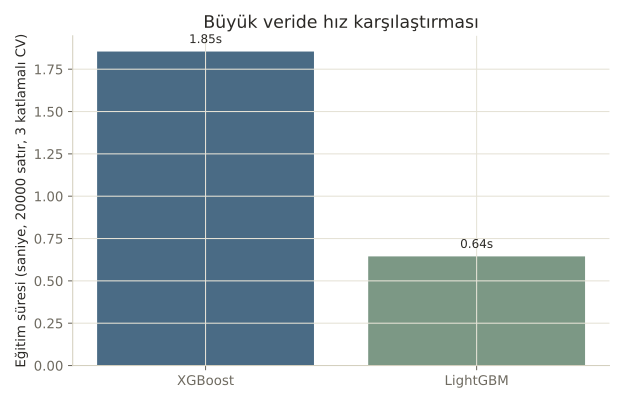
XGBoost: doğruluk=0.850, süre=1.85s
LightGBM: doğruluk=0.862, süre=0.64s
LightGBM 2.9x daha hızlı -- 20000 satırlık veride fark belirginleşiyor.LightGBM, XGBoost’tan 2.9 kat hızlı — ve doğrulukta bile hafif bir iyileşme var (0.862 vs 0.850)! Şimdi yaprak-bazlı büyümenin somut etkisine bakalım:
Yaprak bazlı büyümenin etkisi
# LightGBM varsayılan olarak YAPRAK BAZLI büyür (en çok kaybı azaltan yaprağı böl),
# XGBoost varsayılan olarak SEVİYE BAZLI büyür (aynı seviyedeki tüm düğümleri böl).
# Bu, aynı düğüm sayısıyla LightGBM'in genelde daha DERİN, dengesiz ağaçlar üretmesi demektir.
lgbm_yaprak = LGBMClassifier(n_estimators=100, num_leaves=31, random_state=21, verbose=-1)
lgbm_yaprak.fit(X, satin_aldi)
agac_0 = lgbm_yaprak.booster_.dump_model()["tree_info"][0]

def derinlik_bul(dugum, mevcut=0):
    if "split_index" not in dugum:
        return mevcut
    sol = derinlik_bul(dugum["left_child"], mevcut + 1)
    sag = derinlik_bul(dugum["right_child"], mevcut + 1)
    return max(sol, sag)

derinlik = derinlik_bul(agac_0["tree_structure"])
print(f"\nLightGBM'in ilk ağacı: num_leaves=31 sınırıyla {derinlik} seviye derinliğe ulaştı")
print("(seviye-bazlı büyüseydi, 31 yaprağa ulaşmak için sabit ~5 seviye gerekirdi -- yaprak-bazlı büyüme dengesiz derinlikler üretebilir).")
LightGBM'in ilk ağacı: num_leaves=31 sınırıyla 6 seviye derinliğe ulaştı
(seviye-bazlı büyüseydi, 31 yaprağa ulaşmak için sabit ~5 seviye gerekirdi -- yaprak-bazlı büyüme dengesiz derinlikler üretebilir).
num_leaves=31 sınırıyla, ağaç 6 seviye derinliğe ulaştı — seviye-bazlı büyüseydi, 31 yaprağa ulaşmak için sabit ~5 seviye yeterdi. Çoğu kişi “daha dengesiz bir ağaç, daha kötü bir ağaçtır” sanır. Burada tersi, çünkü LightGBM, hesaplama bütçesini (yaprak sayısı sınırı) EN ÇOK fayda sağlayacak dallara harcıyor — simetriden feragat ederek daha verimli bir kayıp azaltımı elde ediyor.
Matematik
Seviye bazlı vs yaprak bazlı büyüme
| Strateji | Avantajı | Riski |
|---|---|---|
| Seviye bazlı (XGBoost varsayılanı) | Dengeli, öngörülebilir ağaç yapısı | Bazı bölünmeler az fayda sağlasa da yine de yapılır |
| Yaprak bazlı (LightGBM varsayılanı) | Aynı yaprak sayısıyla daha düşük kayıp | Küçük veri setlerinde aşırı öğrenmeye daha yatkın olabilir |
Yaprak bazlı büyüme, “hesaplama bütçeni en çok fayda sağlayan yere harca” prensibiyle çalışır — bu yüzden LightGBM genelde AYNI yaprak sayısıyla XGBoost’tan daha düşük eğitim kaybına ulaşır, ama küçük veri setlerinde bu esneklik aşırı öğrenmeye yol açabileceğinden num_leaves ve min_child_samples gibi parametrelerle dikkatli sınırlanmalıdır.
Kod
Son olarak, kategorik öznitelik desteğini deneyelim:
Kategorik öznitelik desteği
# LightGBM, kategorik öznitelikleri ELLE one-hot encode etmeden DOĞRUDAN kullanabilir.
sehirler = rng.choice(["Istanbul", "Ankara", "Izmir", "Bursa"], size=n)
df = pd.DataFrame({"yas": yas, "gelir": gelir, "sehir": pd.Categorical(sehirler)})

lgbm_kategorik = LGBMClassifier(n_estimators=100, random_state=21, verbose=-1)
skor_kategorik = cross_val_score(lgbm_kategorik, df, satin_aldi, cv=3).mean()
print(f"\nLightGBM, 'sehir' kategorik özniteliğini one-hot encode ETMEDEN kullandı: doğruluk={skor_kategorik:.3f}")
print("XGBoost/scikit-learn'de bu öznitelik önce sayısala çevrilmeliydi (15. veri bilimi dersini hatırla).")
LightGBM, 'sehir' kategorik özniteliğini one-hot encode ETMEDEN kullandı: doğruluk=0.863
XGBoost/scikit-learn'de bu öznitelik önce sayısala çevrilmeliydi (15. veri bilimi dersini hatırla).
sehir sütunu hiç sayısala çevrilmeden (pd.Categorical olarak bırakılıp) doğrudan modele verildi — LightGBM bunu içeride akıllıca işledi. XGBoost veya sklearn modellerinde bu adım genelde one-hot encoding (15. veri bilimi dersini hatırla) gerektirirdi.
Nerede işe yarar
LightGBM, özellikle ÇOK büyük veri setlerinde ve kategorik özniteliklerin bol olduğu problemlerde tercih edilir:
- Milyonlarca satırlık veriler. Bellek verimliliği ve hız avantajı, veri büyüdükçe daha da belirginleşir.
- Kategorik özniteliği bol olan problemler. E-ticaret (kategori, marka, şehir), reklam (kullanıcı segmenti) gibi alanlarda one-hot encoding’i atlamak hem zaman hem bellek kazandırır.
- Hızlı deney döngüsü gerektiğinde. Çok sayıda hiperparametre kombinasyonunu denemek istediğinde, her eğitimin hızlı olması pratik bir fark yaratır.
Bu 3 hatayı yaparsın:
- Küçük veri setlerinde (birkaç yüz satır) LightGBM’in mutlaka daha iyi olacağını varsaymak — yaprak-bazlı büyüme, küçük verilerde aşırı öğrenmeye daha yatkın olabilir.
num_leavesparametresinimax_depth’le TUTARSIZ ayarlamak — yaprak bazlı büyümedenum_leaves, ağacın karmaşıklığınımax_depth’ten daha doğrudan kontrol eder.- Kategorik öznitelikleri LightGBM’e string olarak değil,
categorytipinde (pandas Categorical) vermeyi unutmak — aksi halde otomatik kategorik işleme devreye girmeyebilir.
Kendini test et
1. LightGBM'in varsayılan "yaprak bazlı" büyüme stratejisi ne anlama gelir?
- Her seviyedeki tüm düğümler aynı anda bölünür
- Her seferinde, kaybı EN ÇOK azaltacak TEK yaprak bölünür -- bu, dengesiz ama daha verimli bir ağaç yapısına yol açabilir (doğru cevap)
- Ağaç hiç büyümez
- Sadece kök düğüm bölünür
Neden: Yaprak bazlı büyüme, XGBoost'un seviye bazlı (dengeli) büyümesinin aksine, her adımda en çok kayıp azaltımı sağlayacak tek yaprağı seçip böler -- bu genelde daha az yaprakla daha düşük kayba ulaşmayı sağlar.
2. Notebook'ta LightGBM'in kategorik 'sehir' özniteliğini kullanma şekli, XGBoost/sklearn'den nasıl farklıydı?
- Aynı şekilde çalıştı, fark yok
- LightGBM, öznitelği one-hot encode etmeden, pandas Categorical tipinde doğrudan kullanabildi (doğru cevap)
- LightGBM kategorik öznitelikleri desteklemiyor
- LightGBM özniteliği tamamen görmezden geldi
Neden: LightGBM, kategorik öznitelikleri (pd.Categorical olarak işaretlendiğinde) içeride akıllıca işleyerek, one-hot encoding gibi ek bir ön işleme adımına gerek bırakmadan doğrudan kullanabilir.
3. 20.000 satırlık veride LightGBM neden XGBoost'tan belirgin şekilde hızlıydı?
- Daha az doğru olduğu için
- Yaprak bazlı büyüme ve optimize edilmiş histogram tabanlı bölünme arama gibi mühendislik iyileştirmeleri, büyük veride hesaplama avantajını belirginleştiriyor (doğru cevap)
- Daha az öznitelik kullandığı için
- Rastgele bir ölçüm hatası
Neden: LightGBM'in mimarisi (yaprak bazlı büyüme, histogram tabanlı bölünme arama gibi) büyük veri setlerinde hesaplama avantajını daha belirgin hale getirir -- bu yüzden fark, küçük veride değil büyük veride ortaya çıkıyor.
Özet
Özet
- LightGBM, ağaçları yaprak bazlı büyütür -- her seferinde en çok fayda sağlayan yaprağı böler, dengeli olmayan ama verimli ağaçlar üretir.
- Bu strateji, özellikle büyük veri setlerinde XGBoost'a göre belirgin bir hız avantajı sağlar.
- LightGBM, kategorik öznitelikleri one-hot encoding olmadan doğrudan işleyebilir.
- Küçük veri setlerinde yaprak bazlı büyüme aşırı öğrenmeye daha yatkın olabilir -- num_leaves gibi parametrelerle dikkatli sınırlanmalıdır.
- LightGBM ile XGBoost arasındaki seçim, çoğu zaman doğruluktan çok veri boyutuna ve hıza bağlıdır.