

Kernel hilesi
Önkoşul:Destek vektör makineleri
Kanca
- derste RBF kernel’in iç içe daireleri ayırdığını gördük ve “veriyi görünmeyen bir üst boyuta taşıyor” dedik. Ama bu tam olarak NASIL çalışıyor? “Hile” kelimesi neden kullanılıyor?
Sezgi
Kernel hilesi, öznitelikleri gerçekten yüksek boyuta TAŞIMADAN, sanki taşınmış gibi sonuç almanın matematiksel bir yoludur. SVM’in optimizasyonu aslında noktalar arasındaki İÇ ÇARPIMLARA ihtiyaç duyar — noktaların kendisine değil. Kernel fonksiyonu, bu iç çarpımı yüksek boyutlu uzayda hesaplarmış gibi bir sonuç verir, ama o yüksek boyutlu koordinatları HİÇ HESAPLAMAZ.
Bunun “hile” olmasının sebebi şu: normalde 2 boyuttan 1000 boyuta geçmek, 1000 yeni sayı hesaplamak demektir. Kernel hilesiyle, bu 1000 boyutun sonucunu, sadece ORİJİNAL 2 boyutlu noktalar üzerinde bir formülle (kernel fonksiyonuyla) elde edersin — ara adımı atlarsın.
Mekanizma
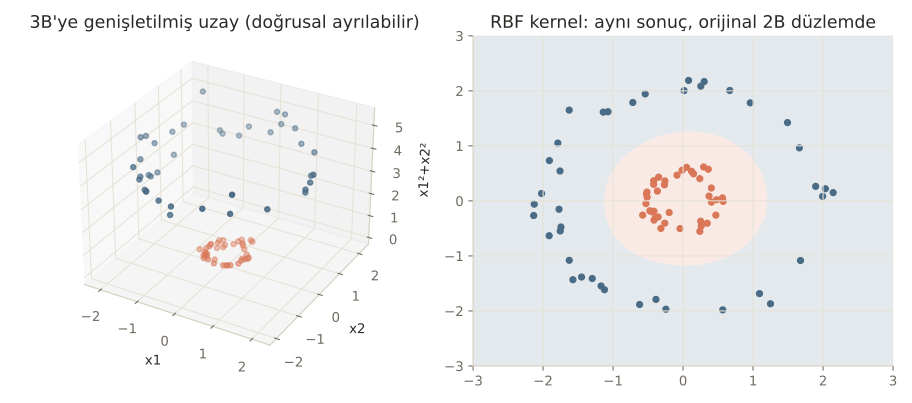
Önce “hileyi” ELLE yapalım — iç içe daire verisine üçüncü bir boyut (yarıçapın karesi) ekleyelim:
İç içe daire verisi
# İç içe iki daire -- 13. dersten hatırla, doğrusal olarak ayrılamıyor.
aci = rng.uniform(0, 2 * np.pi, 80)
ic_yaricap = 0.5 + rng.normal(0, 0.08, 40)
dis_yaricap = 2.0 + rng.normal(0, 0.12, 40)
X = np.vstack([
    np.column_stack([ic_yaricap * np.cos(aci[:40]), ic_yaricap * np.sin(aci[:40])]),
    np.column_stack([dis_yaricap * np.cos(aci[40:]), dis_yaricap * np.sin(aci[40:])]),
])
y = np.array([-1] * 40 + [1] * 40)
print(f"{len(X)} nokta, iç içe iki daire")
80 nokta, iç içe iki daireÖznitelikleri elle genişletmek
# "Kernel hilesi" fikrini ELLE yapalım: (x1, x2) -> (x1, x2, x1^2 + x2^2)
def ozellik_genislet(X):
    yaricap_kare = (X[:, 0] ** 2 + X[:, 1] ** 2).reshape(-1, 1)
    return np.hstack([X, yaricap_kare])

X_genis = ozellik_genislet(X)
print(f"Orijinal boyut: {X.shape[1]}, genişletilmiş boyut: {X_genis.shape[1]}")

model_dogrusal_genis = SVC(kernel="linear", C=1.0)
model_dogrusal_genis.fit(X_genis, y)
dogruluk_genis = accuracy_score(y, model_dogrusal_genis.predict(X_genis))
print(f"3 boyutlu uzayda DOĞRUSAL SVM doğruluğu: {dogruluk_genis:.3f}")
print("Üçüncü boyutu (yarıçapın karesini) ELLE ekleyerek, veriyi doğrusal olarak ayrılabilir hale getirdik.")
Orijinal boyut: 2, genişletilmiş boyut: 3
3 boyutlu uzayda DOĞRUSAL SVM doğruluğu: 1.000
Üçüncü boyutu (yarıçapın karesini) ELLE ekleyerek, veriyi doğrusal olarak ayrılabilir hale getirdik.3 boyutlu uzayda doğrusal SVM %100 doğrulukla ayırıyor. Şimdi AYNI sonucu, hiçbir öznitelik eklemeden, sadece kernel fonksiyonunu değiştirerek elde edelim:
Kernel hilesi ile aynı sonuç
# scikit-learn'ün RBF kernel'i, bu genişletmeyi (ve daha fazlasını) ÖZNİTELİKLERİ HİÇ HESAPLAMADAN yapar.
model_rbf = SVC(kernel="rbf", C=1.0)
model_rbf.fit(X, y)
dogruluk_rbf = accuracy_score(y, model_rbf.predict(X))
print(f"RBF kernel (orijinal 2 boyutlu veri üzerinde) doğruluk: {dogruluk_rbf:.3f}")
print("Aynı sonuç, ama öznitelikleri elle genişletmeden -- kernel fonksiyonu iç çarpımı DOĞRUDAN hesaplıyor.")
RBF kernel (orijinal 2 boyutlu veri üzerinde) doğruluk: 1.000
Aynı sonuç, ama öznitelikleri elle genişletmeden -- kernel fonksiyonu iç çarpımı DOĞRUDAN hesaplıyor.Aynı %100 doğruluk — ama bu sefer veri hiç 3 boyuta taşınmadı! Çoğu kişi “kernel, arka planda özniteliği genişletiyor” sanır. Yarı doğru, ama RBF kernel aslında SONSUZ boyutlu bir uzaya karşılık gelir — bunu elle asla hesaplayamazsın. Kernel fonksiyonu, o sonsuz boyuttaki iç çarpımı, orijinal 2 boyutlu noktalar üzerinde tek bir formülle DOĞRUDAN hesaplıyor.
Matematik
Kernel fonksiyonu, iç çarpımın kısayoludur
| Sembol | Anlamı |
|---|---|
| ‘i yüksek (belki sonsuz) boyutlu bir uzaya taşıyan dönüşüm — HİÇ HESAPLANMAZ | |
| ile ‘nin iç çarpımı — ama SADECE orijinal kullanılarak hesaplanır | |
| RBF’nin “genişliğini” kontrol eden parametre — büyük = daha dar/karmaşık sınırlar |
SVM’in matematiği, veriyi sadece iç çarpımlar aracılığıyla kullanır. Kernel fonksiyonu bu iç çarpımı ÜRETİR — ‘nin kendisini hiç hesaplamadan. Bu, “kernel hilesi” adının kaynağıdır: hesaplaman gereken şeyi asla hesaplamadan, sonucunu elde edersin.
Kod
Bu hilenin bir de pratik hesaplama avantajı var:
Hesaplama verimliliği
# Kernel hilesinin asıl gücü: yüksek boyutlu uzayda İŞLEM YAPMADAN, sadece iç çarpımları hesaplamak.
n_tekrar = 200
baslangic = perf_counter()
for _ in range(n_tekrar):
    SVC(kernel="linear", C=1.0).fit(X_genis, y)
sure_elle = perf_counter() - baslangic

baslangic = perf_counter()
for _ in range(n_tekrar):
    SVC(kernel="rbf", C=1.0).fit(X, y)
sure_kernel = perf_counter() - baslangic

print(f"\nElle genişletilmiş öznitelik (3B) ile {n_tekrar} eğitim: {sure_elle:.3f} saniye")
print(f"RBF kernel hilesi (orijinal 2B) ile {n_tekrar} eğitim: {sure_kernel:.3f} saniye")
print("Bu küçük örnekte fark azdır, ama YÜZLERCE/BİNLERCE boyuta genişleyen problemlerde")
print("kernel hilesi, boyutları hiç hesaplamadan çalıştığı için çok daha verimli hale gelir.")
Elle genişletilmiş öznitelik (3B) ile 200 eğitim: 0.265 saniye
RBF kernel hilesi (orijinal 2B) ile 200 eğitim: 0.226 saniye
Bu küçük örnekte fark azdır, ama YÜZLERCE/BİNLERCE boyuta genişleyen problemlerde
kernel hilesi, boyutları hiç hesaplamadan çalıştığı için çok daha verimli hale gelir.
Bu küçük örnekte fark az ama fikir önemli: özniteliği gerçekten yüzlerce/binlerce boyuta genişletmek pahalıyken, kernel fonksiyonu bunu HİÇ yapmadan sonucu üretir. Farklı kernel’lerin bu veri üzerindeki performansına bakalım:
Farklı kernel seçenekleri
# scikit-learn'de yaygın kernel seçenekleri ve doğrulukları bu veri üzerinde.
for k in ["linear", "poly", "rbf", "sigmoid"]:
    m = SVC(kernel=k, C=1.0)
    m.fit(X, y)
    d = accuracy_score(y, m.predict(X))
    print(f"kernel={k:<10} doğruluk={d:.3f}")
kernel=linear doğruluk=0.750
kernel=poly doğruluk=0.800
kernel=rbf doğruluk=1.000
kernel=sigmoid doğruluk=0.475RBF açık ara en iyisi (%100) — çünkü bu verinin gerçek yapısı (dairesel) RBF’nin doğal biçimine uyuyor. poly (polinom) kısmen işe yarıyor (%80), sigmoid ise bu veri için hiç uygun değil (%47.5, rastgele tahminden bile kötü).
Nerede işe yarar
Kernel hilesi, sadece SVM’e özgü değil, “kernel yöntemleri” adı verilen daha geniş bir ailenin temelidir:
- Doğrusal olmayan ilişkileri, doğrusal araçlarla çözmek. Kernel hilesi, karmaşık bir model tasarlamak yerine, VERİYİ dönüştürerek basit (doğrusal) bir modelin yeterli olmasını sağlar.
- Yüksek/sonsuz boyutlu uzaylarla çalışmak. RBF gibi kernellerin karşılık geldiği uzay sonsuz boyutludur — bu, elle asla erişilemeyecek bir esneklik sağlar.
- Kernel PCA, Gaussian Process gibi diğer yöntemler. Kernel hilesi fikri SVM’in ötesinde, birçok algoritmaya uygulanabilir.
Bu 3 hatayı yaparsın:
- Kernel’i “her zaman RBF kullan, en iyisi odur” diye genellemek — bu derste gördüğümüz gibi, doğru kernel VERİNİN yapısına bağlı;
sigmoidbu veri için çok kötü sonuç verdi. gammaparametresini hiç ayarlamamak — RBF’nin genişliği yanlış ayarlanırsa (çok büyük veya çok küçük), model ya aşırı öğrenir ya da yetersiz kalır (7. dersi hatırla).- Kernel hilesinin “her zaman daha hızlı” olduğunu sanmak — küçük/düşük boyutlu problemlerde elle öznitelik genişletmek bazen daha basit ve anlaşılırdır; kernel hilesinin asıl gücü YÜKSEK boyutlarda ortaya çıkar.
Kendini test et
1. Kernel fonksiyonu tam olarak neyi hesaplar?
- Noktaları yüksek boyutlu uzaya taşır ve orada saklar
- İki noktanın yüksek boyutlu uzaydaki iç çarpımını, o yüksek boyutlu koordinatları hiç hesaplamadan, orijinal noktalar üzerinden DOĞRUDAN hesaplar (doğru cevap)
- Sadece veriyi normalize eder
- Model doğruluğunu artıran rastgele bir dönüşümdür
Neden: SVM'in matematiği sadece iç çarpımlara ihtiyaç duyar; kernel fonksiyonu bu iç çarpımı, yüksek boyutlu koordinatları hiç üretmeden, orijinal noktalar üzerinden bir formülle hesaplar.
2. Notebook'ta elle 3 boyuta genişletme ile RBF kernel neden AYNI doğruluğu (1.000) verdi?
- Tesadüf
- Elle eklenen üçüncü boyut (x1²+x2²), RBF kernel'in ima ettiği dönüşümün BASİT bir örneğidir -- ikisi de veriyi doğrusal olarak ayrılabilir hale getiriyor (doğru cevap)
- RBF kernel de 3 boyut kullanıyor
- İkisi de yanlış sonuç verdi
Neden: Elle eklenen yarıçap-kare özniteliği, dairesel veriyi doğrusal olarak ayrılabilir hale getiriyor; RBF kernel, çok daha genel (sonsuz boyutlu) bir dönüşüm ima ederek benzer (ve daha genel) bir etki yaratıyor.
3. Neden 'sigmoid' kernel bu iç içe daire verisinde çok kötü (%47.5) performans gösterdi?
- Kod hatalıydı
- Her kernel'in ima ettiği dönüşüm farklıdır; sigmoid'in dönüşümü bu verinin dairesel yapısına uygun değil, RBF'inki ise tam uyuyor (doğru cevap)
- Sigmoid her zaman kötü çalışır
- Veri seti çok küçüktü
Neden: Doğru kernel seçimi, verinin altında yatan yapıya bağlıdır -- sigmoid kernel'in ima ettiği dönüşüm bu dairesel örüntüyü yakalamaya uygun değil, bu yüzden RBF'den çok daha kötü sonuç veriyor.
Özet
Özet
- Kernel hilesi, veriyi yüksek boyutlu bir uzaya gerçekten taşımadan, o uzaydaki iç çarpımı doğrudan hesaplar.
- Bu sayede SVM, doğrusal olmayan sınırları, aslında doğrusal bir algoritma kalarak öğrenebilir.
- RBF kernel, sonsuz boyutlu bir uzaya karşılık gelir -- elle asla erişilemeyecek bir esneklik sağlar.
- Farklı kernel'ler farklı dönüşümleri ima eder; doğru seçim verinin yapısına bağlıdır.
- Kernel hilesinin asıl verimlilik avantajı, öznitelik sayısı çok büyüdüğünde ortaya çıkar.