

Destek vektör makineleri
Önkoşul:Dengesiz veri seti
Kanca
Lojistik regresyon (10. ders), iki sınıfı ayıran BİR sınır bulur. Ama sonsuz sayıda sınır iki sınıfı ayırabilir — hangisi “en iyisi”? Destek vektör makinesi (SVM), bu soruya çok net bir cevap veriyor: iki sınıf arasındaki BOŞLUĞU en geniş tutan sınırı seç.
Sezgi
SVM, sadece sınıfları ayırmakla kalmaz — sınırın etrafında mümkün olan en GENİŞ boş bölgeyi (marjin) bırakmaya çalışır. Bu marjinin kenarındaki (ya da içindeki) noktalara destek vektörleri denir — sınırı belirleyen SADECE bu noktalardır, diğer tüm noktalar sınırı hiç etkilemez.
sınıf +1 sınıf -1 destek vektörü (marjin üzerinde/içinde)
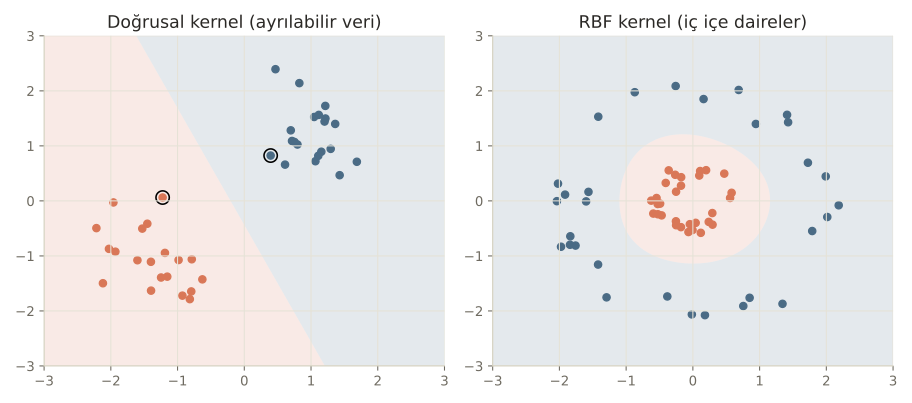
Doğruluk: 100%, destek vektörü sayısı: 2 / 40. Orta C -- marjin genişliği ile uyum arasında bir denge.
C kaydırıcısını değiştir: düşük C geniş bir marjin bırakır (bazı noktalar marjin İÇİNDE kalmasına izin verir — “yumuşak” sınır), yüksek C marjini daraltır (noktalara sıkı sıkıya uyar). “RBF kernel” sekmesine geç: iç içe iki daire, düz bir çizgiyle asla ayrılamaz — ama veriyi görünmeyen bir üçüncü boyuta (x1²+x2²) taşırsak, orada DOĞRUSAL bir sınır bulunabiliyor. Orijinal düzleme geri yansıtıldığında bu, eğri bir sınır gibi görünür.
Mekanizma
Doğrusal olarak ayrılabilir bir veriyle başlayalım:
Doğrusal olarak ayrılabilir veri
n_sinif = 20
sinif_a = rng.normal([-1.2, -1.2], 0.5, size=(n_sinif, 2))
sinif_b = rng.normal([1.2, 1.2], 0.5, size=(n_sinif, 2))
X = np.vstack([sinif_a, sinif_b])
y = np.array([-1] * n_sinif + [1] * n_sinif)
print(f"{len(X)} nokta, iki sınıf, doğrusal olarak ayrılabilir görünüyor")
40 nokta, iki sınıf, doğrusal olarak ayrılabilir görünüyorDoğrusal SVM
model = SVC(kernel="linear", C=1.0)
model.fit(X, y)
print(f"Destek vektörü sayısı: {len(model.support_vectors_)} / {len(X)}")
print(f"Ağırlık vektörü (w): {model.coef_[0].round(3)}")
print(f"Marjin genişliği (2/||w||): {2 / np.linalg.norm(model.coef_[0]):.3f}")
print(f"Eğitim doğruluğu: {accuracy_score(y, model.predict(X)):.3f}")
Destek vektörü sayısı: 2 / 40
Ağırlık vektörü (w): [1.011 0.476]
Marjin genişliği (2/||w||): 1.789
Eğitim doğruluğu: 1.00040 noktadan sadece 2 tanesi destek vektörü — bu 2 nokta sınırı TAMAMEN belirliyor, diğer 38 nokta uzaklaşsa da yaklaşsa da (marjinin dışında kaldığı sürece) sınır DEĞİŞMEZ. Çoğu kişi “model tüm veriyi kullanarak sınırı belirler” sanır. Değil, çünkü SVM’in optimizasyonu sadece marjine EN YAKIN noktalara duyarlıdır — bu da SVM’i, uzaktaki aykırı değerlere karşı doğrusal regresyondan daha dayanıklı yapan özelliktir.
Şimdi C parametresinin etkisine bakalım:
C parametresinin marjine etkisi
for c in [0.01, 1, 100]:
    m = SVC(kernel="linear", C=c)
    m.fit(X, y)
    marjin = 2 / np.linalg.norm(m.coef_[0])
    print(f"C={c:<6}  destek vektörü sayısı={len(m.support_vectors_):<3}  marjin genişliği={marjin:.3f}")
print("C küçükken marjin GENİŞ (çok destek vektörü, yumuşak sınır); C büyükken marjin DAR (az destek vektörü, sıkı sınır).")
C=0.01 destek vektörü sayısı=35 marjin genişliği=4.004
C=1 destek vektörü sayısı=2 marjin genişliği=1.789
C=100 destek vektörü sayısı=2 marjin genişliği=1.789
C küçükken marjin GENİŞ (çok destek vektörü, yumuşak sınır); C büyükken marjin DAR (az destek vektörü, sıkı sınır).C=0.01’de 35 nokta destek vektörü (çok yumuşak, geniş marjin=4.004); C=1’de sadece 2 (dar marjin=1.789). C=100’de sonuç C=1 ile AYNI kalıyor — veri zaten tam ayrılabilir olduğu için, belli bir noktadan sonra C’yi artırmanın etkisi kalmıyor.
Matematik
SVM'in optimizasyon hedefi
| Sembol | Anlamı |
|---|---|
| Marjini GENİŞLETME terimi — küçüldükçe marjin büyür | |
| Menteşe (hinge) kaybı — bir nokta marjinin İÇİNDEYSE veya yanlış sınıflandıysa ceza alır | |
| İki terim arasındaki denge — büyük = hataya az tolerans (dar marjin), küçük = hataya çok tolerans (geniş marjin) |
Bu, 8. dersteki Ridge/Lasso’nun düzenlileştirme mantığıyla aynı aileden: bir “uyum” terimi (hinge kaybı) ile bir “basitlik” terimi () arasında denge kuruyoruz.
Kod
Şimdi düz bir çizgiyle AYRILAMAYAN bir veriye bakalım — iç içe iki daire:
Doğrusal kernel başarısız
# İç içe iki daire -- düz bir çizgiyle AYRILAMAZ.
aci = rng.uniform(0, 2 * np.pi, 60)
ic_yaricap = 0.5 + rng.normal(0, 0.1, 30)
dis_yaricap = 2.0 + rng.normal(0, 0.15, 30)
X_daire = np.vstack([
    np.column_stack([ic_yaricap * np.cos(aci[:30]), ic_yaricap * np.sin(aci[:30])]),
    np.column_stack([dis_yaricap * np.cos(aci[30:]), dis_yaricap * np.sin(aci[30:])]),
])
y_daire = np.array([-1] * 30 + [1] * 30)

model_linear_daire = SVC(kernel="linear", C=1.0)
model_linear_daire.fit(X_daire, y_daire)
dogruluk_linear = accuracy_score(y_daire, model_linear_daire.predict(X_daire))
print(f"Doğrusal kernel, iç içe daire verisinde doğruluk: {dogruluk_linear:.3f}  <- neredeyse rastgele tahmin kadar kötü")
Doğrusal kernel, iç içe daire verisinde doğruluk: 0.733 <- neredeyse rastgele tahmin kadar kötüDoğruluk sadece 0.733 — neredeyse rastgele tahmin kadar kötü. Kernel hilesi (bir sonraki derste detaylı göreceğiz) burada devreye giriyor:
RBF kernel başarılı
model_rbf = SVC(kernel="rbf", C=1.0)
model_rbf.fit(X_daire, y_daire)
dogruluk_rbf = accuracy_score(y_daire, model_rbf.predict(X_daire))
print(f"RBF kernel, aynı veride doğruluk: {dogruluk_rbf:.3f}")
print("RBF çekirdeği, veriyi görünmeyen bir üst boyuta taşıyarak orada DOĞRUSAL bir sınır buluyor.")
RBF kernel, aynı veride doğruluk: 1.000
RBF çekirdeği, veriyi görünmeyen bir üst boyuta taşıyarak orada DOĞRUSAL bir sınır buluyor.RBF kernel ile doğruluk 1.000’e çıktı — veriyi görünmeyen bir üst boyuta taşıyarak orada doğrusal bir sınır buluyor.
Nerede işe yarar
SVM, özellikle orta boyutlu, net ayrımlı problemlerde güçlü bir klasiktir:
- Yüksek boyutlu, az örnekli veriler. Metin sınıflandırma, genetik veri gibi öznitelik sayısının örnek sayısına yakın olduğu durumlarda iyi çalışır.
- Net bir marjin gerektiğinde. Sınıflar arasında belirgin bir boşluk varsa (veya olması bekleniyorsa), SVM’in marjin-maksimize etme mantığı doğal bir uyum sağlar.
- Doğrusal olmayan sınırlar gerektiğinde. RBF gibi kernellerle, karmaşık şekilli sınırları öğrenebilir (bir sonraki derste detaylandıracağız).
Bu 3 hatayı yaparsın:
- Öznitelikleri ölçeklemeden SVM kullanmak — marjin hesaplaması mesafeye dayandığı için, ölçeksiz öznitelikler sonucu çarpıtır (15. veri bilimi dersini hatırla).
- Çok büyük veri setlerinde düz SVM kullanmak — klasik SVM eğitimi büyük veride yavaşlar, bu ölçekte genelde başka yöntemler (17+ derste göreceğimiz ağaç tabanlı yöntemler) tercih edilir.
- C’yi rastgele seçmek — bu derste gördüğümüz gibi C, marjin genişliğini doğrudan etkiler; doğru değer genelde çapraz doğrulamayla (9. ders) bulunur.
Kendini test et
1. SVM, iki sınıfı ayıran sınırı nasıl seçer?
- Rastgele bir sınır seçer
- İki sınıf arasındaki boşluğu (marjin) mümkün olduğunca geniş tutan sınırı seçer (doğru cevap)
- Sadece en yakın iki noktayı birleştirir
- Her zaman düz bir çizgi kullanır
Neden: SVM, sınıfları ayırmakla kalmayıp sınır etrafındaki boş bölgeyi (marjini) maksimize etmeye çalışır -- bu, "en güvenli" ayrım olarak düşünülebilir.
2. Notebook'ta 40 noktadan sadece 2'si destek vektörü çıktı. Bu ne anlama gelir?
- Model sadece bu 2 noktayı kullandı, geri kalanını hiç görmedi
- Sınırı SADECE bu 2 nokta belirliyor -- diğer 38 nokta marjinin dışında olduğu sürece uzaklaşsa/yaklaşsa da sınır değişmez (doğru cevap)
- Diğer 38 nokta yanlış sınıflandırıldı
- Veri seti hatalı
Neden: SVM optimizasyonu sadece marjine en yakın noktalara (destek vektörlerine) duyarlıdır; marjinin dışındaki noktalar sınırın konumunu hiç etkilemez.
3. İç içe iki daire şeklindeki veride doğrusal kernel neden başarısız oldu ama RBF kernel başarılı oldu?
- Doğrusal kernel kodunda hata vardı
- Veri düz bir çizgiyle ayrılamıyor; RBF kernel veriyi görünmeyen bir üst boyuta taşıyarak orada doğrusal bir sınır buluyor (doğru cevap)
- RBF her zaman daha iyi çalışır
- Veri seti çok küçüktü
Neden: İç içe daireler düz bir çizgiyle ayrılamayan klasik bir örnektir; RBF kernel, veriyi (x1²+x2² gibi) yeni bir boyuta taşıyarak orijinal düzlemde eğri görünen ama yeni uzayda doğrusal olan bir sınır buluyor.
Özet
Özet
- SVM, iki sınıf arasındaki marjini (boşluğu) maksimize eden sınırı bulur.
- Sınırı sadece marjine en yakın noktalar (destek vektörleri) belirler -- diğer noktalar etkisizdir.
- C parametresi, marjin genişliği ile hataya tolerans arasındaki dengeyi kontrol eder.
- Doğrusal kernel, sadece doğrusal olarak ayrılabilir veride iyi çalışır.
- RBF gibi kernel'ler, veriyi üst boyuta taşıyarak doğrusal olmayan sınırları öğrenmeyi mümkün kılar.