

Hiyerarşik kümeleme
Önkoşul:Kümeleme başarı metrikleri
Kanca
- derste K-Means için k’yı BAŞTAN seçmemiz gerekiyordu. Ya kümeleri, hepsi tek bir noktadan başlayıp yavaş yavaş birleşerek büyüyen bir AĞAÇ olarak düşünsek — ve k’yı EN SONDA, ağacı istediğimiz yükseklikte “keserek” seçsek?
Sezgi
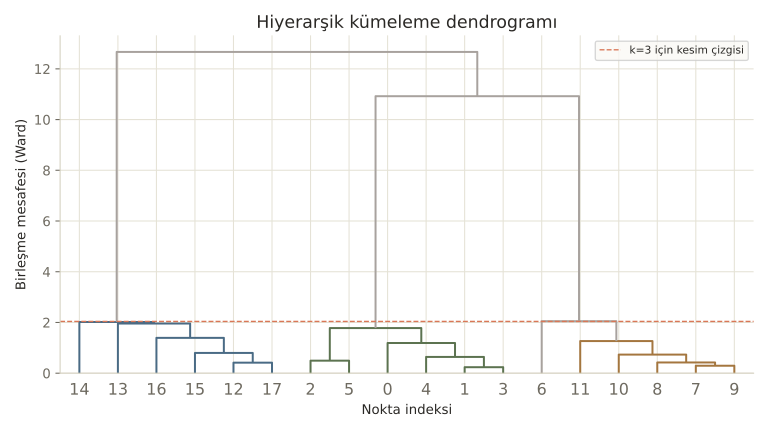
Hiyerarşik kümeleme, her noktayı kendi kümesi olarak başlatır, sonra en YAKIN iki kümeyi adım adım BİRLEŞTİRİR — ta ki tek bir küme kalana kadar. Bu birleşme süreci bir dendrogram (ağaç diyagramı) olarak görselleştirilir. K-Means’in aksine, tek bir “kesin” kümeleme üretmez — TÜM olası k değerlerini içeren bir hiyerarşi üretir, sen sonradan hangi yükseklikte “keseceğine” karar verirsin.
İki küme arasındaki mesafeyi NASIL ölçeceğin (bağlantı/linkage yöntemi) önemli bir seçimdir — ve bu seçim, sonucu gerçekten değiştirebilir.
Mekanizma
Küçük bir veri setiyle birleşme sürecini görelim:
18 noktalık veri
# Küçük bir veri seti -- dendrogramın okunabilir kalması için (27-28. dersteki gibi 3 küme).
merkezler = [(-2, -2), (2, -2), (0, 2.5)]
X_parcalar, gercek_etiketler = [], []
for k, m in enumerate(merkezler):
    X_parcalar.append(rng.normal(m, 0.5, size=(6, 2)))
    gercek_etiketler.append(np.full(6, k))
X = np.vstack(X_parcalar)
gercek_etiketler = np.concatenate(gercek_etiketler)
print(f"{len(X)} nokta -- hiyerarşik kümeleme, K-Means'in aksine ÖNCEDEN k belirtmeni gerektirmez.")
18 nokta -- hiyerarşik kümeleme, K-Means'in aksine ÖNCEDEN k belirtmeni gerektirmez.Birleşme süreci
# K-Means'ten temel fark: hiyerarşik kümeleme, en YAKIN iki kümeyi ADIM ADIM birleştirir,
# tek bir "kesin" kümeleme değil, TÜM birleşme sürecinin bir "ağacını" (dendrogram) üretir.
Z = linkage(X, method="ward")
print(f"Birleşme matrisi şekli: {Z.shape}  ({len(X) - 1} birleşme adımı, {len(X)} nokta için)")
print("İlk 3 birleşme (en YAKIN çiftlerden başlar):")
for satir in Z[:3]:
    print(f"  küme {int(satir[0])} ile küme {int(satir[1])} birleşti, mesafe={satir[2]:.3f}")
Birleşme matrisi şekli: (17, 4) (17 birleşme adımı, 18 nokta için)
İlk 3 birleşme (en YAKIN çiftlerden başlar):
küme 1 ile küme 3 birleşti, mesafe=0.237
küme 7 ile küme 9 birleşti, mesafe=0.294
küme 12 ile küme 17 birleşti, mesafe=0.414Algoritma, EN YAKIN çiftlerden başlayarak (mesafe 0.237, 0.294, 0.414…) adım adım birleşiyor. Şimdi bağlantı yönteminin gerçekten önemli olduğu bir senaryo kuralım — iki kümeyi ince bir nokta “köprüsüyle” birleştirelim:
Bağlantı yöntemlerinin karşılaştırması
# "Bağlantı (linkage)" yöntemi, iki kümenin mesafesinin NASIL ölçüldüğünü belirler.
# İki küme arasında İNCE bir "köprü" bırakan bir veri kuralım -- single-linkage'ın klasik
# zayıflığını (zincirleme/chaining) göstermek için.
kopru_rng = np.random.default_rng(17)
blob_1 = kopru_rng.normal([-3, 0], 0.4, size=(10, 2))
blob_2 = kopru_rng.normal([3, 0], 0.4, size=(10, 2))
kopru = np.column_stack([np.linspace(-2.5, 2.5, 8), kopru_rng.normal(0, 0.15, 8)])
X_kopru = np.vstack([blob_1, blob_2, kopru])
gercek_kopru = np.array([0] * 10 + [1] * 10 + [0] * 4 + [1] * 4)

for yontem in ["single", "complete", "average", "ward"]:
    model = AgglomerativeClustering(n_clusters=2, linkage=yontem)
    etiketler = model.fit_predict(X_kopru)
    ari = adjusted_rand_score(gercek_kopru, etiketler)
    print(f"linkage={yontem:<10} ARI={ari:.3f}")
print("single-linkage, ince köprüdeki noktaları takip ederek iki kümeyi YANLIŞLIKLA birleştirmeye")
print("daha yatkın ('zincirleme' sorunu) -- diğer üç yöntem bu köprüye karşı daha DAYANIKLI.")
linkage=single ARI=0.725
linkage=complete ARI=0.857
linkage=average ARI=0.857
linkage=ward ARI=0.857
single-linkage, ince köprüdeki noktaları takip ederek iki kümeyi YANLIŞLIKLA birleştirmeye
daha yatkın ('zincirleme' sorunu) -- diğer üç yöntem bu köprüye karşı daha DAYANIKLI.single bağlantı yöntemi, ARI=0.725 ile diğer üçünden (0.857) belirgin şekilde daha kötü! Çoğu kişi “bağlantı yöntemi sadece küçük bir teknik detay” sanır. Değil, çünkü single (en yakın nokta çiftine bakar) köprüdeki noktaları takip ederek iki kümeyi YANLIŞLIKLA birleştirmeye çok yatkındır — bu, “zincirleme (chaining)” olarak bilinen klasik bir zayıflıktır. complete, average, ward gibi yöntemler tüm kümeyi (sadece en yakın noktayı değil) hesaba kattığı için bu köprüye karşı daha dayanıklı.
Matematik
Bağlantı yöntemleri
| Yöntem | Mantığı | Zayıflığı |
|---|---|---|
| single | İki kümenin EN YAKIN noktaları arasındaki mesafe | Zincirleme (chaining) — ince bir köprü, iki kümeyi yanlışlıkla birleştirebilir |
| complete | İki kümenin EN UZAK noktaları arasındaki mesafe | Aykırı değerlere karşı hassas olabilir |
| average / ward | Tüm nokta çiftlerinin (veya varyansın) ortalaması | Genelde daha DENGELİ, çoğu durumda iyi bir varsayılan |
ward, scikit-learn’ün varsayılanıdır ve genelde en DENGELİ sonuçları verir çünkü birleşmenin küme içi varyansı ne kadar ARTIRACAĞINI minimize etmeye çalışır.
Kod
Dendrogramın en pratik özelliği: aynı hesaplamadan BİRDEN FAZLA k seçeneği elde edebilmek.
Dendrogramı farklı yüksekliklerde kesmek
# Dendrogramı farklı yüksekliklerde "keserek" farklı sayıda küme elde edebiliriz -- K-Means'te
# olduğu gibi k'yı BAŞTAN seçmek zorunda değiliz, sonradan karar verebiliriz.
for k in [2, 3, 4, 6]:
    etiketler = fcluster(Z, t=k, criterion="maxclust")
    print(f"k={k} için kesildiğinde küme boyutları: {np.bincount(etiketler)[1:]}")
print("Aynı dendrogramı farklı yüksekliklerde keserek, tek bir hesaplamadan BİRDEN FAZLA k seçeneği elde ediyoruz.")
k=2 için kesildiğinde küme boyutları: [ 6 12]
k=3 için kesildiğinde küme boyutları: [6 6 6]
k=4 için kesildiğinde küme boyutları: [6 6 5 1]
k=6 için kesildiğinde küme boyutları: [4 1 1 6 5 1]
Aynı dendrogramı farklı yüksekliklerde keserek, tek bir hesaplamadan BİRDEN FAZLA k seçeneği elde ediyoruz.k=3’te kümeler tam olarak dengeli (6, 6, 6) — bu, gerçek yapıyla örtüşüyor. K-Means’te her k için modeli YENİDEN eğitmen gerekirdi; burada TEK bir hesaplamadan (Z matrisi) istediğin kadar farklı k’yı ücretsiz elde ediyorsun.
Nerede işe yarar
Hiyerarşik kümeleme, K-Means’in yetersiz kaldığı durumlarda değerli bir alternatiftir:
- k’yı baştan bilmediğinde. Dendrogramı inceleyip, verinin doğal yapısına göre nerede “keseceğine” sonradan karar verebilirsin.
- İç içe geçmiş (nested) yapıları keşfetmek istediğinde. Biyolojik sınıflandırma (tür-cins-familya gibi) veya organizasyon şemaları gibi doğal hiyerarşisi olan verilerde.
- Küçük-orta veri setlerinde yorumlanabilir bir görselleştirme. Dendrogram, kümelerin birbirine ne kadar “yakın” olduğunu da gösterir — K-Means’in vermediği bir bilgi.
Bu 3 hatayı yaparsın:
- Büyük veri setlerinde hiyerarşik kümeleme kullanmak — hesaplama karmaşıklığı K-Means’ten çok daha yüksektir (genelde veya daha kötü), büyük ‘de pratik değildir.
singlebağlantıyı düşünmeden varsayılan gibi kullanmak — bu derste gördüğümüz gibi zincirleme sorununa açık;wardgenelde daha güvenli bir başlangıç noktasıdır.- Dendrogramı “kesin bir gerçek” gibi okumak — birleşme sırası, veri setindeki küçük değişikliklere duyarlı olabilir; kesin bir k seçimi için silhouette gibi metriklerle (28. ders) desteklemek daha sağlamdır.
Kendini test et
1. Hiyerarşik kümeleme, K-Means'ten (27. ders) en temel olarak nasıl farklıdır?
- Sadece 2 boyutlu verilerde çalışır
- K-Means'in aksine, k'yı baştan belirtmeye gerek yoktur -- tüm birleşme sürecini (dendrogram) üretir, k sonradan seçilir (doğru cevap)
- Etiketli veri gerektirir
- Sadece dairesel kümeler bulabilir
Neden: Hiyerarşik kümeleme, her noktayı ayrı küme olarak başlatıp adım adım birleştirerek tüm k değerlerini içeren bir hiyerarşi (dendrogram) üretir; K-Means'te k baştan sabitlenmelidir.
2. Notebook'ta 'single' bağlantı yöntemi neden diğer üç yöntemden daha kötü sonuç verdi?
- Kod hatalıydı
- 'single', sadece iki kümenin EN YAKIN noktalarına bakar; ince bir 'köprü' oluşturan noktalar, iki farklı kümeyi zincirleme yoluyla yanlışlıkla birleştirebilir (doğru cevap)
- 'single' her zaman en kötü yöntemdir
- Veri seti çok küçüktü
Neden: 'single' bağlantı, iki kümenin en yakın nokta çiftine bakar; bu, iki kümeyi bağlayan ince bir nokta zincirini takip ederek onları yanlışlıkla tek kümeye birleştirebilir -- 'zincirleme (chaining)' sorunu.
3. Dendrogramı farklı yüksekliklerde "kesmenin" pratik avantajı nedir?
- Modeli daha hızlı çalıştırır
- Tek bir hesaplamadan (birleşme matrisinden), her k değeri için modeli yeniden eğitmeden, birden fazla küme sayısı seçeneği elde edebilirsin (doğru cevap)
- Veri setini küçültür
- Sadece görselleştirme amaçlıdır, pratik faydası yoktur
Neden: Dendrogram, tüm birleşme sürecini tek seferde hesaplar; bu ağacı farklı yüksekliklerde "keserek", K-Means'te olduğu gibi her k için modeli yeniden eğitmeden farklı küme sayıları elde edebilirsin.
Özet
Özet
- Hiyerarşik kümeleme, her noktayı ayrı küme olarak başlatıp en yakın kümeleri adım adım birleştirerek bir dendrogram üretir.
- K-Means'in aksine, k'yı baştan belirtmek gerekmez -- dendrogram sonradan istenen yükseklikte "kesilir".
- Bağlantı (linkage) yöntemi, iki kümenin mesafesinin nasıl ölçüldüğünü belirler ve sonucu gerçekten değiştirebilir.
- "single" bağlantı, zincirleme (chaining) sorununa açıktır; "ward" genelde daha dengeli sonuçlar verir.
- Hiyerarşik kümeleme, büyük veri setlerinde K-Means'ten çok daha yavaştır.