

Basit doğrusal regresyon
Önkoşul:Denetimli / denetimsiz / pekiştirmeli
Kanca
20 evin metrekaresi ve fiyatı elinde. Noktaların arasından bir doğru geçirip “işte model bu” diyeceksin — ama sonsuz sayıda doğru çizilebilir. Hangisi “en iyi” doğru, ve bu “en iyi”yi nasıl buluyoruz?
Sezgi
Doğrusal regresyon, veri noktalarına en iyi uyan doğruyu bulma işidir. “En iyi” burada net bir tanım taşır: her noktanın doğrudan ne kadar uzakta olduğunu (hatayı) ölç, bu hataların karesini al (büyük hataları cezalandırmak için), ortalamasını minimize eden doğruyu seç. Bu ortalamaya MSE (ortalama karesel hata) denir.
MSE (ortalama karesel hata): 13.82 — doğruyu ayarlayıp MSE'yi küçültmeye çalış, sonra "en iyi doğruyu bul"a bas.
Eğim ve kesişimi elle ayarla, MSE’nin nasıl değiştiğini izle. Sonra “en iyi doğruyu bul” düğmesine bas — bu, matematiğin doğrudan hesapladığı MSE’yi minimize eden doğrudur.
Mekanizma
Gerçek verilerle ilerleyelim:
Ev verisi
# 20 evin metrekaresi ve fiyatı (yüz bin TL). Gerçek ilişki: fiyat ≈ 3 + 0.09*metrekare + gürültü.
metrekare = 50 + rng.random(20) * 150
fiyat = 3 + 0.09 * metrekare + rng.normal(0, 1.2, size=20)

print("İlk 5 ev:")
for m, f in zip(metrekare[:5], fiyat[:5]):
    print(f"  {m:.0f} m²  →  {f:.2f} (yüz bin TL)")
İlk 5 ev:
166 m² → 17.73 (yüz bin TL)
116 m² → 12.61 (yüz bin TL)
179 m² → 20.56 (yüz bin TL)
155 m² → 16.73 (yüz bin TL)
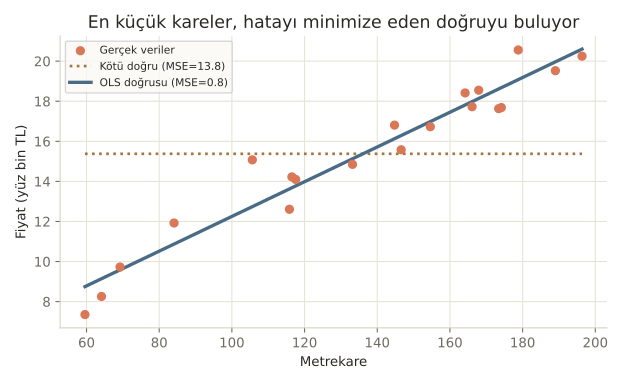
64 m² → 8.26 (yüz bin TL)Önce kötü bir doğru deneyelim — sadece ortalama fiyattan geçen yatay bir çizgi:
Kötü bir doğru
# Rastgele, KÖTÜ bir doğru deneyelim: yatay bir çizgi (eğim=0), sadece ortalama fiyattan geçen.
m_kotu, b_kotu = 0, fiyat.mean()
tahmin_kotu = m_kotu * metrekare + b_kotu
mse_kotu = np.mean((fiyat - tahmin_kotu) ** 2)
print(f"\nKötü doğru (y = {b_kotu:.2f}): MSE = {mse_kotu:.2f}")
Kötü doğru (y = 15.38): MSE = 13.84MSE=13.84. Şimdi en küçük kareler (OLS) yöntemiyle gerçekten en iyi doğruyu bulalım — bu, deneme yanılma değil, kapalı bir formülle DOĞRUDAN hesaplanır:
En küçük kareler çözümü
# En Küçük Kareler (OLS): MSE'yi minimize eden eğim ve kesişimin KAPALI FORM çözümü.
ort_x, ort_y = metrekare.mean(), fiyat.mean()
egim = np.sum((metrekare - ort_x) * (fiyat - ort_y)) / np.sum((metrekare - ort_x) ** 2)
kesisim = ort_y - egim * ort_x

tahmin_iyi = egim * metrekare + kesisim
mse_iyi = np.mean((fiyat - tahmin_iyi) ** 2)

print(f"\nOLS ile bulunan doğru: fiyat = {egim:.4f} × metrekare + {kesisim:.2f}")
print(f"OLS doğrusu: MSE = {mse_iyi:.2f}  (kötü doğrudan {mse_kotu / mse_iyi:.1f} kat daha iyi)")
OLS ile bulunan doğru: fiyat = 0.0867 × metrekare + 3.59
OLS doğrusu: MSE = 0.85  (kötü doğrudan 16.4 kat daha iyi)
MSE 0.85’e düştü — kötü doğrudan 16.4 kat daha iyi. Çoğu kişi “en iyi doğruyu bulmak için bilgisayarın bir sürü doğru denemesi gerekir” sanır. Değil, çünkü basit doğrusal regresyonda en iyi eğim ve kesişimin kapalı bir formülü var — deneme yapmaya hiç gerek yok, doğrudan hesaplanabiliyor (4. derste çoklu regresyonda bu formül matris formuna genelleşecek).
Matematik
En küçük kareler formülü
| Sembol | Anlamı |
|---|---|
| Eğim — metrekare bir birim artınca fiyatın ne kadar artacağı | |
| Kesişim — metrekare sıfır olsaydı (anlamsız ama matematiksel olarak) fiyatın ne olacağı | |
| Modelin tahmini (doğrunun o noktadaki değeri) | |
| Kalıntı (residual) — gerçek değer ile tahmin arasındaki fark |
formülü aslında tanıdık: pay, 20. istatistik dersindeki kovaryansa benziyor; payda, ‘in varyansına benziyor. Doğrusal regresyonun eğimi, x ile y’nin birlikte ne kadar değiştiğinin, x’in kendi içindeki değişime oranıdır.
Kod
scikit-learn’ün LinearRegression’ı ile aynı sonucu doğrulayalım, ve yeni bir ev için tahmin yapalım:
scikit-learn ile doğrulama
# Aynı sonucu scikit-learn'ün LinearRegression'ı ile doğrulayalım.
model = LinearRegression()
model.fit(metrekare.reshape(-1, 1), fiyat)

print(f"\nscikit-learn eğimi: {model.coef_[0]:.4f}   (elle hesapladığımız: {egim:.4f})")
print(f"scikit-learn kesişimi: {model.intercept_:.2f}   (elle hesapladığımız: {kesisim:.2f})")

yeni_ev = np.array([[140]])
tahmini_fiyat = model.predict(yeni_ev)[0]
print(f"\n140 m²'lik yeni bir ev için tahmini fiyat: {tahmini_fiyat:.2f} yüz bin TL")
scikit-learn eğimi: 0.0867   (elle hesapladığımız: 0.0867)
scikit-learn kesişimi: 3.59   (elle hesapladığımız: 3.59)

140 m²'lik yeni bir ev için tahmini fiyat: 15.72 yüz bin TL
Elle hesapladığımız ve scikit-learn’ün bulduğu eğim/kesişim birebir aynı (0.0867, 3.59) — kütüphane, aynı formülü bizim yerimize hesaplıyor.
Nerede işe yarar
Doğrusal regresyon, en basit ve en yorumlanabilir tahmin modelidir:
- Fiyat tahmini. Ev, araba, ürün fiyatlarını özelliklerinden tahmin etmek.
- Trend analizi. Zaman içindeki bir metriğin (satış, kullanıcı sayısı) genel eğilimini modellemek.
- Temel karşılaştırma noktası (baseline). Daha karmaşık bir model kurmadan önce, doğrusal regresyonun ne kadar iyi performans gösterdiğini görmek — eğer karmaşık model bundan çok daha iyi değilse, karmaşıklığa değmeyebilir.
Bu 3 hatayı yaparsın:
- Doğrusal olmayan bir ilişkiye (6. derste göreceğimiz gibi) doğrusal regresyon zorlamak — MSE yüksek kalır, model veriyi yakalayamaz.
- Eğimi “x arttıkça y bu kadar artar” diye yorumlarken, bunun sadece VERİDEKİ ilişki olduğunu, nedensellik olmadığını unutmak (20. istatistik dersini hatırla).
- Tek bir öznitelikle (metrekare) sınırlı kalıp, fiyatı etkileyen diğer faktörleri (oda sayısı, konum) göz ardı etmek — 4. derste çoklu regresyona geçeceğiz.
Kendini test et
1. MSE (ortalama karesel hata) neyi ölçer?
- Doğrunun eğimini
- Gerçek değerler ile model tahminleri arasındaki farkların karesinin ortalamasını (doğru cevap)
- Veri noktalarının sayısını
- Sadece en büyük hatayı
Neden: MSE, her noktadaki hatayı (gerçek - tahmin) alıp karesini alarak büyük hataları daha ağır cezalandırır, sonra bu karelerin ortalamasını hesaplar.
2. En küçük kareler (OLS) yöntemi en iyi doğruyu nasıl bulur?
- Rastgele birçok doğru deneyerek
- MSE'yi minimize eden eğim ve kesişimi kapalı bir formülle doğrudan hesaplayarak (doğru cevap)
- Kullanıcıdan doğruyu elle çizmesini isteyerek
- Sadece en yakın iki noktayı birleştirerek
Neden: Basit doğrusal regresyonda en iyi eğim ve kesişimin kapalı formülü vardır — deneme yanılmaya gerek kalmadan doğrudan hesaplanabilir.
3. Notebook örneğinde scikit-learn'ün bulduğu eğim, elle hesaplanan eğimle neden birebir aynı çıktı?
- Tesadüf
- İkisi de aynı en küçük kareler formülünü kullanıyor, sadece biri elle biri kütüphaneyle hesaplanıyor (doğru cevap)
- scikit-learn hatalı çalışıyor
- Veri çok küçük olduğu için
Neden: scikit-learn'ün LinearRegression'ı da aynı matematiksel en küçük kareler çözümünü kullanır — kütüphane sadece hesaplamayı bizim yerimize, daha genel ve optimize şekilde yapar.
Özet
Özet
- Doğrusal regresyon, veriye en iyi uyan doğruyu (y = mx + b) bulur.
- 'En iyi', ortalama karesel hatayı (MSE) minimize eden doğru demektir.
- En küçük kareler (OLS), bu en iyi eğim ve kesişimi kapalı bir formülle doğrudan hesaplar.
- scikit-learn'ün LinearRegression'ı aynı formülü uygular, deneme yanılma yapmaz.
- Doğrusal regresyon, daha karmaşık modeller için bir başlangıç karşılaştırma noktasıdır.