

Naive Bayes
Önkoşul:Kernel hilesi
Kanca
- istatistik dersinde Bayes teoremini gördük: kanıt biriktikçe inancını güncellemek. Naive Bayes, bu fikri doğrudan bir sınıflandırma algoritmasına dönüştürür — ve ismindeki “naive” (saf) kelimesi, bilerek yaptığı bir basitleştirmeye işaret ediyor.
Sezgi
Naive Bayes, Bayes teoremini kullanarak “bu özniteliklere sahip bir örnek, hangi sınıfa ait olma OLASILIĞI daha yüksek?” sorusunu cevaplar. “Naive” (saf) kısmı şuradan geliyor: model, TÜM özniteliklerin birbirinden BAĞIMSIZ olduğunu varsayar — yani “ünlem sayısı yüksekse spam olma ihtimali artar” ve “‘bedava’ kelimesi geçiyorsa spam olma ihtimali artar” bilgilerini, sanki birbirinden hiç etkilenmiyormuş gibi BİRLEŞTİRİR.
Bu varsayım genelde gerçekçi DEĞİLDİR — birçok öznitelik birbiriyle ilişkilidir. Ama şaşırtıcı bir şekilde, model pratikte yine de çok iyi çalışır. Bu dersin can alıcı sorusu tam olarak bu: neden?
Mekanizma
Basit bir spam sınıflandırma problemiyle ilerleyelim:
Spam e-posta verisi
# Basit bir e-posta spam verisi: 2 öznitelik (ünlem sayısı, "bedava" kelimesinin geçme sayısı).
n = 200
spam_mi = rng.integers(0, 2, n)
unlem_sayisi = np.where(spam_mi == 1, rng.poisson(4, n), rng.poisson(1, n))
bedava_sayisi = np.where(spam_mi == 1, rng.poisson(2.5, n), rng.poisson(0.3, n))
X = np.column_stack([unlem_sayisi, bedava_sayisi])
print(f"{n} e-posta, {spam_mi.sum()} tanesi spam")
200 e-posta, 102 tanesi spamBayes teoreminin sezgisi
# 19. istatistik dersini hatırla: P(spam|kanıt) = P(kanıt|spam) * P(spam) / P(kanıt)
p_spam = spam_mi.mean()
p_unlem_spamken = unlem_sayisi[spam_mi == 1].mean()
p_unlem_spamdegilken = unlem_sayisi[spam_mi == 0].mean()
print(f"P(spam) = {p_spam:.3f}  (öncül olasılık)")
print(f"Spam e-postalarda ortalama ünlem sayısı: {p_unlem_spamken:.2f}")
print(f"Spam olmayan e-postalarda ortalama ünlem sayısı: {p_unlem_spamdegilken:.2f}")
print("Naive Bayes, bu farkı kullanarak yeni bir e-postanın spam olma olasılığını hesaplar.")
P(spam) = 0.510 (öncül olasılık)
Spam e-postalarda ortalama ünlem sayısı: 4.26
Spam olmayan e-postalarda ortalama ünlem sayısı: 1.05
Naive Bayes, bu farkı kullanarak yeni bir e-postanın spam olma olasılığını hesaplar.Spam e-postalarda ortalama ünlem sayısı (4.26), spam olmayanlardan (1.05) belirgin şekilde yüksek — bu fark, modelin öğrendiği sinyal. Şimdi modeli eğitelim:
Naive Bayes modeli
model = GaussianNB()
model.fit(X, spam_mi)
tahmin = model.predict(X)
dogruluk = accuracy_score(spam_mi, tahmin)
print(f"\nEğitim doğruluğu: {dogruluk:.3f}")

# Yeni bir e-posta: 5 ünlem, 3 kere "bedava" -- muhtemelen spam.
yeni_eposta = np.array([[5, 3]])
olasilik = model.predict_proba(yeni_eposta)[0]
print(f"Yeni e-posta (5 ünlem, 3 'bedava'): spam olasılığı = %{olasilik[1] * 100:.1f}")
Eğitim doğruluğu: 0.925
Yeni e-posta (5 ünlem, 3 'bedava'): spam olasılığı = %100.0
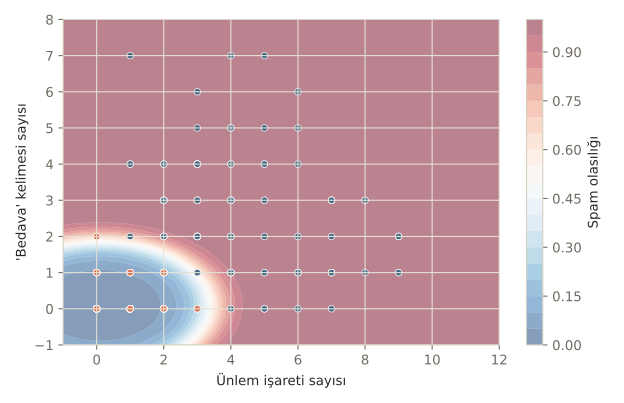
%92.5 doğruluk, ve 5 ünlem + 3 “bedava” kelimesi içeren yeni bir e-postaya neredeyse kesin (%100) spam etiketi. Şimdi “naive” varsayımını test edelim:
Bağımsızlık varsayımı gerçekten doğru mu?
# "Naive" (saf) kelimesi buradan geliyor: öznitelikler birbirinden BAĞIMSIZ varsayılıyor.
korelasyon = np.corrcoef(unlem_sayisi, bedava_sayisi)[0, 1]
print(f"\nÜnlem sayısı ile 'bedava' sayısı arasındaki gerçek korelasyon: {korelasyon:.3f}")
print("Aslında bağımsız DEĞİLLER (ikisi de spam olmaktan etkileniyor) -- ama model yine de iyi çalışıyor.")
print("Bu, 'saf' (naive) varsayımın çoğu zaman YANLIŞ olmasına rağmen pratikte işe yaramasının klasik örneği.")
Ünlem sayısı ile 'bedava' sayısı arasındaki gerçek korelasyon: 0.375
Aslında bağımsız DEĞİLLER (ikisi de spam olmaktan etkileniyor) -- ama model yine de iyi çalışıyor.
Bu, 'saf' (naive) varsayımın çoğu zaman YANLIŞ olmasına rağmen pratikte işe yaramasının klasik örneği.
Korelasyon 0.375 — öznitelikler gerçekten bağımsız DEĞİL (ikisi de “spam olmak”tan etkileniyor, bu yüzden birlikte hareket ediyorlar). Çoğu kişi “yanlış bir varsayıma dayanan model kötü sonuç vermeli” sanır. Çoğu zaman doğru değil, çünkü sınıflandırma için gereken şey MUTLAK olasılıkların doğruluğu değil, hangi sınıfın olasılığının DAHA YÜKSEK olduğunun doğru sıralanmasıdır — bağımsızlık ihlali genelde bu sıralamayı bozacak kadar büyük değildir.
Matematik
Naive Bayes sınıflandırma kuralı
| Sembol | Anlamı |
|---|---|
| Öncül olasılık — o sınıfın veri setinde ne kadar yaygın olduğu | |
| O sınıfa ait örneklerde, ‘inci özniteliğin dağılımı | |
| Tüm özniteliklerin olasılıklarının ÇARPIMI — bağımsızlık varsayımının matematiksel karşılığı |
Gerçek (bağımsız olmayan) bir dünyada doğru formül olurdu — bu, öznitelik sayısı arttıkça hesaplanması imkansız hale gelir. Naive Bayes, bunu tek tek ‘lerin çarpımıyla YAKLAŞTIRARAK, hesaplanabilir ve hızlı bir model elde eder.
Kod
Naive Bayes’in pratikteki en büyük avantajlarından biri hızıdır:
Hız karşılaştırması
# Naive Bayes'in en büyük avantajlarından biri: aşırı hızlı eğitim (kapalı formül, iteratif değil).
from sklearn.linear_model import LogisticRegression

n_tekrar = 500
baslangic = perf_counter()
for _ in range(n_tekrar):
    GaussianNB().fit(X, spam_mi)
sure_nb = perf_counter() - baslangic

baslangic = perf_counter()
for _ in range(n_tekrar):
    LogisticRegression().fit(X, spam_mi)
sure_lr = perf_counter() - baslangic

print(f"\nNaive Bayes: {n_tekrar} eğitim {sure_nb:.3f} saniye")
print(f"Lojistik regresyon: {n_tekrar} eğitim {sure_lr:.3f} saniye")
print(f"Naive Bayes {sure_lr / sure_nb:.1f}x daha hızlı -- çünkü kapalı formülle (ortalama/varyans hesabı) çözülüyor, iteratif optimizasyon gerekmiyor.")
Naive Bayes: 500 eğitim 0.520 saniye
Lojistik regresyon: 500 eğitim 3.147 saniye
Naive Bayes 6.1x daha hızlı -- çünkü kapalı formülle (ortalama/varyans hesabı) çözülüyor, iteratif optimizasyon gerekmiyor.
6 kat daha hızlı — çünkü Naive Bayes, lojistik regresyon gibi iteratif bir optimizasyon YAPMAZ; sadece her sınıf için ortalama ve varyans gibi basit istatistikleri hesaplar, kapalı formülle biter.
Nerede işe yarar
Naive Bayes, basitliğine rağmen belirli alanlarda hâlâ çok tercih edilir:
- Metin sınıflandırma. Spam filtreleme, duygu analizi gibi problemlerde (kelime sayıları öznitelik olarak kullanıldığında) klasik ve güçlü bir başlangıç noktasıdır.
- Çok hızlı bir taban çizgisi gerektiğinde. Eğitimi neredeyse anlık olduğu için, karmaşık bir model kurmadan önce “bu problem ne kadar zor?” sorusuna hızlı cevap verir.
- Çok sayıda öznitelik, az veri olduğunda. Basit yapısı sayesinde, aşırı öğrenmeye (7. ders) daha az eğilimlidir.
Bu 3 hatayı yaparsın:
- Naive Bayes’in çıkardığı olasılıkları (predict_proba) çok KESİN sanmak — bağımsızlık varsayımı ihlal edildiğinde, olasılıklar genelde 0 veya 1’e aşırı yakın çıkar (notebook’ta %100 gördüğümüz gibi) ama SIRALAMA genelde hâlâ doğrudur.
- Öznitelikler arasında GÜÇLÜ bir korelasyon olduğunu bilerek yine de Naive Bayes’i düşünmeden kullanmak — çok güçlü bağımlılıklarda performans gerçekten düşebilir.
- Naive Bayes’i her zaman “zayıf bir model” sanıp göz ardı etmek — metin gibi yüksek boyutlu, seyrek verilerde şaşırtıcı derecede rekabetçi kalabiliyor.
Kendini test et
1. Naive Bayes'teki 'naive' (saf) kelimesi neyi ifade eder?
- Modelin basit bir algoritma olduğunu
- Modelin, tüm özniteliklerin birbirinden bağımsız olduğunu varsaydığını (doğru cevap)
- Modelin sadece küçük veri setlerinde çalıştığını
- Modelin rastgele tahmin yaptığını
Neden: Naive Bayes, öznitelikler arasındaki olası bağımlılıkları göz ardı ederek, her özniteliğin sınıfa katkısını BAĞIMSIZMIŞ gibi çarparak hesaplar -- bu basitleştirme 'naive' (saf) olarak adlandırılır.
2. Notebook'ta öznitelikler arasında 0.375 korelasyon olmasına rağmen model neden hâlâ %92.5 doğruluk verdi?
- Kod hatalıydı
- Sınıflandırma için gereken şey, hangi sınıfın DAHA olası olduğunun doğru sıralanmasıdır -- bağımsızlık ihlali genelde bu sıralamayı bozacak kadar büyük değildir (doğru cevap)
- Korelasyon önemsizdir, hiçbir etkisi yoktur
- Model aslında yanlış çalışıyor
Neden: Naive Bayes, mutlak olasılıkları değil hangi sınıfın olasılığının daha yüksek olduğunu doğru sıralamaya çalışır; hafif-orta düzey bağımlılıklar bu sıralamayı genelde bozmaz.
3. Naive Bayes neden lojistik regresyondan 6 kat daha hızlı eğitildi?
- Daha az veri kullandığı için
- İteratif bir optimizasyon yapmadan, sadece her sınıf için ortalama/varyans gibi istatistikleri kapalı formülle hesapladığı için (doğru cevap)
- Daha az öznitelik kullandığı için
- Rastgele bir tesadüf
Neden: Lojistik regresyon, katsayıları adım adım (iteratif optimizasyonla) bulur; Naive Bayes ise sadece basit istatistikleri (ortalama, varyans) tek seferde hesaplayıp biter.
Özet
Özet
- Naive Bayes, Bayes teoremini kullanarak hangi sınıfın daha olası olduğunu hesaplar.
- "Naive" varsayımı, tüm özniteliklerin birbirinden bağımsız olduğunu kabul eder -- genelde gerçekçi değildir.
- Bu varsayım ihlal edilse bile, model sınıflar arası SIRALAMAYI genelde doğru yapar -- bu yüzden pratikte iyi çalışır.
- Naive Bayes, kapalı formülle (iteratif optimizasyon olmadan) eğitildiği için çok hızlıdır.
- Metin sınıflandırma gibi yüksek boyutlu, seyrek veri problemlerinde hâlâ rekabetçi bir seçenektir.