

Ridge, Lasso, Elastic Net
Önkoşul:Aşırı öğrenme ve bias-variance
Kanca
- derste “çok esnek model = aşırı öğrenme” dedik ama çözümü sadece “daha az esnek bir model seç” diye bıraktık. Peki modeli aynı bırakıp, sadece katsayıların büyümesini CEZALANDIRARAK aşırı öğrenmeyi önleyebilir miyiz? Ve bu ceza, gereksiz öznitelikleri otomatik olarak “eleyebilir” mi?
Sezgi
Düzenlileştirme (regularization), kayıp fonksiyonuna bir CEZA TERİMİ ekler — model artık sadece hatayı değil, hata + katsayıların büyüklüğünü birlikte küçültmeye çalışır. Bu, modelin verideki gürültüye aşırı uymasını (7. dersteki aşırı öğrenme) frenler.
İki temel ceza türü var:
- Ridge (L2): katsayıların KARELERİ toplamını cezalandırır. Tüm katsayıları küçültür ama nadiren tam sıfıra indirir.
- Lasso (L1): katsayıların MUTLAK DEĞERLERİ toplamını cezalandırır. Bazı katsayıları TAM SIFIRA indirir — bu da otomatik bir öznitelik seçimi demektir.
λ = 0.032
Ridge (L2) -- katsayılar küçülür ama nadiren tam sıfır olur
Lasso (L1) -- katsayılar birer birer TAM SIFIRA iniyor
- metrekare
- oda_sayısı
- bina_yaşı
- kat_no (gürültü)
- sokak_gürültüsü (gürültü)
- doğum_ayı (gürültü)
| Öznitelik | Ridge | Lasso |
|---|---|---|
| metrekare | 0.809 | 0.789 |
| oda_sayısı | 0.545 | 0.524 |
| bina_yaşı | -0.225 | -0.208 |
| kat_no | 0.071 | 0.042 |
| sokak_gürültüsü | 0.029 | 0.000 (sıfırlandı) |
| doğum_ayı | 0.001 | 0.000 (sıfırlandı) |
Bu λ değerinde Lasso, 2 / 6 özniteliğin katsayısını tam sıfıra indirdi -- Ridge'de hiçbir katsayı tam sıfır olmuyor, sadece küçülüyor.
λ (lambda) kaydırıcısını sağa kaydır: Ridge panelinde tüm çizgiler yavaşça sıfıra yaklaşır ama hiçbiri tam sıfır OLMAZ. Lasso panelinde ise gürültü öznitelikleri (kesikli/gri) birer birer tam sıfıra “çarpıp” orada kalır — bu, iki cezanın matematiksel olarak neden farklı davrandığının görsel kanıtı.
Mekanizma
Gerçek verilerle doğrulayalım — 6 öznitelikten sadece 3’ü fiyatı gerçekten etkiliyor, diğer 3’ü tamamen rastgele (gürültü):
Veri: 3 gerçek + 3 gürültü öznitelik
# 6 öznitelik: sadece 3'ü GERÇEKTEN fiyatı etkiliyor, diğer 3'ü saf gürültü (rastgele, alakasız).
n = 100
isimler = ["metrekare", "oda_sayisi", "bina_yasi", "kat_no", "sokak_gurultusu", "dogum_ayi"]
gercek_agirliklar = np.array([0.8, 0.5, -0.3, 0.0, 0.0, 0.0])

X_ham = rng.normal(0, 1, size=(n, 6))
X = StandardScaler().fit_transform(X_ham)
y = X @ gercek_agirliklar + rng.normal(0, 0.5, n)

print(f"Veri: {n} satır, {X.shape[1]} öznitelik (bunlardan 3'ü gürültü: kat_no, sokak_gurultusu, dogum_ayi)")
Veri: 100 satır, 6 öznitelik (bunlardan 3'ü gürültü: kat_no, sokak_gurultusu, dogum_ayi)Ridge: hiçbir katsayı tam sıfır değil
ridge = Ridge(alpha=1.0)
ridge.fit(X, y)
print("Ridge katsayıları (alpha=1.0):")
for isim, k in zip(isimler, ridge.coef_):
    print(f"  {isim:<18} {k:+.3f}")
Ridge katsayıları (alpha=1.0):
metrekare +0.788
oda_sayisi +0.466
bina_yasi -0.228
kat_no -0.081
sokak_gurultusu +0.051
dogum_ayi -0.059Ridge’de sokak_gurultusu ve dogum_ayi gibi alakasız öznitelikler küçük katsayılar alıyor (0.051, -0.059) ama TAM SIFIR değil. Şimdi Lasso’yu deneyelim:
Lasso: 3 gürültü özniteliği tam sıfırlanıyor
lasso = Lasso(alpha=0.1)
lasso.fit(X, y)
print("Lasso katsayıları (alpha=0.1):")
for isim, k in zip(isimler, lasso.coef_):
    isaret = "  <- SIFIRLANDI" if k == 0 else ""
    print(f"  {isim:<18} {k:+.3f}{isaret}")
Lasso katsayıları (alpha=0.1):
metrekare +0.712
oda_sayisi +0.357
bina_yasi -0.147
kat_no -0.000 <- SIFIRLANDI
sokak_gurultusu +0.000 <- SIFIRLANDI
dogum_ayi -0.000 <- SIFIRLANDILasso, üç gürültü özniteliğini (kat_no, sokak_gurultusu, dogum_ayi) TAM OLARAK sıfırladı — model artık bu özniteliklerin var olduğunu bile “unuttu”. Çoğu kişi “Ridge ve Lasso ikisi de katsayıları küçültür, aralarında büyük fark olmaz” sanır. Değil, çünkü L1 cezasının matematiksel şekli (mutlak değer), optimizasyonun köşe noktalarında (katsayı=0 gibi) durmasına izin verir; L2 cezası (kare) ise pürüzsüz bir yüzey olduğu için optimizasyon neredeyse hiçbir zaman TAM sıfıra ulaşmaz.
Elastic Net ikisinin ortası bir yol sunuyor:
Elastic Net: kısmi seyreklik
# Elastic Net, Ridge (L2) ile Lasso (L1) cezalarını l1_ratio ile KARIŞTIRIR.
# l1_ratio=1 -> saf Lasso, l1_ratio=0 -> saf Ridge, arası bir denge sağlar.
elastic = ElasticNet(alpha=0.1, l1_ratio=0.5)
elastic.fit(X, y)
print("Elastic Net katsayıları (alpha=0.1, l1_ratio=0.5):")
for isim, k in zip(isimler, elastic.coef_):
    isaret = "  <- SIFIRLANDI" if k == 0 else ""
    print(f"  {isim:<18} {k:+.3f}{isaret}")
Elastic Net katsayıları (alpha=0.1, l1_ratio=0.5):
metrekare +0.718
oda_sayisi +0.392
bina_yasi -0.190
kat_no -0.021
sokak_gurultusu +0.000 <- SIFIRLANDI
dogum_ayi -0.005l1_ratio=0.5 ile Elastic Net, sadece 1 özniteliği tam sıfırladı (sokak_gurultusu), diğer gürültü özniteliklerini (kat_no, dogum_ayi) küçük ama sıfır olmayan değerlere indirdi — Lasso’nun agresif seçiciliği ile Ridge’in yumuşak küçültmesi arasında bir denge.
Matematik
Üç düzenlileştirme cezası
| Sembol | Anlamı |
|---|---|
| Düzenlileştirme gücü — 0 ise sıradan regresyon, büyüdükçe ceza baskınlaşır | |
| L2 cezası (Ridge) — büyük katsayıları orantısız cezalandırır, pürüzsüz azalır | |
| L1 cezası (Lasso) — köşeli bir ceza yüzeyi, katsayıları TAM sıfıra iter |
Elastic Net, ikisini l1_ratio () ile karıştırır: . saf Lasso, saf Ridge’dir.
Kod
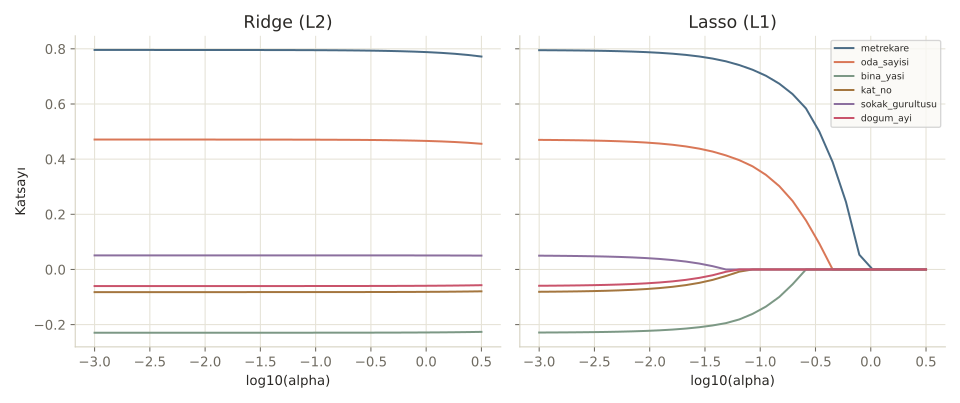
α arttıkça her iki yöntemde kaç katsayının tam sıfırlandığını izleyelim:
Alpha arttıkça sıfırlanan katsayı sayısı
alphalar = np.logspace(-3, 0.5, 8)
print(f"{'alpha':>8}  {'ridge sifir sayisi':>18}  {'lasso sifir sayisi':>18}")
for a in alphalar:
    r = Ridge(alpha=a).fit(X, y)
    l = Lasso(alpha=a, max_iter=5000).fit(X, y)
    r_sifir = int(np.sum(np.abs(r.coef_) < 1e-8))
    l_sifir = int(np.sum(np.abs(l.coef_) < 1e-8))
    print(f"{a:8.4f}  {r_sifir:18d}  {l_sifir:18d}")
print("\nRidge hemen hemen hiçbir zaman tam sıfır üretmiyor; Lasso alpha arttıkça öznitelikleri teker teker eliyor.")
alpha ridge sifir sayisi lasso sifir sayisi
0.0010 0 0
0.0032 0 0
0.0100 0 0
0.0316 0 0
0.1000 0 3
0.3162 0 4
1.0000 0 6
3.1623 0 6
Ridge hemen hemen hiçbir zaman tam sıfır üretmiyor; Lasso alpha arttıkça öznitelikleri teker teker eliyor.Tablo çok net: Ridge sütunu α=3.16’ya kadar hep 0 kalıyor (hiçbir katsayı tam sıfırlanmıyor); Lasso sütunu ise 0 → 3 → 4 → 6 şeklinde adım adım artıyor.
Nerede işe yarar
Düzenlileştirme, gerçek dünyadaki neredeyse her doğrusal modelde varsayılan bir bileşendir:
- Çok sayıda öznitelik olan problemlerde Lasso. Yüzlerce öznitelik arasından hangilerinin gerçekten önemli olduğunu otomatik olarak bulmak istediğinde.
- Öznitelikler birbiriyle ilişkiliyken (multicollinearity) Ridge. Lasso ilişkili özniteliklerden rastgele birini seçip diğerini sıfırlayabilir; Ridge ikisini de “paylaştırarak” tutar.
- Elastic Net, ikisinden de emin olmadığında. Hem bazı özniteliklerin elenmesini hem de ilişkili özniteliklerin korunmasını istiyorsan.
Bu 3 hatayı yaparsın:
- Öznitelikleri standardize etmeden düzenlileştirme uygulamak — ceza terimi, büyük ölçekli özniteliklerin katsayısını orantısız cezalandırır (15. veri bilimi dersini hatırla).
- α’yı rastgele bir sabit seçmek — doğru α, veri setine göre değişir ve genelde çapraz doğrulamayla (bir sonraki ders) bulunur.
- Lasso’nun sıfırladığı bir özniteliğin “kesinlikle önemsiz” olduğuna karar vermek — sıfırlanma, o α değerinde ve o veri örnekleminde geçerlidir, mutlak bir gerçek değildir.
Kendini test et
1. Lasso (L1) ile Ridge (L2) arasındaki en önemli pratik fark nedir?
- Lasso her zaman daha düşük hata verir
- Lasso katsayıları TAM SIFIRA indirebilir (öznitelik seçimi yapar), Ridge sadece küçültür (doğru cevap)
- Ridge daha hızlı çalışır
- Aralarında pratik fark yoktur
Neden: L1 cezasının köşeli matematiksel şekli, optimizasyonun tam sıfır noktasında durmasına izin verir; L2 cezası pürüzsüz olduğu için bu neredeyse hiç olmaz.
2. Notebook'ta Lasso, hangi 3 özniteliğin katsayısını tam sıfıra indirdi?
- metrekare, oda_sayisi, bina_yasi (gerçek etkisi olanlar)
- kat_no, sokak_gurultusu, dogum_ayi (saf gürültü olanlar) (doğru cevap)
- Rastgele 3 öznitelik
- Hiçbirini, hepsi nonzero kaldı
Neden: Lasso, gerçekte fiyatı etkilemeyen (saf gürültü) 3 özniteliği doğru şekilde sıfırladı; gerçek etkisi olan 3 öznitelik nonzero kaldı.
3. Elastic Net ne zaman Ridge veya Lasso'nun tek başına kullanılmasından daha uygun olabilir?
- Asla, her zaman Lasso tercih edilmeli
- Hem bazı özniteliklerin elenmesini hem de ilişkili özniteliklerin birlikte korunmasını istediğinde (doğru cevap)
- Sadece veri seti çok küçükken
- Sadece sınıflandırma problemlerinde
Neden: Elastic Net, L1'in seçicilik özelliği ile L2'nin ilişkili öznitelikleri birlikte tutma özelliğini birleştirir -- ikisinin avantajını da kısmen almak istediğinde tercih edilir.
Özet
Özet
- Düzenlileştirme, kayıp fonksiyonuna katsayı büyüklüğünü cezalandıran bir terim ekleyerek aşırı öğrenmeyi frenler.
- Ridge (L2), tüm katsayıları küçültür ama neredeyse hiçbir zaman tam sıfıra indirmez.
- Lasso (L1), bazı katsayıları TAM SIFIRA indirir -- bu otomatik bir öznitelik seçimidir (seyreklik/sparsity).
- Elastic Net, L1 ve L2 cezalarını l1_ratio ile karıştırarak ikisi arasında bir denge sunar.
- Düzenlileştirme gücü (α) veri setine göre ayarlanmalı, genelde çapraz doğrulamayla bulunur.