

Makine öğrenmesine giriş
Kanca
Bir spam filtresi yazman gerekiyor. “Ücretsiz” veya “kazandınız” kelimesi geçen mesajları spam say — basit, mantıklı bir kural. Ama “bu ürün tamamen bedava” mesajı bu kuralı atlatıyor, çünkü “bedava” listede yok. Her yeni spam taktiğini elle mi ekleyeceksin, yoksa sistemin kendisi mi öğrensin?
Sezgi
Geleneksel programlamada kuralı SEN yazarsın: “eğer şu kelime varsa, spam say.” Sistem senin yazdığın kuralın dışına asla çıkamaz — düşünmediğin her durum, sistemin kör noktası olur.
Makine öğrenmesinde ise kuralı SEN yazmazsın — örneklerden (etiketli veri) ÖĞRENİLİR. Sen “işte 1000 spam, işte 1000 normal mesaj” dersin, algoritma bu örnekler arasındaki ayırt edici örüntüyü kendisi bulur. Yeni bir spam taktiği ortaya çıktığında, yeni örneklerle yeniden eğitmek yeterlidir — kuralı elden geçirmek gerekmez.
Mekanizma
Önce kural tabanlı yaklaşımı deneyelim:
Kural tabanlı spam tespiti
# Geleneksel programlama: SEN kuralı yazarsın. Spam tespiti için "ücretsiz" veya
# "kazandınız" kelimesi geçiyorsa spam say.
def kural_tabanli_spam_mi(mesaj):
    tetikleyiciler = ["ücretsiz", "kazandınız", "tıklayın"]
    return any(kelime in mesaj.lower() for kelime in tetikleyiciler)

ornek_mesajlar = [
    ("Ücretsiz kargo fırsatını kaçırmayın!", True),
    ("Toplantı saat 14:00'e alındı.", False),
    ("Tebrikler, hediye çekinizi kazandınız!", True),
    ("Bu ürün tamamen bedava, hemen sahip olun.", True),  # "ücretsiz" kelimesi YOK ama spam
]

print("Kural tabanlı sistem:")
dogru_sayisi = 0
for mesaj, gercek_etiket in ornek_mesajlar:
    tahmin = kural_tabanli_spam_mi(mesaj)
    dogru = tahmin == gercek_etiket
    dogru_sayisi += dogru
    print(f"  '{mesaj[:40]}...'  tahmin={tahmin}  gerçek={gercek_etiket}  {'✓' if dogru else '✗ YANLIŞ'}")
print(f"Doğruluk: {dogru_sayisi}/{len(ornek_mesajlar)} — 'bedava' gibi eş anlamlıları kural yazan kişi unutabilir.")
Kural tabanlı sistem:
'Ücretsiz kargo fırsatını kaçırmayın!...' tahmin=True gerçek=True ✓
'Toplantı saat 14:00'e alındı....' tahmin=False gerçek=False ✓
'Tebrikler, hediye çekinizi kazandınız!...' tahmin=True gerçek=True ✓
'Bu ürün tamamen bedava, hemen sahip olun...' tahmin=False gerçek=True ✗ YANLIŞ
Doğruluk: 3/4 — 'bedava' gibi eş anlamlıları kural yazan kişi unutabilir.3/4 doğru — “bedava” kelimesi listede olmadığı için son mesajı kaçırdık. Şimdi aynı problemi veriden öğrenerek çözelim:
Veriden öğrenme
# Makine öğrenmesi: kuralı SEN yazmazsın — örneklerden (etiketli veri) ÖĞRENİLİR.
# Basit bir öznitelik kullanalım: mesajdaki "şüpheli kelime sayısı".
supheli_kelimeler = ["ücretsiz", "bedava", "kazandınız", "tıklayın", "hediye", "fırsat"]

def supheli_kelime_sayisi(mesaj):
    return sum(kelime in mesaj.lower() for kelime in supheli_kelimeler)

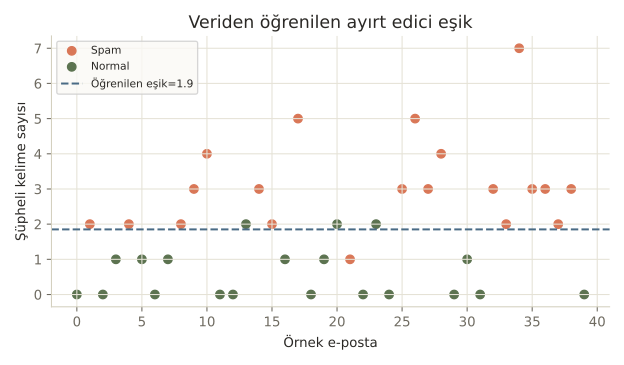
# 40 örnek e-posta simüle edelim: spam olanlarda şüpheli kelime sayısı yüksek eğilimli.
n = 40
spam_mi = rng.random(n) < 0.5
supheli_sayilar = np.where(spam_mi, rng.poisson(3, n), rng.poisson(0.5, n))

# "Öğrenme": en iyi ayırt edici eşiği VERİDEN bul (basitçe, iki grubun ortalamasının ortası).
esik = (supheli_sayilar[spam_mi].mean() + supheli_sayilar[~spam_mi].mean()) / 2
tahminler = supheli_sayilar >= esik
dogruluk = (tahminler == spam_mi).mean()

print(f"\nVeriden öğrenilen eşik: {esik:.2f} şüpheli kelime")
print(f"40 örnekte doğruluk: %{dogruluk * 100:.1f}")
print("\nBu eşiği kimse elle yazmadı — 40 örnekten HESAPLANDI. Yeni bir kelime listesi")
print("gerekmiyor: veri değişince (örn. yeni spam taktikleri) eşik yeniden öğrenilebilir.")
Veriden öğrenilen eşik: 1.85 şüpheli kelime
40 örnekte doğruluk: %90.0

Bu eşiği kimse elle yazmadı — 40 örnekten HESAPLANDI. Yeni bir kelime listesi
gerekmiyor: veri değişince (örn. yeni spam taktikleri) eşik yeniden öğrenilebilir.
%90 doğruluk — ve dikkat et, eşiği (1.85) kimse elle yazmadı. 40 örnekteki spam ve normal mesajların şüpheli kelime sayısı ortalamalarından hesaplandı. Çoğu kişi “makine öğrenmesi sihirli bir kara kutu” sanır. Değil, çünkü burada olan şey aslında çok sade: verideki iki grubun (spam/normal) istatistiksel özelliklerine bakıp, onları en iyi ayıran bir sınırı bulmak. İleride göreceğimiz karmaşık modeller (Random Forest, sinir ağları) de temelde aynı fikri çok daha sofistike şekillerde yapıyor.
Matematik
Öznitelik ve etiket
| Terim | Anlamı |
|---|---|
| Öznitelik (feature) | Modelin girdi olarak kullandığı ölçülebilir bir değer (örn. şüpheli kelime sayısı) |
| Etiket (label) | Tahmin etmeye çalıştığımız gerçek sonuç (örn. spam mi değil mi) |
| Eğitim (training) | Öznitelik ve etiket örneklerinden, aralarındaki ilişkiyi bulma süreci |
| Model | Bu ilişkiyi temsil eden, yeni verilerde tahmin yapabilen yapı (bizim örneğimizde: tek bir eşik sayısı) |
Bu dersteki “model” son derece basit — tek bir eşik değeri. Bu kursun geri kalanında göreceğimiz modeller (doğrusal regresyon, karar ağaçları, sinir ağları) aynı temel fikri — öznitelikleri etikete bağlayan bir ilişki öğrenmek — çok daha esnek biçimlerde uygular.
Kod
Nerede işe yarar
Bu “veriden öğrenme” fikri, bu kursun geri kalanının temelini oluşturuyor:
- Ürün önerileri. Bir kullanıcının hangi ürünleri beğeneceğini, geçmiş davranışlardan öğrenen sistemler.
- Fiyat tahmini. Bir evin özelliklerinden (metrekare, konum, oda sayısı) fiyatını tahmin eden modeller — 3. derste kuracağız.
- Görüntü ve dil. Bir fotoğrafta kedi mi köpek mi olduğunu, ya da bir cümlenin hangi dilde yazıldığını, kural yazmadan örneklerden öğrenen sistemler.
Bu 3 hatayı yaparsın:
- Her problemin makine öğrenmesi gerektirdiğini sanmak — basit, net kurallarla çözülebilen problemlerde kural tabanlı yaklaşım daha hızlı ve şeffaftır.
- Az sayıda örnekle (bizim 40 örneğimiz gibi) öğrenilen bir modelin her durumda genelleyeceğini varsaymak.
- “Öğrenilen” bir modelin asla hata yapmayacağını sanmak — %90 doğruluk, %10 hata payı demektir.
Kendini test et
1. Kural tabanlı sistem ile makine öğrenmesi arasındaki temel fark nedir?
- Aralarında fark yoktur
- Kural tabanlı sistemde kuralı insan yazar; makine öğrenmesinde kural örneklerden öğrenilir (doğru cevap)
- Makine öğrenmesi her zaman daha yavaştır
- Kural tabanlı sistemler asla hata yapmaz
Neden: Kural tabanlı sistemde insan açıkça 'eğer X ise Y' kuralını yazar; makine öğrenmesinde bu ilişki etiketli örneklerden algoritma tarafından çıkarılır.
2. Notebook örneğinde kural tabanlı sistem neden bir mesajı yanlış sınıflandırdı?
- Kod hatası vardı
- 'Bedava' kelimesi, elle yazılan tetikleyici kelime listesinde yoktu (doğru cevap)
- Mesaj çok uzundu
- Rastgele bir hata
Neden: Kural tabanlı sistem sadece önceden tanımlanmış kelimeleri arar; listede olmayan bir eş anlamlı (bedava) kaçırıldı — bu, elle yazılan kuralların kör noktasıdır.
3. Veriden öğrenilen eşik (1.85) nasıl hesaplandı?
- Rastgele seçildi
- Spam ve normal mesajların şüpheli kelime sayısı ortalamalarının ortası alınarak (doğru cevap)
- İnternetten indirildi
- Sabit bir değerdi, hiçbir hesaplama yapılmadı
Neden: Eşik, iki grubun (spam/normal) ortalama şüpheli kelime sayılarının ortasına yerleştirilerek veriden hesaplandı — bu basit bir "öğrenme" örneğidir.
Özet
Özet
- Kural tabanlı sistemde kuralı insan yazar; makine öğrenmesinde kural örneklerden öğrenilir.
- Öznitelik, modelin girdisi; etiket, tahmin etmeye çalıştığımız sonuçtur.
- Basit bir eşik bile, veriden öğrenilen bir "model" örneğidir.
- Makine öğrenmesi her problemde gerekli değildir — net kurallı problemlerde kural tabanlı yaklaşım hâlâ tercih edilir.
- Öğrenilen her model bir hata payı taşır — %100 doğruluk beklemek gerçekçi değildir.