

Dengesiz veri seti
Önkoşul:Sınıflandırma başarı metrikleri
Kanca
- derste hastalık taramasında dengesizliğin doğruluğu yanıltıcı yaptığını gördük. Ama sorun daha derin olabilir: bazen model, azınlık sınıfını TEK BİR ÖRNEKTE bile doğru tahmin edemez. Neden, ve nasıl düzeltilir?
Sezgi
Bir model, kayıp fonksiyonunu (ortalama hatayı) minimize etmeye çalışır. Eğer veri setinin %97’si “dolandırıcılık değil” ise, model her zaman “dolandırıcılık değil” diyerek zaten çok düşük bir ortalama hata elde edebilir — azınlık sınıfını öğrenmeye hiç “zorlanmaz”. Bu, dengesiz verinin temel tuzağıdır.
İki basit çözüm yolu var:
- class_weight=‘balanced’: azınlık sınıfındaki bir hatayı, çoğunluk sınıfındaki bir hatadan DAHA AĞIR cezalandır.
- Oversampling: azınlık sınıfının örneklerini, çoğunlukla aynı sayıya gelene kadar (tekrar tekrar) yeniden örnekle.
Mekanizma
Gerçek bir örnek: 1000 kredi kartı işleminden sadece 30’u dolandırıcılık.
Dengesiz veri: %3 dolandırıcılık
# Kredi kartı dolandırıcılığı: 1000 işlemden sadece 30'u (%3) dolandırıcılık.
n = 1000
dolandiricilik = np.zeros(n, dtype=int)
dolandiricilik[:30] = 1
rng.shuffle(dolandiricilik)

oznitelik = np.where(
    dolandiricilik == 1, rng.normal(0.7, 0.2, n), rng.normal(0.35, 0.2, n)
)
oznitelik = np.clip(oznitelik, 0, 1).reshape(-1, 1)
print(f"{n} işlem, {dolandiricilik.sum()} tanesi dolandırıcılık (%{dolandiricilik.mean() * 100:.1f})")
1000 işlem, 30 tanesi dolandırıcılık (%3.0)Düz model tamamen başarısız
model = LogisticRegression()
model.fit(oznitelik, dolandiricilik)
tahmin = model.predict(oznitelik)
print(f"Tahmin edilen dolandırıcılık sayısı: {tahmin.sum()} / gerçek: {dolandiricilik.sum()}")
print(f"Duyarlılık (recall): {recall_score(dolandiricilik, tahmin):.3f}")
print(f"Kesinlik (precision): {precision_score(dolandiricilik, tahmin):.3f}")
print("Model, azınlık sınıfını (dolandırıcılık) yakalamakta zorlanıyor -- çoğunluk sınıfına 'çekiliyor'.")
Tahmin edilen dolandırıcılık sayısı: 0 / gerçek: 30
Duyarlılık (recall): 0.000
Kesinlik (precision): 0.000
Model, azınlık sınıfını (dolandırıcılık) yakalamakta zorlanıyor -- çoğunluk sınıfına 'çekiliyor'.Model, 30 gerçek dolandırıcılık işleminden HİÇBİRİNİ yakalayamadı — duyarlılık tam olarak 0.000! Şimdi class_weight='balanced' ile deneyelim:
class_weight='balanced' çözümü
# class_weight='balanced': azınlık sınıfının HATASINI daha ağır cezalandır.
model_agirlikli = LogisticRegression(class_weight="balanced")
model_agirlikli.fit(oznitelik, dolandiricilik)
tahmin_agirlikli = model_agirlikli.predict(oznitelik)
print(f"\nclass_weight='balanced' ile tahmin edilen dolandırıcılık: {tahmin_agirlikli.sum()}")
print(f"Duyarlılık: {recall_score(dolandiricilik, tahmin_agirlikli):.3f}")
print(f"Kesinlik: {precision_score(dolandiricilik, tahmin_agirlikli):.3f}")
print(f"F1: {f1_score(dolandiricilik, tahmin_agirlikli):.3f}")
class_weight='balanced' ile tahmin edilen dolandırıcılık: 235
Duyarlılık: 0.833
Kesinlik: 0.106
F1: 0.189
Duyarlılık 0’dan 0.833’e fırladı — 30 dolandırıcılıktan 25’ini yakalıyor artık. Şimdi oversampling’i deneyelim:
Oversampling çözümü
# Azınlık sınıfını, çoğunlukla AYNI sayıya gelene kadar (yerine koyarak) yeniden örnekle.
X_azinlik = oznitelik[dolandiricilik == 1]
X_cogunluk = oznitelik[dolandiricilik == 0]
X_azinlik_buyutulmus = resample(X_azinlik, replace=True, n_samples=len(X_cogunluk), random_state=14)

X_dengeli = np.vstack([X_cogunluk, X_azinlik_buyutulmus])
y_dengeli = np.concatenate([np.zeros(len(X_cogunluk)), np.ones(len(X_azinlik_buyutulmus))])
print(f"\nOversampling sonrası: {len(y_dengeli)} satır, sınıf 0: {(y_dengeli == 0).sum()}, sınıf 1: {(y_dengeli == 1).sum()}")

model_oversample = LogisticRegression()
model_oversample.fit(X_dengeli, y_dengeli)
# Orijinal (dengesiz) test verisinde değerlendir -- gerçek dünyada veri hep dengesiz gelir.
tahmin_oversample = model_oversample.predict(oznitelik)
print(f"Duyarlılık: {recall_score(dolandiricilik, tahmin_oversample):.3f}")
print(f"Kesinlik: {precision_score(dolandiricilik, tahmin_oversample):.3f}")
print(f"F1: {f1_score(dolandiricilik, tahmin_oversample):.3f}")
Oversampling sonrası: 1940 satır, sınıf 0: 970, sınıf 1: 970
Duyarlılık: 0.800
Kesinlik: 0.104
F1: 0.184
Benzer bir iyileşme: duyarlılık 0.800. Çoğu kişi “dengesiz veri sorunu, sadece daha fazla veri toplayarak çözülür” sanır. Kısmen doğru, ama pratikte genelde mümkün değil (dolandırıcılık, nadir hastalık gibi olaylar doğası gereği az örneklenir) — bu yüzden var olan veriyi AKILLICA ağırlıklandırmak veya yeniden örneklemek, çok daha pratik bir çözümdür.
Matematik
class_weight nasıl çalışır?
| Sembol | Anlamı |
|---|---|
| ‘inci örneğin ait olduğu sınıfın ağırlığı | |
| Toplam örnek sayısı | |
| O sınıftaki örnek sayısı |
Azınlık sınıfının ‘ı küçük olduğu için büyür — yani azınlık sınıfındaki HER hatanın kayıp fonksiyonuna katkısı büyütülür. Model artık azınlık sınıfını göz ardı ederek kaçamaz; onu yanlış tahmin etmek pahalıya mal olur.
Kod
Üç yaklaşımı yan yana karşılaştıralım:
Üç yöntemin karşılaştırması
print(f"\n{'Yöntem':<25} {'Duyarlılık':>10} {'Kesinlik':>10} {'F1':>8}")
for isim, t in [("Düz model", tahmin), ("class_weight=balanced", tahmin_agirlikli), ("Oversampling", tahmin_oversample)]:
    print(f"{isim:<25} {recall_score(dolandiricilik, t):>10.3f} {precision_score(dolandiricilik, t):>10.3f} {f1_score(dolandiricilik, t):>8.3f}")
Yöntem                    Duyarlılık   Kesinlik       F1
Düz model                      0.000      0.000    0.000
class_weight=balanced          0.833      0.106    0.189
Oversampling                   0.800      0.104    0.184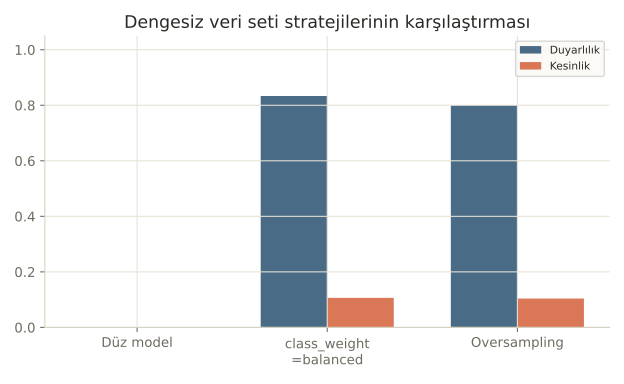
Dikkat: her iki çözümün de kesinliği düşük (~0.10) — bu 11. dersteki kesinlik-duyarlılık dengesinin bir başka görünümü. Dengesiz veri sorununu çözmek, “her şeyi mükemmel” yapmaz; sadece modelin azınlık sınıfını GÖRMEZDEN GELMESİNİ engeller.
Nerede işe yarar
Dengesiz veri, gerçek dünyada istisna değil kuraldır:
- Dolandırıcılık tespiti, hastalık taraması, arıza tahmini. “Kötü” olay her zaman nadirdir — bu tam olarak neden önemli olduklarıdır.
- class_weight, hızlı ve genelde yeterli bir ilk adım. Çoğu scikit-learn modeli bu parametreyi destekler, ek veri işleme gerektirmez.
- Oversampling/undersampling, daha fazla kontrol istediğinde. SMOTE gibi daha gelişmiş yöntemler, sadece kopyalamak yerine yeni sentetik örnekler üretir.
Bu 3 hatayı yaparsın:
- Oversampling’i eğitim/test ayrımından ÖNCE yapmak — bu, aynı örneğin hem eğitimde hem testte görünmesine (veri sızıntısı) yol açar. Her zaman önce böl, sonra sadece eğitim setini yeniden örnekle.
- Dengesiz veri sorununu çözdükten sonra hâlâ doğruluğa (accuracy) bakmak — 11. dersi hatırla, doğruluk burada hâlâ yanıltıcı.
- class_weight veya oversampling’in “sihirli bir düzeltme” olduğunu düşünmek — bu derste gördüğümüz gibi, kesinlik hâlâ düşük kalabilir; asıl kazanç azınlık sınıfının artık GÖRÜLEBİLİR olması.
Kendini test et
1. Notebook'ta düz (dengesiz) modelin duyarlılığı neden tam olarak 0.000 çıktı?
- Kod hatalıydı
- Model, azınlık sınıfını (dolandırıcılık) hiç tahmin etmeden bile ortalama hatayı düşük tutabildiği için, azınlık sınıfını öğrenmeye hiç 'zorlanmadı' (doğru cevap)
- Veri seti çok küçüktü
- scikit-learn dengesiz veriyi desteklemiyor
Neden: Veri setinin %97'si 'dolandırıcılık değil' olduğu için, model her zaman bu sınıfı tahmin ederek zaten düşük bir ortalama hata elde ediyor -- azınlık sınıfını öğrenmesi için hiçbir baskı yok.
2. class_weight='balanced' parametresi ne yapar?
- Veri setindeki örnek sayısını değiştirir
- Azınlık sınıfındaki bir hatanın kayıp fonksiyonuna katkısını büyüterek, modelin o sınıfı görmezden gelmesini zorlaştırır (doğru cevap)
- Sadece çoğunluk sınıfını siler
- Modelin hızını artırır
Neden: class_weight, azınlık sınıfındaki örneklerin ağırlığını artırarak, o sınıftaki bir hatanın toplam kayıba katkısını büyütür -- model artık azınlık sınıfını göz ardı ederek "ucuza kurtulamaz".
3. Oversampling işlemini eğitim/test ayrımından ÖNCE yapmak neden bir hatadır?
- Daha yavaş çalışır
- Aynı (kopyalanmış) örneğin hem eğitim hem test setinde görünmesine yol açarak veri sızıntısı yaratır (doğru cevap)
- Hiçbir sorun yaratmaz
- Sadece bellek kullanımını artırır
Neden: Oversampling'den önce bölme yapılmazsa, aynı örneğin kopyaları hem eğitim hem test setine dağılabilir -- bu da modelin test setinde daha önce 'gördüğü' verilerle değerlendirilmesine, yani veri sızıntısına yol açar.
Özet
Özet
- Dengesiz veri setlerinde, düz bir model azınlık sınıfını tamamen göz ardı edebilir (duyarlılık=0 bile olabilir).
- class_weight="balanced", azınlık sınıfındaki hataları daha ağır cezalandırarak modelin onu öğrenmesini zorlar.
- Oversampling, azınlık sınıfını çoğunlukla aynı sayıya gelene kadar yeniden örnekler.
- Her iki yöntem de duyarlılığı artırır ama genelde kesinlik pahasına -- bu 11. dersteki dengenin bir uzantısıdır.
- Yeniden örnekleme, HER ZAMAN eğitim/test ayrımından SONRA, sadece eğitim setine uygulanmalıdır.