

Sınıflandırma başarı metrikleri
Önkoşul:Lojistik regresyon
Kanca
200 hastadan sadece 20’sinde nadir bir hastalık var. Bir model kursan ve o model HER ZAMAN “hastalık yok” dese, doğruluğu (accuracy) yüzde kaç olurdu? Bu model işe yarar mı?
Sezgi
- derste lojistik regresyonun bir sınıf tahmini (0 veya 1) VE bir olasılık ürettiğini gördük. Bu tahminin ne kadar “iyi” olduğunu ölçmenin birden fazla yolu var, ve doğruluk (accuracy) tek başına yanıltıcı olabilir — özellikle sınıflar dengesizken.
Karmaşıklık matrisi (confusion matrix), tahminleri 4 kutuya ayırır: Doğru Pozitif (TP), Yanlış Pozitif (FP), Doğru Negatif (TN), Yanlış Negatif (FN). Buradan türeyen metrikler farklı soruları cevaplar:
- Kesinlik (precision): “Pozitif dediklerimin kaçı gerçekten pozitifti?”
- Duyarlılık (recall): “Gerçek pozitiflerin kaçını yakaladım?”
- F1: kesinlik ve duyarlılığın dengeli bir ortalaması.
Karmaşıklık matrisi
- Doğruluk (accuracy): 0.88
- Kesinlik (precision): 0.91
- Duyarlılık (recall): 0.84
- F1 skoru: 0.87
ROC eğrisi (AUC = 0.950)
Eşik=0.50 — eşik yükseldikçe kesinlik artar ama duyarlılık düşer (daha az pozitif tahmin, ama tahmin edilenler daha güvenilir). Kesikli çizgi rastgele tahmini gösterir; eğri ona ne kadar uzaksa model o kadar iyi (AUC=1 mükemmel, AUC=0.5 rastgele).
Karar eşiğini kaydır: eşik yükseldikçe kesinlik artar (daha “emin” olduğun tahminler) ama duyarlılık düşer (daha az pozitif yakalıyorsun). ROC eğrisindeki nokta da aynı anda hareket ediyor — bu üçü aslında AYNI modelin farklı eşiklerdeki hali.
Mekanizma
Gerçek bir örnekle başlayalım — nadir bir hastalığı taramak:
Dengesiz tıbbi veri
# 200 hasta, sadece 20'sinde (%10) nadir bir hastalık var -- gerçekçi bir tıbbi tarama senaryosu.
n = 200
hasta_mi = np.zeros(n, dtype=int)
hasta_mi[:20] = 1
rng.shuffle(hasta_mi)

# Test skoru: hastalarda ortalama daha yüksek ama örtüşme var (gerçekçi).
skor = np.where(hasta_mi == 1, rng.normal(0.65, 0.18, n), rng.normal(0.3, 0.15, n))
skor = np.clip(skor, 0, 1)
print(f"{n} hasta, {hasta_mi.sum()} tanesinde hastalık var (%{hasta_mi.mean() * 100:.0f})")
200 hasta, 20 tanesinde hastalık var (%10)Şimdi “aptal” bir model deneyelim — hiçbir şey öğrenmeden herkese “hastalık yok” desin:
Aptal taban çizgisi
# "Aptal" bir model: herkese "hastalık yok" de. Doğruluk (accuracy) ne kadar yüksek görünüyor?
aptal_tahmin = np.zeros(n, dtype=int)
aptal_dogruluk = accuracy_score(hasta_mi, aptal_tahmin)
aptal_recall = recall_score(hasta_mi, aptal_tahmin, zero_division=0)
print(f"'Herkese hastalık yok de' modelinin doğruluğu: {aptal_dogruluk:.3f}")
print(f"Bu modelin duyarlılığı (recall): {aptal_recall:.3f}  <- TÜM hastaları KAÇIRIYOR")
print("Doğruluk YÜKSEK görünüyor ama model tamamen İŞE YARAMAZ -- 'doğruluk tuzağı'.")
'Herkese hastalık yok de' modelinin doğruluğu: 0.900
Bu modelin duyarlılığı (recall): 0.000 <- TÜM hastaları KAÇIRIYOR
Doğruluk YÜKSEK görünüyor ama model tamamen İŞE YARAMAZ -- 'doğruluk tuzağı'.%90 doğruluk! Ama bu model TAMAMEN işe yaramaz — tek bir hastayı bile yakalayamıyor. Şimdi gerçek bir model kuralım:
Gerçek model metrikleri
esik = 0.5
tahmin = (skor >= esik).astype(int)
km = confusion_matrix(hasta_mi, tahmin)
print(f"Karmaşıklık matrisi (eşik={esik}):\n{km}")
print(f"  Doğru Negatif={km[0,0]}  Yanlış Pozitif={km[0,1]}")
print(f"  Yanlış Negatif={km[1,0]}  Doğru Pozitif={km[1,1]}")

dogruluk = accuracy_score(hasta_mi, tahmin)
kesinlik = precision_score(hasta_mi, tahmin)
duyarlilik = recall_score(hasta_mi, tahmin)
f1 = f1_score(hasta_mi, tahmin)
print(f"\nDoğruluk: {dogruluk:.3f}  Kesinlik: {kesinlik:.3f}  Duyarlılık: {duyarlilik:.3f}  F1: {f1:.3f}")
print(f"Doğruluk, aptal modelden ({aptal_dogruluk:.3f}) daha DÜŞÜK ({dogruluk:.3f}) ama duyarlılık çok daha iyi.")
Karmaşıklık matrisi (eşik=0.5):
[[159 21]
[ 5 15]]
Doğru Negatif=159 Yanlış Pozitif=21
Yanlış Negatif=5 Doğru Pozitif=15
Doğruluk: 0.870 Kesinlik: 0.417 Duyarlılık: 0.750 F1: 0.536
Doğruluk, aptal modelden (0.900) daha DÜŞÜK (0.870) ama duyarlılık çok daha iyi.Gerçek modelin doğruluğu (0.870), aptal modelden (0.900) DAHA DÜŞÜK — ama duyarlılığı 0.750, yani 20 hastadan 15’ini doğru yakalıyor. Çoğu kişi “doğruluk her zaman en önemli metrik” sanır. Değil, çünkü dengesiz veri setlerinde çoğunluk sınıfını tahmin etmek zaten yüksek doğruluk verir — asıl soru azınlık sınıfını (burada hastaları) ne kadar iyi yakaladığın.
Matematik
Karmaşıklık matrisinden türeyen metrikler
| Sembol | Anlamı |
|---|---|
| (Doğru Pozitif) | Gerçekten pozitif, model de pozitif dedi |
| (Yanlış Pozitif) | Gerçekte negatif, model YANLIŞLIKLA pozitif dedi (yanlış alarm) |
| (Yanlış Negatif) | Gerçekte pozitif, model YANLIŞLIKLA negatif dedi (kaçırılan vaka) |
Kesinlik, FP’yi cezalandırır (yanlış alarmlardan kaçınmak istediğinde önemli). Duyarlılık, FN’yi cezalandırır (vaka kaçırmaktan kaçınmak istediğinde önemli — tıbbi tarama gibi). F1, ikisi arasında harmonik bir denge kurar.
Kod
Eşiği değiştirerek kesinlik-duyarlılık dengesini gözlemleyelim:
Eşik değiştikçe denge
# Tıbbi taramada hasta KAÇIRMAMAK (yüksek recall) daha önemli olabilir -- eşiği düşürelim.
for e in [0.5, 0.4, 0.3, 0.2]:
    t = (skor >= e).astype(int)
    p = precision_score(hasta_mi, t, zero_division=0)
    r = recall_score(hasta_mi, t, zero_division=0)
    print(f"eşik={e:.1f}  kesinlik={p:.3f}  duyarlılık={r:.3f}")
print("Eşik düştükçe duyarlılık artıyor (daha az hasta kaçıyor) ama kesinlik düşüyor (daha çok yanlış alarm).")
eşik=0.5 kesinlik=0.417 duyarlılık=0.750
eşik=0.4 kesinlik=0.247 duyarlılık=1.000
eşik=0.3 kesinlik=0.161 duyarlılık=1.000
eşik=0.2 kesinlik=0.126 duyarlılık=1.000
Eşik düştükçe duyarlılık artıyor (daha az hasta kaçıyor) ama kesinlik düşüyor (daha çok yanlış alarm).Eşik 0.4’e indiğinde duyarlılık %100’e ulaşıyor (hiçbir hasta kaçmıyor) ama kesinlik %24.7’ye düşüyor (çok fazla yanlış alarm). Hangi dengenin “doğru” olduğu, hatanın MALİYETİNE bağlı — bir hastayı kaçırmak mı daha kötü, yoksa sağlıklı birini gereksiz yere endişelendirmek mi?
Son olarak, TÜM olası eşikleri aynı anda özetleyen bir metrik: ROC-AUC.
ROC-AUC: eşikten bağımsız özet
fpr, tpr, esikler = roc_curve(hasta_mi, skor)
auc = roc_auc_score(hasta_mi, skor)
print(f"\nROC-AUC: {auc:.3f}  (1.0 mükemmel, 0.5 rastgele tahmin)")
ROC-AUC: 0.946 (1.0 mükemmel, 0.5 rastgele tahmin)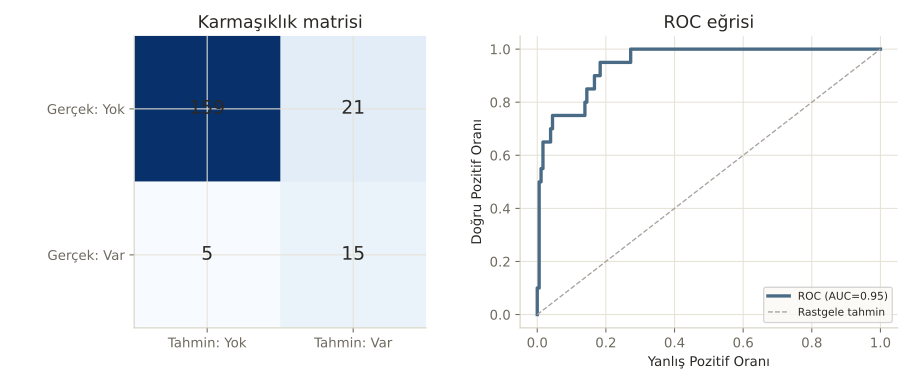
Nerede işe yarar
Doğru metriği seçmek, sınıflandırma modelinin gerçek dünyada işe yarayıp yaramayacağını belirler:
- Duyarlılık öncelikli: hastalık taraması, dolandırıcılık tespiti — bir vakayı KAÇIRMANIN maliyeti çok yüksek.
- Kesinlik öncelikli: spam filtreleme, öneri sistemleri — YANLIŞ ALARMIN (önemli bir e-postayı spam’e atmak) maliyeti yüksek.
- ROC-AUC: modelin eşikten bağımsız genel ayırt etme gücünü raporlamak, farklı modelleri karşılaştırmak için.
Bu 3 hatayı yaparsın:
- Dengesiz veri setlerinde sadece doğruluğa bakmak — bu derste gördüğümüz gibi, %90 doğruluk bile tamamen işe yaramaz bir model gizleyebilir.
- Karar eşiğini her zaman 0.5’te bırakmak — hatanın maliyeti asimetrikse (bir hata diğerinden çok daha kötüyse) eşiği buna göre ayarlamak gerekir.
- ROC-AUC’u tek başına yeterli sanmak — çok dengesiz veri setlerinde Precision-Recall eğrisi (ROC yerine) genelde daha bilgilendiricidir (12. derste göreceğiz).
Kendini test et
1. Notebook'ta 'herkese hastalık yok' diyen model neden %90 doğruluk aldı ama işe yaramaz?
- Kod hatalıydı
- Veri setinin %90'ı zaten "hastalık yok" olduğu için, hiçbir şey öğrenmeden bile yüksek doğruluk elde edilebiliyor -- ama TÜM hastaları kaçırıyor (doğru cevap)
- Model çok karmaşıktı
- Rastgele bir sonuçtu
Neden: Dengesiz bir veri setinde çoğunluk sınıfını her zaman tahmin etmek zaten yüksek doğruluk verir; bu modelin duyarlılığı (recall) tam olarak 0 -- tek bir hastayı bile yakalayamıyor.
2. Bir hastalık taramasında, bir hastayı KAÇIRMAK (yanlış negatif) çok maliyetliyse hangi metriği önceliklendirmelisin?
- Kesinlik (precision)
- Duyarlılık (recall) (doğru cevap)
- Sadece doğruluk
- Hiçbiri önemli değil
Neden: Duyarlılık, gerçek pozitiflerin kaçının yakalandığını ölçer; yanlış negatifleri (kaçırılan vakaları) azaltmak istediğinde önceliklendirilmesi gereken metrik budur.
3. Notebook'ta eşik 0.5'ten 0.4'e düşürüldüğünde duyarlılık %75'ten %100'e çıktı ama kesinlik %41.7'den %24.7'ye düştü. Bu neyi gösteriyor?
- Model bozuldu
- Kesinlik ve duyarlılık arasında bir DENGE (tradeoff) var -- birini iyileştirmek genelde diğerini kötüleştirir (doğru cevap)
- Eşiğin hiçbir etkisi yoktur
- Veri seti değişti
Neden: Eşiği düşürmek daha fazla örneği "pozitif" olarak işaretler -- bu daha fazla gerçek pozitifi yakalar (duyarlılık artar) ama aynı zamanda daha fazla yanlış alarm üretir (kesinlik düşer).
Özet
Özet
- Doğruluk (accuracy) tek başına yanıltıcı olabilir, özellikle dengesiz veri setlerinde.
- Kesinlik (precision), "pozitif dediklerinin kaçı doğruydu" sorusuna; duyarlılık (recall), "gerçek pozitiflerin kaçını yakaladın" sorusuna cevap verir.
- F1 skoru, kesinlik ve duyarlılık arasında dengeli bir özet sunar.
- Karar eşiğini değiştirmek, kesinlik ile duyarlılık arasında bir denge (tradeoff) yaratır.
- ROC-AUC, modelin TÜM eşiklerdeki genel ayırt etme gücünü, tek bir sayıyla özetler.