

Regresyon başarı metrikleri
Önkoşul:Çoklu doğrusal regresyon
Kanca
“MSE’si 1.23 olan bir model iyi mi?” Bu soruya cevap vermek zor, çünkü 1.23’ün “iyi” olup olmadığı birime bağlı. Peki MAE, RMSE, R² gibi başka metrikler neden var, ve hangisini ne zaman kullanmalısın?
Sezgi
Bir modelin ne kadar iyi tahmin ettiğini tek bir sayıyla özetlemek istiyoruz. Ama “hata” farklı şekillerde ölçülebilir:
- MAE (ortalama mutlak hata): her hatanın MUTLAK değerini al, ortalamasını hesapla. “Ortalama olarak ne kadar yanılıyorum?”
- MSE (ortalama karesel hata): her hatanın KARESİNİ al, ortalamasını hesapla. Büyük hataları orantısız şekilde cezalandırır.
- RMSE (karekök karesel hata): MSE’nin karekökü. MSE’nin birimini (örn. “fiyat²”) geri “fiyat” birimine döndürür, böylece yorumlanabilir olur.
- R² (belirleme katsayısı): 0 ile 1 arasında (bazen negatif de olabilir), “modelin veri değişimini ne kadar açıkladığını” gösterir. 1’e yakın = çok iyi, 0 = sadece ortalamayı tahmin eden modelden farksız.
En önemli fark: MSE/RMSE, hatanın KARESİNİ aldığı için büyük hatalara (aykırı değerlere) çok daha duyarlıdır. MAE ise her hataya eşit ağırlık verir.
Mekanizma
Önce bir model kurup dört metriği birden hesaplayalım:
Veri ve model
n = 25
metrekare = 50 + rng.random(n) * 150
fiyat = 2 + 0.08 * metrekare + rng.normal(0, 1.2, size=n)

X = metrekare.reshape(-1, 1)
model = LinearRegression()
model.fit(X, fiyat)
tahmin = model.predict(X)
print(f"İlk 5 gerçek fiyat: {fiyat[:5].round(2)}")
print(f"İlk 5 tahmin:       {tahmin[:5].round(2)}")
İlk 5 gerçek fiyat: [13.28 13.75 14.66 8.64 9.74]
İlk 5 tahmin: [13.1 16.05 14.74 8.77 9.58]Dört temel metrik
mae = mean_absolute_error(fiyat, tahmin)
mse = mean_squared_error(fiyat, tahmin)
rmse = np.sqrt(mse)
r2 = r2_score(fiyat, tahmin)
print(f"MAE  (ortalama mutlak hata): {mae:.3f}")
print(f"MSE  (ortalama karesel hata): {mse:.3f}")
print(f"RMSE (karekök karesel hata): {rmse:.3f}")
print(f"R²   (açıklanan varyans oranı): {r2:.3f}")
MAE (ortalama mutlak hata): 0.865
MSE (ortalama karesel hata): 1.232
RMSE (karekök karesel hata): 1.110
R² (açıklanan varyans oranı): 0.898RMSE (1.110), MAE’ye (0.865) yakın ama biraz daha büyük — bu normal, çünkü RMSE büyük hataları daha ağır cezalandırır. R²=0.898 ise “modelimiz fiyattaki değişimin yaklaşık %90’ını metrekareyle açıklıyor” demek.
Şimdi asıl önemli deneyi yapalım: tek bir veri noktasına büyük bir hata ekleyelim (örneğin bir veri girişi hatası) ve MAE ile RMSE’nin buna nasıl tepki verdiğini karşılaştıralım:
Bir aykırı değerin etkisi
# Tek bir noktada büyük bir hata simüle edelim (örn. veri girişi hatası: fiyat 15 birim yüksek girilmiş)
fiyat_aykirili = fiyat.copy()
fiyat_aykirili[0] = fiyat_aykirili[0] + 15

mae_aykiri = mean_absolute_error(fiyat_aykirili, tahmin)
rmse_aykiri = np.sqrt(mean_squared_error(fiyat_aykirili, tahmin))

print(f"Aykırı değer ÖNCESİ -> MAE: {mae:.3f}  RMSE: {rmse:.3f}")
print(f"Aykırı değer SONRASI -> MAE: {mae_aykiri:.3f}  RMSE: {rmse_aykiri:.3f}")
print(f"MAE artışı: %{(mae_aykiri / mae - 1) * 100:.1f}   RMSE artışı: %{(rmse_aykiri / rmse - 1) * 100:.1f}")
Aykırı değer ÖNCESİ -> MAE: 0.865 RMSE: 1.110
Aykırı değer SONRASI -> MAE: 1.465 RMSE: 3.231
MAE artışı: %69.4 RMSE artışı: %191.1Tek bir noktadaki hata, MAE’yi %69 artırırken RMSE’yi %191 artırdı. Çoğu kişi “MAE ve RMSE ikisi de ‘ortalama hata’ ölçer, aralarında büyük fark olmaz” sanır. Değil, çünkü RMSE karesel olduğu için büyük hatalara orantısız ağırlık verir — veri setinde aykırı değerler varsa (ve onlara özellikle duyarlı olmak istiyorsan) RMSE’yi izlemelisin; aykırı değerlerin etkisini azaltmak istiyorsan MAE daha “adil” bir özet sağlar.
Matematik
Dört metriğin formülü
| Sembol | Anlamı |
|---|---|
| i’inci noktadaki hatanın mutlak değeri | |
| Modelin AÇIKLAYAMADIĞI toplam kare hata | |
| Verideki TOPLAM varyasyon (eğer hiç model kurmasaydık) |
‘nin sezgisi: payda, “hiç model kurmasaydık ne kadar hata yapardık” (her zaman ortalamayı tahmin etmek); pay, “modelimiz gerçekte ne kadar hata yapıyor.” Oran ne kadar küçükse (model ne kadar az hata yapıyorsa), o kadar 1’e yaklaşır.
Kod
‘nin taban noktasını somutlaştıralım — hiçbir şey öğrenmeyen, her zaman ortalamayı tahmin eden bir “modelin” ‘si tam olarak sıfırdır:
R²'nin taban noktası
# R^2'yi yorumlamak için taban çizgisi: her zaman ORTALAMAYI tahmin eden "tembel" model
tahmin_ortalama = np.full_like(fiyat, fiyat.mean())
r2_taban = r2_score(fiyat, tahmin_ortalama)
print(f"Sadece ortalamayı tahmin eden modelin R²'si: {r2_taban:.3f}  (tanım gereği her zaman 0)")
print(f"Bizim regresyon modelimizin R²'si:           {r2:.3f}")
print(f"Yorum: modelimiz, fiyattaki değişimin %{r2 * 100:.1f}'ini metrekareyle açıklıyor.")
Sadece ortalamayı tahmin eden modelin R²'si: 0.000 (tanım gereği her zaman 0)
Bizim regresyon modelimizin R²'si: 0.898
Yorum: modelimiz, fiyattaki değişimin %89.8'ini metrekareyle açıklıyor.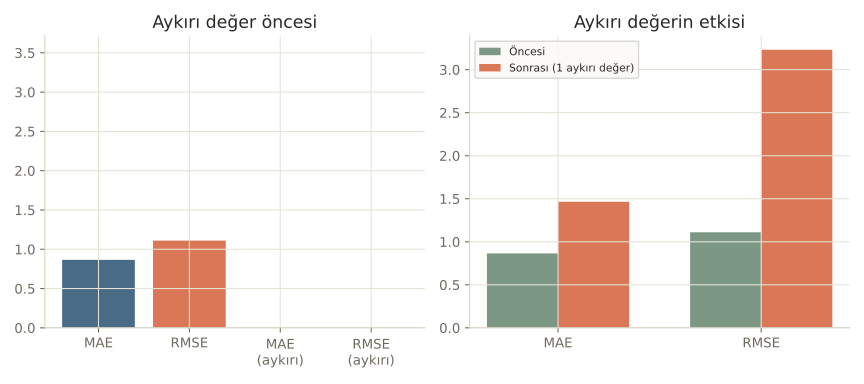
Nerede işe yarar
Doğru metriği seçmek, model geliştirmenin görünmez ama kritik bir parçasıdır:
- RMSE tercih et eğer büyük hatalar orantısız derecede kötüyse (örn. bir ilaç dozu tahmininde büyük bir hata küçük bir hatadan çok daha tehlikeli).
- MAE tercih et eğer veri setinde aykırı değerler varsa ve bunların metriği “domine etmesini” istemiyorsan, ya da her hatayı eşit önemsiyorsan.
- R² kullan modelin genel açıklayıcılığını, farklı veri setleri arasında karşılaştırılabilir şekilde raporlamak için.
Bu 3 hatayı yaparsın:
- Sadece tek bir metriğe bakıp modelin “iyi” olduğuna karar vermek — MAE düşük ama RMSE yüksekse, veri setinde gözden kaçan aykırı değerler olabilir.
- R²’yi “modelin doğruluğu” gibi yorumlamak — R² sadece varyansın ne kadarının açıklandığını gösterir, tahminlerin ne kadar İSABETLİ olduğunu (birim cinsinden) göstermez.
- Farklı ölçekteki iki veri setinin MSE/RMSE değerlerini doğrudan karşılaştırmak — birim farklıysa (TL vs bin TL) sayılar karşılaştırılamaz, R² daha adil bir karşılaştırma sağlar.
Kendini test et
1. Bir veri setinde birkaç büyük aykırı değer varsa, hangi metrik bu aykırı değerlerden EN AZ etkilenir?
- RMSE
- MSE
- MAE (doğru cevap)
- Hepsi eşit etkilenir
Neden: MAE, hatanın mutlak değerini alır ve her hataya eşit ağırlık verir; MSE ve RMSE ise hatanın karesini aldığı için büyük hatalara orantısız ağırlık verir.
2. Sadece ortalamayı tahmin eden (hiçbir şey öğrenmeyen) bir modelin R²'si kaçtır?
- 1
- -1
- 0 (doğru cevap)
- Veri setine göre değişir
Neden: R²'nin tanımı gereği, sadece ortalamayı tahmin eden bir 'model' için pay ve payda eşit olur, oran 1 çıkar ve 1-1=0 sonucunu verir.
3. Notebook'ta tek bir veri noktasına büyük bir hata eklendiğinde RMSE neden MAE'den çok daha fazla arttı (%191 vs %69)?
- RMSE hesaplaması hatalıydı
- RMSE, hatanın karesini aldığı için büyük tek bir hata orantısız şekilde toplam hatayı artırıyor (doğru cevap)
- Veri seti çok küçüktü
- Tesadüf
Neden: RMSE karesel bir metrik olduğu için, büyüklüğü artan bir hata, metriğe karesiyle orantılı katkı yapar — bu yüzden tek bir büyük hata bile RMSE'yi MAE'den çok daha fazla yükseltir.
Özet
Özet
- MAE, hataların mutlak değerinin ortalamasıdır — her hataya eşit ağırlık verir.
- MSE/RMSE, hataların KARESİNİ aldığı için büyük hatalara (aykırı değerlere) çok daha duyarlıdır.
- RMSE, MSE'nin karekökü olduğu için orijinal birimle yorumlanabilir.
- R², modelin veri değişiminin ne kadarını açıkladığını gösterir; hiçbir şey öğrenmeyen bir model için tanım gereği 0'dır.
- Veri setinde aykırı değerler varsa MAE ve RMSE'yi birlikte incelemek, tek bir metriğe güvenmekten daha güvenlidir.