

Çapraz doğrulama türleri
Önkoşul:Ridge, Lasso, Elastic Net
Kanca
- derste tek bir eğitim/test ayrımı kullandık. Ama ya o TEK ayrım şanslı (ya da şanssız) çıktıysa? Ve veri, sınıf dengesizliği ya da zaman sırası gibi özel bir yapı taşıyorsa, “veriyi rastgele böl” her zaman doğru mu?
Sezgi
Çapraz doğrulama (cross-validation), veriyi TEK BİR şekilde değil, BİRDEN FAZLA şekilde bölüp her birinde test ederek daha güvenilir bir performans tahmini verir. Ama “nasıl bölünür” sorusunun cevabı, verinin yapısına göre değişir:
- K-Fold: veri K parçaya bölünür, her parça sırayla test seti olur. Basit ama veri sıralıysa (örn. sınıflar bir arada duruyorsa) sorun çıkarabilir.
- Stratified K-Fold: her parçada sınıf ORANI korunur — dengesiz veri setlerinde şart.
- TimeSeriesSplit: test her zaman eğitimden SONRA gelir — zaman serisi verisinde gelecek bilgisinin eğitime sızmasını önler.
Veri, sırayla eşit parçalara bölünür. Sınıf dağılımı hesaba katılmaz.
eğitim test sınıf 0 (alt şerit) sınıf 1 (alt şerit)
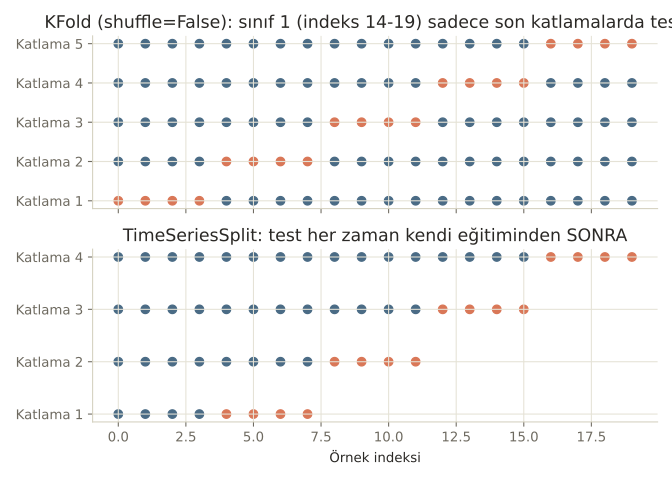
Her katlamanın test setindeki sınıf 1 sayısı: 0, 0, 0, 2, 4. İlk katlamalarda sınıf 1'den HİÇ örnek yok -- bu katlamalarda model azınlık sınıfını hiç göremeden test ediliyor.
Sekmeler arasında geçiş yap: K-Fold’da ilk katlamalarda “sınıf 1” hiç görünmüyor (çünkü veri sınıfa göre sıralı duruyor). Stratified K-Fold’da her katlamada en az bir tane var. Zaman Serisi’nde ise turuncu (test) hücreler her zaman mavi (eğitim) hücrelerin SAĞINDA — asla solunda.
Mekanizma
Gerçek sayılarla doğrulayalım. Önce sınıfları sıralı duran (dengesiz) bir veri seti:
Sıralı, dengesiz veri
# 20 örnek, sınıf ETİKETLERİ sıralı duruyor: önce 14 tane sınıf 0, sonra 6 tane sınıf 1.
# (Gerçek hayatta veri genelde toplama sırasına göre böyle "sıralı" gelir.)
n = 20
y_sinif = np.array([0] * 14 + [1] * 6)
X_sinif = rng.normal(0, 1, size=(n, 3))
print(f"Toplam: {n} örnek, sınıf 0: {(y_sinif == 0).sum()}, sınıf 1: {(y_sinif == 1).sum()}")
Toplam: 20 örnek, sınıf 0: 14, sınıf 1: 6Sıradan KFold'un sorunu
kfold = KFold(n_splits=5, shuffle=False)
print("KFold (shuffle=False) -- her katlamanın test setindeki sınıf 1 sayısı:")
for i, (_, test_idx) in enumerate(kfold.split(X_sinif)):
    sayi = (y_sinif[test_idx] == 1).sum()
    print(f"  Katlama {i + 1}: {sayi} adet sınıf 1  (test indeksleri: {test_idx.tolist()})")
print("İlk katlamalarda sınıf 1 hiç YOK -- model bu katlamalarda azınlık sınıfını hiç görmeden test ediliyor.")
KFold (shuffle=False) -- her katlamanın test setindeki sınıf 1 sayısı:
Katlama 1: 0 adet sınıf 1 (test indeksleri: [0, 1, 2, 3])
Katlama 2: 0 adet sınıf 1 (test indeksleri: [4, 5, 6, 7])
Katlama 3: 0 adet sınıf 1 (test indeksleri: [8, 9, 10, 11])
Katlama 4: 2 adet sınıf 1 (test indeksleri: [12, 13, 14, 15])
Katlama 5: 4 adet sınıf 1 (test indeksleri: [16, 17, 18, 19])
İlk katlamalarda sınıf 1 hiç YOK -- model bu katlamalarda azınlık sınıfını hiç görmeden test ediliyor.İlk 3 katlamada sınıf 1’den HİÇ örnek yok. Bu katlamalarda model, azınlık sınıfını hiç görmeden test ediliyor — test skoru güvenilmez olur. StratifiedKFold bunu düzeltir:
StratifiedKFold çözümü
stratifiedkfold = StratifiedKFold(n_splits=5, shuffle=False)
print("StratifiedKFold -- her katlamanın test setindeki sınıf 1 sayısı:")
for i, (_, test_idx) in enumerate(stratifiedkfold.split(X_sinif, y_sinif)):
    sayi = (y_sinif[test_idx] == 1).sum()
    print(f"  Katlama {i + 1}: {sayi} adet sınıf 1  (test indeksleri: {test_idx.tolist()})")
print("Her katlamada en az 1 sınıf 1 örneği var -- oran korunuyor.")
StratifiedKFold -- her katlamanın test setindeki sınıf 1 sayısı:
Katlama 1: 1 adet sınıf 1 (test indeksleri: [0, 1, 2, 14])
Katlama 2: 1 adet sınıf 1 (test indeksleri: [3, 4, 5, 15])
Katlama 3: 1 adet sınıf 1 (test indeksleri: [6, 7, 8, 16])
Katlama 4: 1 adet sınıf 1 (test indeksleri: [9, 10, 11, 17])
Katlama 5: 2 adet sınıf 1 (test indeksleri: [12, 13, 18, 19])
Her katlamada en az 1 sınıf 1 örneği var -- oran korunuyor.Şimdi asıl çarpıcı deneye gelelim — zaman sırası olan bir veride KARIŞTIRILMIŞ bir KFold kullanırsak ne olur?
Karıştırılmış KFold vs TimeSeriesSplit
# Otokorelasyonlu (geçmişe bağımlı) bir zaman serisi: gürültü kendi geçmişinden etkileniyor.
m = 80
gurultu = np.zeros(m)
for t in range(1, m):
    gurultu[t] = 0.9 * gurultu[t - 1] + rng.normal(0, 1)
y_zaman = 0.05 * np.arange(m) + gurultu
X_zaman = np.arange(m).reshape(-1, 1)

model = LinearRegression()
kfold_karistirilmis = KFold(n_splits=5, shuffle=True, random_state=1)
zaman_split = TimeSeriesSplit(n_splits=5)

skor_karistirilmis = cross_val_score(model, X_zaman, y_zaman, cv=kfold_karistirilmis, scoring="r2")
skor_zaman = cross_val_score(model, X_zaman, y_zaman, cv=zaman_split, scoring="r2")

print(f"Karıştırılmış KFold R² (ortalama): {skor_karistirilmis.mean():.3f}")
print(f"TimeSeriesSplit R² (ortalama):     {skor_zaman.mean():.3f}")
print("Karıştırılmış KFold, gelecekteki noktaları eğitime sızdırarak YAPAY OLARAK iyi görünüyor.")
Karıştırılmış KFold R² (ortalama): 0.310
TimeSeriesSplit R² (ortalama): -3.710
Karıştırılmış KFold, gelecekteki noktaları eğitime sızdırarak YAPAY OLARAK iyi görünüyor.Karıştırılmış KFold, R²=0.310 ile “makul” bir model gibi görünüyor. Ama TimeSeriesSplit ile gerçek sonuç R²=-3.710 — yani model, sadece ORTALAMAYI tahmin etmekten bile çok daha kötü! Çoğu kişi “çapraz doğrulama her zaman rastgele karıştırmalı, bu daha ‘adil’” sanır. Değil, çünkü zaman serisi verisinde karıştırma, gelecekteki noktaları eğitim setine sokuyor — model, “gelecekte ne olacağını bilerek” test ediliyor, bu da veri sızıntısının (16. veri bilimi dersini hatırla) klasik bir örneği.
Matematik
K-Fold ortalama skoru
| Sembol | Anlamı |
|---|---|
| Katlama (fold) sayısı | |
| ‘inci katlamada, o katlamanın EĞİTİM verisiyle kurulan model | |
| ‘inci katlamanın test verisi (diğer katlamalarda hiç kullanılmamış) |
Fark sadece Test’nin NASIL seçildiğinde: K-Fold rastgele/sıralı böler, Stratified sınıf oranını korur, TimeSeriesSplit zaman sırasını korur. Formül aynı kalır — hangi bölme stratejisinin kullanıldığı, verinin yapısına bağlıdır.
Kod
Nerede işe yarar
Doğru çapraz doğrulama türünü seçmek, güvenilir bir performans tahmininin ön koşuludur:
- Stratified K-Fold: sınıflandırma problemlerinde, özellikle dengesiz veri setlerinde (11. ders: dengesiz veri seti) neredeyse her zaman varsayılan seçim olmalı.
- TimeSeriesSplit: borsa tahmini, talep tahmini, sensör verisi gibi ZAMANA bağlı her problemde şart — aksi halde sonuçların hepsi yanıltıcı derecede iyimser çıkar.
- Düz K-Fold: veri zaman sırası taşımıyorsa ve sınıflar (varsa) zaten dengeliyse yeterlidir.
Bu 3 hatayı yaparsın:
- Zaman serisi verisinde rastgele KFold veya
shuffle=Truekullanmak — bu, gelecekteki bilgiyi eğitime sızdırır ve sonuçları güvenilmez kılar. - Dengesiz sınıflandırma problemlerinde düz KFold kullanmak — bazı katlamalar azınlık sınıfını hiç görmeyebilir.
- Çapraz doğrulama skorunu TEK bir sayı olarak rapor edip katlamalar arasındaki VARYANSA hiç bakmamak — katlamalar arasında büyük fark varsa model kararsızdır.
Kendini test et
1. Zaman serisi verisinde rastgele karıştırılmış (shuffle=True) bir KFold kullanmak neden sorunludur?
- Daha yavaş çalışır
- Gelecekteki veri noktaları eğitim setine girebilir, bu da model performansını yapay olarak iyi gösterir (doğru cevap)
- Sorun değildir, her zaman güvenlidir
- Sadece küçük veri setlerinde sorun olur
Neden: Karıştırma, zaman sırasını bozar ve model gelecekteki noktaları 'görerek' eğitilip geçmiş bir noktada test edilebilir -- bu veri sızıntısıdır ve sonuçları yapay olarak iyimser gösterir.
2. Dengesiz bir sınıflandırma probleminde (örn. %90 sınıf A, %10 sınıf B) hangi çapraz doğrulama türü tercih edilmelidir?
- Düz KFold
- Stratified K-Fold (doğru cevap)
- TimeSeriesSplit
- Hiçbiri, tek bir ayrım yeterli
Neden: Stratified K-Fold, her katlamada sınıf oranını korur -- bu sayede azınlık sınıfı her katlamada temsil edilir, düz KFold ise bazı katlamalarda azınlık sınıfını hiç içermeyebilir.
3. Notebook'ta karıştırılmış KFold R²=0.310 gösterirken TimeSeriesSplit R²=-3.710 gösterdi. Bu büyük fark neyi kanıtlıyor?
- TimeSeriesSplit kodu hatalı
- Karıştırılmış KFold'un skoru, gelecekteki veriyi eğitime sızdırdığı için gerçekçi değil -- TimeSeriesSplit'in düşük skoru daha DOĞRU bir tahmin (doğru cevap)
- Model çok kötü kurulmuş
- İki yöntem de aynı şeyi ölçüyor, fark önemsiz
Neden: Otokorelasyonlu (geçmişe bağımlı) bir zaman serisinde karıştırma, test noktalarına komşu geçmiş/gelecek bilgisinin eğitime sızmasına yol açar -- bu yüzden TimeSeriesSplit sonucu, gerçek dünyada modelin ne kadar başarılı olacağının çok daha dürüst bir tahminidir.
Özet
Özet
- Çapraz doğrulama, veriyi birden fazla şekilde bölüp test ederek tek bir ayrımdan daha güvenilir bir performans tahmini verir.
- Düz K-Fold, veri sıralı veya dengesizse bazı katlamalarda bir sınıfı hiç görmeyebilir.
- Stratified K-Fold, her katlamada sınıf oranını koruyarak bu sorunu çözer.
- TimeSeriesSplit, testi her zaman kendi eğitiminden SONRAYA yerleştirerek zaman serisi verisinde veri sızıntısını önler.
- Zaman serisi verisinde rastgele karıştırma kullanmak, sonuçları yapay olarak iyimser gösteren ciddi bir hatadır.