

Gradient Boosting
Önkoşul:AdaBoost
Kanca
- derste AdaBoost’un yanlış sınıflandırılan örneklerin AĞIRLIĞINI artırdığını gördük. Gradient Boosting, aynı “sırayla düzelt” fikrini farklı bir açıdan uyguluyor: her yeni model, bir öncekinin HATASINI (kalıntısını) doğrudan tahmin etmeye çalışıyor.
Sezgi
Gradient Boosting, en basit bir tahminle (genelde ortalama) başlar, sonra her adımda bir önceki modelin YAPTIĞI HATAYA (kalıntı/residual) yeni bir küçük ağaç uydurup bunu toplama ekler. Fikir şu: eğer model bir evi 5 birim eksik tahmin ediyorsa, bir sonraki ağaç doğrudan “bu evler için +5 ekle” demeyi öğrenmeye çalışır.
“Gradient” (gradyan) kelimesi buradan geliyor: her yeni ağaç, kayıp fonksiyonunun GRADYANI yönünde (4. dersteki gradyan inişini hatırla) küçük bir adım atıyor — ama bu adımı bir sayı güncellemesiyle değil, YENİ BİR AĞAÇ ekleyerek atıyor.
Mekanizma
Eğrisel bir fiyat-metrekare ilişkisiyle başlayalım:
Eğrisel ev fiyatı verisi
# Ev fiyatı, metrekareyle EĞRİSEL bir ilişki taşıyor (6. dersteki polinom örneğine benzer).
n = 80
metrekare = rng.uniform(40, 200, n)
fiyat = 3 + 0.01 * metrekare + 0.0007 * metrekare**2 + rng.normal(0, 1.2, n)
X = metrekare.reshape(-1, 1)
print(f"{n} ev, fiyat aralığı: {fiyat.min():.2f}-{fiyat.max():.2f}")
80 ev, fiyat aralığı: 2.52-34.03Model 0: sadece ortalama
# Gradient Boosting'in başlangıcı: en basit tahmin, ORTALAMA.
tahmin_0 = np.full(n, fiyat.mean())
mse_0 = mean_squared_error(fiyat, tahmin_0)
print(f"Model 0 (sadece ortalama): MSE = {mse_0:.3f}")

kalinti_1 = fiyat - tahmin_0
print(f"İlk kalıntıların (residuals) std sapması: {kalinti_1.std():.3f}")
print("Gradient Boosting'in fikri: bir sonraki ağacı fiyata değil, bu KALINTIYA uydur.")
Model 0 (sadece ortalama): MSE = 74.645
İlk kalıntıların (residuals) std sapması: 8.640
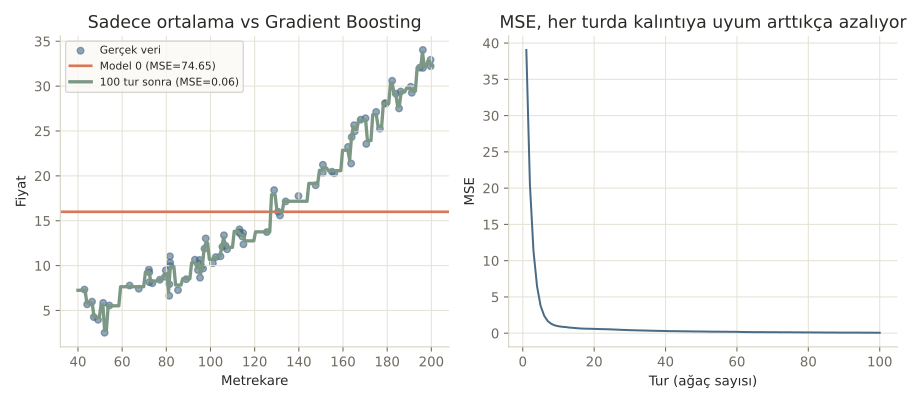
Gradient Boosting'in fikri: bir sonraki ağacı fiyata değil, bu KALINTIYA uydur.En basit başlangıç: her eve aynı (ortalama) fiyatı ver. MSE=74.645 — kötü ama bir başlangıç noktası. Şimdi elle 3 tur boyunca, kalıntıya küçük ağaçlar uydurup ekleyelim:
Elle 3 tur: kalıntıya uyum
ogrenme_orani = 0.3
tahmin = tahmin_0.copy()
for tur in range(1, 4):
    kalinti = fiyat - tahmin
    agac = DecisionTreeRegressor(max_depth=2, random_state=tur)
    agac.fit(X, kalinti)
    tahmin = tahmin + ogrenme_orani * agac.predict(X)
    mse = mean_squared_error(fiyat, tahmin)
    print(f"Tur {tur}: kalıntıya uydurulan yeni ağaç eklendi -> MSE = {mse:.3f}")
print("Her turda, bir önceki modelin HATASINA (kalıntıya) yeni bir küçük ağaç uyduruluyor ve toplama ekleniyor.")
Tur 1: kalıntıya uydurulan yeni ağaç eklendi -> MSE = 39.049
Tur 2: kalıntıya uydurulan yeni ağaç eklendi -> MSE = 20.529
Tur 3: kalıntıya uydurulan yeni ağaç eklendi -> MSE = 11.332
Her turda, bir önceki modelin HATASINA (kalıntıya) yeni bir küçük ağaç uyduruluyor ve toplama ekleniyor.MSE, 74.645’ten 39.049’a, sonra 20.529’a, sonra 11.332’ye düşüyor — her tur, bir önceki hatanın bir kısmını “yamıyor”. Şimdi 100 tur çalıştıralım:
100 tur Gradient Boosting
gb = GradientBoostingRegressor(n_estimators=100, max_depth=2, learning_rate=0.3, random_state=15)
gb.fit(X, fiyat)
mse_gb = mean_squared_error(fiyat, gb.predict(X))
print(f"\n100 turluk tam Gradient Boosting: MSE = {mse_gb:.3f}")
print(f"Model 0'a (sadece ortalama, MSE={mse_0:.3f}) göre {mse_0 / mse_gb:.1f} kat iyileşme.")
100 turluk tam Gradient Boosting: MSE = 0.062
Model 0'a (sadece ortalama, MSE=74.645) göre 1205.6 kat iyileşme.
MSE 0.062’ye düştü — ortalama tahminden 1205 kat daha iyi (bu, EĞİTİM verisi üzerindeki MSE; az sonra bunun neden tek başına yeterli bir ölçüt olmadığını göreceğiz).
Matematik
Gradient Boosting'in aşamalı güncelleme kuralı
| Sembol | Anlamı |
|---|---|
| Başlangıç modeli — basitçe hedefin ortalaması | |
| ‘inci turda eklenen küçük ağaç — bir önceki modelin KALINTISINA uydurulur | |
| (eta) | Öğrenme oranı — her yeni ağacın toplama ne kadar “güçlü” katılacağını belirler |
Kare hata (MSE) kaybı için, kalıntıya () uyum sağlamak, matematiksel olarak kaybın GRADYANI yönünde adım atmakla AYNI şeydir — bu yüzden “Gradient” Boosting adını taşır. 4. dersteki gradyan inişiyle aynı mantık, farklı bir uygulama.
Kod
Öğrenme oranının etkisini, hem eğitim hem çapraz doğrulama MSE’siyle inceleyelim:
Öğrenme oranının etkisi
from sklearn.model_selection import cross_val_score

for lr in [0.01, 0.1, 0.3, 1.0]:
    m = GradientBoostingRegressor(n_estimators=100, max_depth=2, learning_rate=lr, random_state=15)
    m.fit(X, fiyat)
    mse_egitim = mean_squared_error(fiyat, m.predict(X))
    mse_cv = -cross_val_score(m, X, fiyat, cv=5, scoring="neg_mean_squared_error").mean()
    print(f"learning_rate={lr:<5} eğitim MSE = {mse_egitim:.3f}   çapraz doğrulama MSE = {mse_cv:.3f}")
print("\nEn iyi ÇAPRAZ DOĞRULAMA skoru learning_rate=0.1'de (1.895) -- learning_rate=1.0 eğitim verisine")
print("MÜKEMMEL uyuyor (MSE=0.000) ama çapraz doğrulaması (2.619) daha KÖTÜ: klasik aşırı öğrenme (7. ders).")
learning_rate=0.01 eğitim MSE = 12.350 çapraz doğrulama MSE = 14.584
learning_rate=0.1 eğitim MSE = 0.391 çapraz doğrulama MSE = 1.895
learning_rate=0.3 eğitim MSE = 0.062 çapraz doğrulama MSE = 2.410
learning_rate=1.0 eğitim MSE = 0.000 çapraz doğrulama MSE = 2.619
En iyi ÇAPRAZ DOĞRULAMA skoru learning_rate=0.1'de (1.895) -- learning_rate=1.0 eğitim verisine
MÜKEMMEL uyuyor (MSE=0.000) ama çapraz doğrulaması (2.619) daha KÖTÜ: klasik aşırı öğrenme (7. ders).En düşük ÇAPRAZ DOĞRULAMA hatası learning_rate=0.1’de (1.895) — learning_rate=1.0 eğitim verisine neredeyse mükemmel uyuyor (MSE=0.000) ama çapraz doğrulaması daha KÖTÜ (2.619). Çoğu kişi “eğitim hatası ne kadar düşükse model o kadar iyidir” sanır. 7. dersten hatırlarsak yanlış, çünkü eğitim hatasının sıfıra yaklaşması, modelin veriye (gürültüsüyle birlikte) aşırı uyduğunun işareti olabilir — asıl güvenilir ölçüt, hiç görmediği veride (çapraz doğrulama) nasıl performans gösterdiğidir.
Nerede işe yarar
Gradient Boosting, tablo (yapılandırılmış) verilerde en güçlü yöntemlerden biridir:
- Yapılandırılmış/tablo verilerde en iyi performans gösteren yöntemlerden. Görüntü ve metin dışındaki çoğu problemde (finans, sağlık, e-ticaret), Gradient Boosting türevleri genelde en yüksek doğruluğu verir.
- XGBoost, LightGBM (23-24. ders) gibi endüstri standardı araçların temeli. Bu dersteki fikri anlamak, o araçları anlamayı doğrudan kolaylaştırır.
- Hem regresyon hem sınıflandırmada kullanılabilir. Kayıp fonksiyonu değiştirilerek (MSE yerine log-loss gibi) aynı çerçeve sınıflandırmaya uyarlanabilir.
Bu 3 hatayı yaparsın:
- Sadece eğitim MSE’sine bakıp “model harika” diye sevinmek — bu derste gördüğümüz gibi, düşük eğitim hatası aşırı öğrenmenin işareti olabilir.
- Öğrenme oranı ve ağaç sayısını birbirinden BAĞIMSIZ ayarlamak — düşük öğrenme oranı genelde DAHA FAZLA ağaç gerektirir (bu derste lr=0.01, 100 turda bile yetersiz kaldı).
- Gradient Boosting’i Random Forest gibi paralelleştirebileceğini sanmak — AdaBoost gibi SIRALIDIR, her ağaç bir öncekine bağımlıdır.
Kendini test et
1. Gradient Boosting'te her yeni ağaç neyi tahmin etmeye çalışır?
- Orijinal hedef değişkeni (y) doğrudan
- Bir önceki modelin HATASINI (kalıntı/residual) -- yani gerçek değer ile o ana kadarki tahmin arasındaki farkı (doğru cevap)
- Rastgele bir sayı
- Sadece en son eklenen ağacın çıktısını
Neden: Her yeni ağaç, bir önceki toplam modelin kalıntısına (y - F_{m-1}) uydurulur; bu kalıntıyı tahmin edip toplama eklemek, modelin hatasını kademeli olarak azaltır.
2. Notebook'ta learning_rate=1.0 eğitim MSE'sini 0.000'a indirdi ama çapraz doğrulama MSE'si (2.619), learning_rate=0.1'in çapraz doğrulama MSE'sinden (1.895) daha KÖTÜYDÜ. Bu neyi gösteriyor?
- Kod hatalıydı
- Eğitim hatasının sıfıra yaklaşması aşırı öğrenmenin işareti olabilir -- gerçek performans göstergesi çapraz doğrulamadır (doğru cevap)
- learning_rate=1.0 her zaman en iyisidir
- Çapraz doğrulama güvenilmezdir
Neden: 7. dersteki bias-variance dengesinin bir örneği: düşük eğitim hatası, modelin veriye (gürültüsüyle) aşırı uyduğunu gösterebilir; çapraz doğrulama gerçek genelleme performansını ölçer.
3. Gradient Boosting ile AdaBoost (21. ders) arasındaki temel benzerlik nedir?
- İkisi de paralel çalışır
- İkisi de modelleri SIRAYLA kurar, her yeni model bir öncekinin eksik kaldığı yerlere odaklanır (doğru cevap)
- İkisi de sadece regresyon yapar
- Aralarında hiçbir benzerlik yoktur
Neden: Her ikisi de boosting ailesindendir: modelleri sırayla kurar ve her yeni model bir öncekinin hatasına (AdaBoost'ta ağırlıklandırma, Gradient Boosting'te kalıntıya uydurma yoluyla) odaklanır.
Özet
Özet
- Gradient Boosting, ortalama gibi basit bir tahminle başlar, her turda bir önceki modelin kalıntısına yeni bir küçük ağaç uydurup ekler.
- Öğrenme oranı, her yeni ağacın toplama ne kadar güçlü katılacağını belirler.
- Düşük öğrenme oranı daha fazla ağaç (tur) gerektirir; yüksek öğrenme oranı hızlı öğrenir ama aşırı öğrenmeye daha yatkındır.
- Eğitim hatasının çok düşük olması başarı değil, aşırı öğrenme riskinin işareti olabilir -- çapraz doğrulama şart.
- AdaBoost gibi sıralı çalışır; XGBoost ve LightGBM (23-24. ders) bu fikrin optimize edilmiş, endüstri standardı uygulamalarıdır.