

Denetimli / denetimsiz / pekiştirmeli
Önkoşul:Makine öğrenmesine giriş
Kanca
Bir açgözlü reklam ajanı kurduk: her zaman “şimdiye kadar en iyi görünen” reklamı seçiyor. 200 denemenin 199’unda A reklamını seçti — ama gerçekte B reklamı çok daha iyiydi (%25’e karşı %10 tıklanma). Neden? Çünkü ajan hiç keşif yapmadı, sadece sömürdü. Bu üç kelime — etiket, ödül, keşif — makine öğrenmesinin üç ailesini birbirinden ayırıyor.
Sezgi
Makine öğrenmesi üç ana aileye ayrılır, hangi bilgiye sahip olduğuna göre:
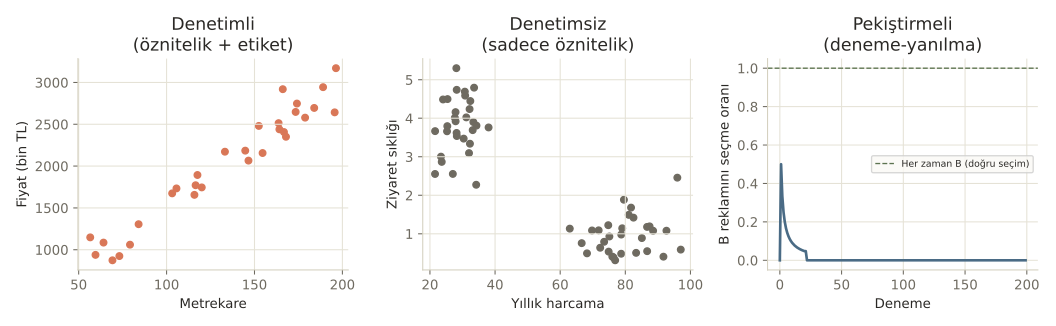
Denetimli öğrenme (supervised): elinde hem öznitelik hem DOĞRU CEVAP (etiket) var — “bu evin metrekaresi 120, fiyatı 1.8 milyon TL.” Amaç, bu ilişkiyi öğrenip yeni bir ev için fiyat tahmin etmek.
Denetimsiz öğrenme (unsupervised): elinde sadece öznitelikler var, DOĞRU CEVAP yok — “işte 60 müşterinin harcama ve ziyaret verisi” ama hangi müşterinin “hangi gruba ait” olduğu söylenmemiş. Amaç, veride kendiliğinden var olan örüntüyü (grupları) bulmak.
Pekiştirmeli öğrenme (reinforcement): doğru cevap hiç verilmez, sadece bir ödül sinyali vardır — bir ajan, deneme-yanılma yoluyla hangi eylemin daha iyi sonuç verdiğini kendisi keşfeder.
Mekanizma
Üç örneği sırayla kuralım. Önce denetimli:
Denetimli: öznitelik + etiket
# DENETİMLİ (supervised): elimizde hem öznitelik hem DOĞRU CEVAP (etiket) var.
# Örnek: ev büyüklüğü (m²) → fiyat (bin TL). Etiket (fiyat) elimizde.
metrekare = rng.uniform(50, 200, size=30)
fiyat = 15 * metrekare + rng.normal(0, 200, size=30)  # gerçek fiyatları BİLİYORUZ

print("Denetimli öğrenme örneği: ev fiyatı tahmini")
print(f"Öznitelik (metrekare) örnek: {metrekare[:3].round(1)}")
print(f"Etiket (gerçek fiyat, bin TL) örnek: {fiyat[:3].round(0)}")
print("Amaç: metrekare → fiyat ilişkisini öğrenip YENİ bir evin fiyatını tahmin etmek.")
Denetimli öğrenme örneği: ev fiyatı tahmini
Öznitelik (metrekare) örnek: [166.1 115.8 178.8]
Etiket (gerçek fiyat, bin TL) örnek: [2920. 1656. 2579.]
Amaç: metrekare → fiyat ilişkisini öğrenip YENİ bir evin fiyatını tahmin etmek.Sonra denetimsiz:
Denetimsiz: sadece öznitelik
# DENETİMSİZ (unsupervised): elimizde SADECE öznitelikler var, DOĞRU CEVAP (etiket) yok.
# Örnek: müşterilerin yıllık harcaması ve ziyaret sıklığı — hangi müşteri "hangi gruba
# ait" diye bir etiket YOK, algoritma kendisi benzer müşterileri gruplandırmalı.
n = 60
grup1 = rng.normal([30, 4], [5, 1], size=(30, 2))   # az harcayan, sık ziyaret eden
grup2 = rng.normal([80, 1], [8, 0.5], size=(30, 2))  # çok harcayan, nadir ziyaret eden
musteriler = np.vstack([grup1, grup2])
rng.shuffle(musteriler)

print(f"\nDenetimsiz öğrenme örneği: {len(musteriler)} müşteri, HİÇBİR etiket yok")
print("Amaç: hangi müşterilerin birbirine benzediğini, ETİKET olmadan bulmak (kümeleme, 27. ders).")
Denetimsiz öğrenme örneği: 60 müşteri, HİÇBİR etiket yok
Amaç: hangi müşterilerin birbirine benzediğini, ETİKET olmadan bulmak (kümeleme, 27. ders).
Şimdi pekiştirmeli öğrenmeyi deneyelim — iki reklamdan hangisi daha iyi, sadece deneyerek öğrenilecek:
Saf açgözlü ajan
# PEKİŞTİRMELİ (reinforcement): bir AJAN, DENEME-YANILMA ile öğrenir — doğru cevap
# baştan verilmez, sadece bir "ödül" sinyali vardır. Örnek: iki reklam versiyonundan
# hangisi daha çok tıklanıyor, zamanla DENEYEREK öğrenmek (basit bir "bandit" problemi).
gercek_tiklanma_orani = [0.10, 0.25]  # ajan bunları BİLMİYOR, keşfetmesi gerekiyor
tahmini_oranlar = [0.5, 0.5]  # başlangıçta ikisi de eşit "iyi" sanılıyor
denemeler = [0, 0]
odul_toplami = [0, 0]

secim_gecmisi = []
for adim in range(200):
    secilen = int(np.argmax(tahmini_oranlar))  # şimdiye kadar en iyi görüneni seç
    odul = rng.random() < gercek_tiklanma_orani[secilen]
    denemeler[secilen] += 1
    odul_toplami[secilen] += odul
    tahmini_oranlar[secilen] = odul_toplami[secilen] / denemeler[secilen]  # tahmini güncelle
    secim_gecmisi.append(secilen)

print(f"\nPekiştirmeli öğrenme örneği: 200 denemede reklam seçimi (SAF açgözlü ajan)")
print(f"A reklamı: {denemeler[0]} kez denendi, tahmini oran={tahmini_oranlar[0]:.2f} (gerçek={gercek_tiklanma_orani[0]})")
print(f"B reklamı: {denemeler[1]} kez denendi, tahmini oran={tahmini_oranlar[1]:.2f} (gerçek={gercek_tiklanma_orani[1]})")
print("Ajan, ilk denemede A'dan şanslı bir ödül aldı ve bir daha B'yi hiç denemedi —")
print("bu, SAF açgözlü (hiç keşif yapmayan) bir ajanın klasik tuzağı.")
Pekiştirmeli öğrenme örneği: 200 denemede reklam seçimi (SAF açgözlü ajan)
A reklamı: 199 kez denendi, tahmini oran=0.09 (gerçek=0.1)
B reklamı: 1 kez denendi, tahmini oran=0.00 (gerçek=0.25)
Ajan, ilk denemede A'dan şanslı bir ödül aldı ve bir daha B'yi hiç denemedi —
bu, SAF açgözlü (hiç keşif yapmayan) bir ajanın klasik tuzağı.
Beklenmedik ama gerçek bir sonuç: ajan 199 kez A’yı seçti, B’yi sadece 1 kez denedi! İlk denemede A’dan şanslı bir ödül aldı, o andan sonra “en iyi bilinen” hep A oldu ve bir daha B’yi denemedi. Çoğu kişi “ajan mantıklı davranıyor, en iyi bilineni seçiyor, sorun ne?” der. Değil, çünkü “en iyi BİLİNEN” ile “gerçekte en iyi olan” aynı şey değil — yeterince denemeden bir şeyin “iyi” olduğuna karar vermek yanıltıcı olabilir. Çözüm, biraz keşif eklemek:
Epsilon-açgözlü ajan
# ÇÖZÜM: %10 ihtimalle RASTGELE bir reklamı dene (keşif), %90 ihtimalle en iyi bilineni
# seç (sömürü, exploitation). Buna epsilon-açgözlü (epsilon-greedy) denir.
rng2 = np.random.default_rng(7)
tahmini_oranlar_eg = [0.5, 0.5]
denemeler_eg = [0, 0]
odul_toplami_eg = [0, 0]
epsilon = 0.10

for adim in range(200):
    if rng2.random() < epsilon:
        secilen = rng2.integers(0, 2)  # KEŞİF: rastgele dene
    else:
        secilen = int(np.argmax(tahmini_oranlar_eg))  # SÖMÜRÜ: en iyi bilineni seç
    odul = rng2.random() < gercek_tiklanma_orani[secilen]
    denemeler_eg[secilen] += 1
    odul_toplami_eg[secilen] += odul
    tahmini_oranlar_eg[secilen] = odul_toplami_eg[secilen] / denemeler_eg[secilen]

print(f"\nEpsilon-açgözlü ajan (yüzde 10 keşif) ile aynı 200 deneme:")
print(f"A reklamı: {denemeler_eg[0]} kez denendi, tahmini oran={tahmini_oranlar_eg[0]:.2f}")
print(f"B reklamı: {denemeler_eg[1]} kez denendi, tahmini oran={tahmini_oranlar_eg[1]:.2f} (gerçek={gercek_tiklanma_orani[1]})")
print("Az miktarda rastgele keşif bile, ajanın gerçek en iyi seçeneği (B) bulmasını sağladı.")
Epsilon-açgözlü ajan (yüzde 10 keşif) ile aynı 200 deneme:
A reklamı: 11 kez denendi, tahmini oran=0.09
B reklamı: 189 kez denendi, tahmini oran=0.25 (gerçek=0.25)
Az miktarda rastgele keşif bile, ajanın gerçek en iyi seçeneği (B) bulmasını sağladı.
Sadece %10 ihtimalle rastgele bir reklamı deneyerek, ajan artık B’yi 189 kez deniyor ve gerçek oranını (%25) doğru buluyor.
Matematik
Üç ailenin karşılaştırması
| Aile | Elde olan bilgi | Amaç | Bu kursta |
|---|---|---|---|
| Denetimli | Öznitelik + etiket | Yeni örnekler için etiketi tahmin etmek | 3-24. dersler (regresyon, sınıflandırma) |
| Denetimsiz | Sadece öznitelik | Veride gizli örüntüyü/grupları bulmak | 26-31. dersler (PCA, kümeleme) |
| Pekiştirmeli | Sadece ödül sinyali | Deneyerek en iyi eylemi bulmak | Bu derste giriş, ileri seviye konu |
Pekiştirmeli öğrenmenin kalbi keşif-sömürü dengesidir (exploration-exploitation trade-off): sömürü (şimdiye kadar en iyi bilineni seçmek) kısa vadede güvenlidir ama yanlış bir “en iyi”ye saplanabilir; keşif (rastgele denemek) yeni bilgi getirir ama kısa vadede fırsat maliyeti taşır. İyi bir ajan ikisini dengeler.
Kod
Nerede işe yarar
Bu üç ailenin her biri farklı problem türlerine karşılık gelir:
- Denetimli. E-posta spam tespiti, kredi onayı, fiyat tahmini — etiketli geçmiş veri olan her yerde.
- Denetimsiz. Müşteri segmentasyonu, anomali tespiti, boyut indirgeme — “gruplar önceden bilinmiyor” durumlarında.
- Pekiştirmeli. Reklam/fiyat optimizasyonu (A/B testinin ötesinde, sürekli öğrenen sistemler), oyun oynayan ajanlar, robotik.
Bu 3 hatayı yaparsın:
- Etiketsiz veriye denetimli bir yöntem uygulamaya çalışmak — önce etiket üretmen (veya denetimsiz bir yaklaşıma geçmen) gerekir.
- Pekiştirmeli bir sistemde hiç keşif payı bırakmamak — bu derste gördüğümüz gibi, saf açgözlülük yanlış bir seçime saplanabilir.
- Üç aileyi birbirinin yerine geçebilir sanmak — her biri farklı bir bilgi türü ve farklı bir problem yapısı gerektirir.
Kendini test et
1. Denetimli ile denetimsiz öğrenme arasındaki temel fark nedir?
- Denetimli daha hızlıdır
- Denetimlide etiket (doğru cevap) vardır, denetimsizde yoktur (doğru cevap)
- Denetimsiz sadece görüntülerde kullanılır
- Aralarında fark yoktur
Neden: Denetimli öğrenmede her örnek için doğru cevap (etiket) bilinir; denetimsiz öğrenmede sadece öznitelikler vardır, model örüntüyü kendisi bulmalıdır.
2. Saf açgözlü pekiştirmeli ajan neden B reklamını (gerçekte daha iyi olan) neredeyse hiç denemedi?
- B reklamı geçersizdi
- Ajan ilk denemede A'dan şanslı bir ödül aldı ve hiç keşif yapmadan hep "en iyi bilineni" (A'yı) seçmeye devam etti (doğru cevap)
- Kod hatası vardı
- B reklamı hiç tanımlanmamıştı
Neden: Keşif olmadan, erken bir şanslı sonuç ajanı yanlış bir seçime kilitleyebilir — bu, saf sömürünün (exploitation) temel riskidir.
3. Epsilon-açgözlü (epsilon-greedy) yaklaşım nasıl çalışır?
- Her zaman rastgele seçim yapar
- Belirli bir olasılıkla (epsilon) rastgele keşif yapar, geri kalan zamanda en iyi bilineni seçer (doğru cevap)
- Hiçbir zaman keşif yapmaz
- Sadece ilk denemede rastgele seçim yapar
Neden: Epsilon-açgözlü, küçük bir olasılıkla (örn. %10) rastgele keşif yaparak, ajanın yanlış bir 'en iyi'ye saplanma riskini azaltır — notebook'ta bu, B'nin gerçek oranının doğru bulunmasını sağladı.
Özet
Özet
- Denetimli öğrenme, öznitelik + etiket ile çalışır; amaç yeni örnekler için etiket tahmin etmek.
- Denetimsiz öğrenme, sadece öznitelikle çalışır; amaç veride gizli örüntüyü/grupları bulmak.
- Pekiştirmeli öğrenme, sadece bir ödül sinyaliyle çalışır; ajan deneme-yanılma ile en iyi eylemi keşfeder.
- Saf açgözlü (sömürü odaklı) bir ajan, erken şanslı sonuçlar yüzünden yanlış bir seçime saplanabilir.
- Az miktarda keşif (epsilon-açgözlü gibi), ajanın gerçek en iyi seçeneği bulma şansını büyük ölçüde artırır.