

Entropi, Gini, bilgi kazancı
Önkoşul:Karar ağaçları
Kanca
- derste Gini kirliliğini kullandık. Ama scikit-learn’de
criterion="entropy"diye bir seçenek daha var. İkisi de “ne kadar karışık” sorusuna cevap veriyor — ama aynı cevabı mı veriyorlar?
Sezgi
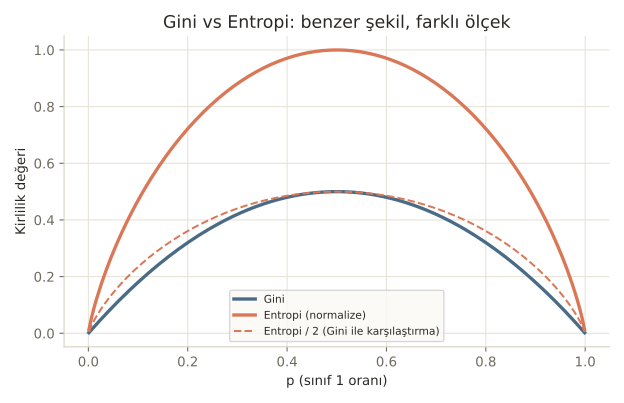
Entropi, bilgi teorisinden gelen bir “belirsizlik” ölçüsüdür — Gini gibi 0 (tamamen saf) ile bir maksimum değer (tamamen karışık) arasında değişir, ama farklı bir matematiksel formülle hesaplanır. İkisi de aynı SORUYA (“bu grup ne kadar karışık?”) cevap arıyor, ama farklı bir “cetvel” kullanıyorlar.
Çoğu kaynak “Gini ve entropi pratikte neredeyse hep aynı ağacı üretir” der. Bu derste bunu GERÇEK bir veri setinde test edeceğiz — ve sonuç şaşırtıcı olacak.
Mekanizma
Önce iki formülü yan yana karşılaştıralım:
Gini vs Entropi
def gini(p):
    return 1 - p**2 - (1 - p) ** 2

def entropi(p):
    if p == 0 or p == 1:
        return 0.0
    return -p * np.log2(p) - (1 - p) * np.log2(1 - p)

print(f"{'p (sınıf 1 oranı)':<20} {'Gini':>8} {'Entropi':>8}")
for p in [0.0, 0.1, 0.3, 0.5, 0.7, 0.9, 1.0]:
    print(f"{p:<20} {gini(p):>8.3f} {entropi(p):>8.3f}")
print("\nİkisi de p=0.5'te (tamamen karışık) en yüksek, p=0/1'de (tamamen saf) sıfır -- ama entropi biraz daha 'dik' bir eğri çiziyor.")
p (sınıf 1 oranı) Gini Entropi
0.0 0.000 0.000
0.1 0.180 0.469
0.3 0.420 0.881
0.5 0.500 1.000
0.7 0.420 0.881
0.9 0.180 0.469
1.0 0.000 0.000
İkisi de p=0.5'te (tamamen karışık) en yüksek, p=0/1'de (tamamen saf) sıfır -- ama entropi biraz daha 'dik' bir eğri çiziyor.İkisi de aynı yerde (p=0.5) en yüksek, aynı yerlerde (p=0 veya 1) sıfır — ama entropi biraz daha “dik” bir eğri çiziyor (p=0.1’de Gini=0.180 iken entropi=0.469, orantılı olarak entropi daha büyük). Şimdi 17. dersteki AYNI müşteri verisine, iki farklı kriterle ağaç kuralım:
Aynı veri, iki farklı kriter
# 17. dersteki müşteri verisini tekrar kullanalım.
n = 120
yas = rng.uniform(18, 65, n)
gelir = rng.uniform(3, 25, n)
skor = (yas - 40) / 15 + (gelir - 12) / 8 + rng.normal(0, 0.4, n)
satin_aldi = (skor > 0).astype(int)
X = np.column_stack([yas, gelir])

model_gini = DecisionTreeClassifier(max_depth=2, criterion="gini", random_state=19)
model_entropi = DecisionTreeClassifier(max_depth=2, criterion="entropy", random_state=19)
model_gini.fit(X, satin_aldi)
model_entropi.fit(X, satin_aldi)

print("Gini kriteriyle kurulan ağaç:")
print(export_text(model_gini, feature_names=["yas", "gelir"]))
print(f"Doğruluk: {accuracy_score(satin_aldi, model_gini.predict(X)):.3f}\n")

print("Entropi kriteriyle kurulan ağaç:")
print(export_text(model_entropi, feature_names=["yas", "gelir"]))
print(f"Doğruluk: {accuracy_score(satin_aldi, model_entropi.predict(X)):.3f}")
Gini kriteriyle kurulan ağaç:
|--- gelir <= 9.67
| |--- yas <= 47.75
| | |--- class: 0
| |--- yas > 47.75
| | |--- class: 1
|--- gelir > 9.67
| |--- yas <= 24.38
| | |--- class: 0
| |--- yas > 24.38
| | |--- class: 1
Doğruluk: 0.942
Entropi kriteriyle kurulan ağaç:
|--- yas <= 43.78
| |--- gelir <= 9.61
| | |--- class: 0
| |--- gelir > 9.61
| | |--- class: 1
|--- yas > 43.78
| |--- gelir <= 9.72
| | |--- class: 1
| |--- gelir > 9.72
| | |--- class: 1
Doğruluk: 0.867Gini ağacı önce gelire, entropi ağacı önce yaşa bakarak bölünüyor — FARKLI ağaçlar! Ve sonuçlar da farklı: Gini ağacı %94.2, entropi ağacı %86.7 doğruluk. Çoğu kişi “iki kirlilik ölçüsü neredeyse her zaman aynı sonucu verir” sanır. Bazen doğru ama garanti değil, çünkü iki formülün eğrileri farklı “eğimlere” sahip olduğu için, bazı bölünme adaylarını farklı sıralayabilirler — özellikle birden fazla bölünmenin bilgi kazancı birbirine yakınsa, hangi kriterin seçildiği sonucu değiştirebilir.
Matematik
Entropi formülü ve bilgi kazancı
| Sembol | Anlamı |
|---|---|
| kümesindeki ‘ıncı sınıfın oranı | |
| 2 tabanında logaritma — “bit” cinsinden belirsizliği ölçer | |
| 0 (tamamen saf) ile (tamamen karışık) arasında |
Entropi, bilgi teorisinde “bu kümedeki bir örneğin sınıfını doğru tahmin etmek için ortalama kaç bit’lik bilgiye ihtiyacın var” sorusuna karşılık gelir. Gini ise hesaplama açısından biraz daha basittir (logaritma gerektirmez) — bu yüzden scikit-learn’de varsayılan (criterion="gini") olarak seçilmiştir.
Kod
Her ikisi de, 2’den fazla sınıfa doğal olarak genelleşir:
Çok sınıflı kirlilik
# Entropi (ve Gini), 2'den fazla sınıfa da doğal olarak genelleşir.
def entropi_cok_sinif(etiketler):
    _, sayilar = np.unique(etiketler, return_counts=True)
    p = sayilar / len(etiketler)
    return -np.sum(p * np.log2(p))

def gini_cok_sinif(etiketler):
    _, sayilar = np.unique(etiketler, return_counts=True)
    p = sayilar / len(etiketler)
    return 1 - np.sum(p**2)

# 3 sınıflı örnek: 3 farklı ürün kategorisi tercih eden müşteriler
uc_sinifli = rng.integers(0, 3, 90)
print(f"\n3 sınıflı, dengeli veri (her sınıftan ~30): Gini={gini_cok_sinif(uc_sinifli):.3f}, Entropi={entropi_cok_sinif(uc_sinifli):.3f}")

dengesiz_uc_sinifli = np.concatenate([np.zeros(80), np.ones(8), np.full(2, 2)])
print(f"3 sınıflı, dengesiz veri (80/8/2): Gini={gini_cok_sinif(dengesiz_uc_sinifli):.3f}, Entropi={entropi_cok_sinif(dengesiz_uc_sinifli):.3f}")
print("Dengesiz dağılımda ikisi de çok daha düşük -- veri zaten 'saf'a yakın.")
3 sınıflı, dengeli veri (her sınıftan ~30): Gini=0.663, Entropi=1.578
3 sınıflı, dengesiz veri (80/8/2): Gini=0.201, Entropi=0.583
Dengesiz dağılımda ikisi de çok daha düşük -- veri zaten 'saf'a yakın.
Dengesiz (80/8/2) dağılımda her iki ölçü de çok daha düşük çıkıyor — veri zaten büyük ölçüde tek bir sınıfa (80/90) yakın, yani “saf”a yakın.
Nerede işe yarar
Gini ile entropi arasındaki seçim, çoğu pratik durumda küçük bir detaydır ama bilmekte fayda var:
- Varsayılan olarak Gini kullan. scikit-learn’ün varsayılanı budur ve hesaplaması biraz daha hızlıdır (logaritma yok).
- İki kriter farklı sonuç verirse, çapraz doğrulamayla (9. ders) hangisinin daha iyi genellediğine bak. Bu derste gördüğümüz gibi, fark gerçek olabilir.
- Bilgi teorisi bağlamında çalışıyorsan entropiyi tercih et. “Bit” cinsinden yorumlanabilir olması, bazı bağlamlarda (örn. karar ağaçlarının ötesinde, sıkıştırma veya iletişim teorisiyle bağlantı kurarken) daha doğal olabilir.
Bu 3 hatayı yaparsın:
- “Gini ve entropi hep aynı sonucu verir” diye varsayıp hiç test etmemek — bu derste gördüğümüz gibi bazen gerçekten FARKLI ağaçlar ve FARKLI doğruluklar üretebilirler.
- Entropi değerini Gini ile doğrudan büyüklük olarak karşılaştırmak — ikisi farklı ölçeklerde (entropi 0-1’in üstüne çıkabilir, Gini 2 sınıf için 0-0.5 arası kalır), sadece GÖRELİ sıralama karşılaştırılabilir.
- Kirlilik kriterini “önemsiz bir ayrıntı” sayıp hiç denemeden geçmek — küçük bir hiperparametre gibi görünse de, bu derste gördüğümüz gibi sonucu belirgin şekilde değiştirebilir.
Kendini test et
1. Gini kirliliği ile entropi arasındaki temel benzerlik nedir?
- İkisi de aynı matematiksel formülü kullanır
- İkisi de bir grubun "ne kadar karışık" (kirli) olduğunu ölçer -- 0 tamamen saf, maksimum değer tamamen karışık (doğru cevap)
- İkisi de sadece 2 sınıflı problemlerde çalışır
- İkisi de aynı ölçekte (0-1 arası) sonuç verir
Neden: Gini ve entropi farklı formüllerle hesaplansa da, ikisi de aynı temel soruyu (bir grubun sınıf karışıklığı) cevaplamaya çalışır.
2. Notebook'ta aynı veri setinde Gini ve entropi kriterleri neden FARKLI ağaçlar üretti?
- Kod hatalıydı
- İki formülün eğrileri farklı 'eğimlere' sahip olduğu için, bazı bölünme adaylarını farklı şekilde sıralayabilirler (doğru cevap)
- scikit-learn rastgele seçim yapıyor
- Entropi her zaman yanlış sonuç verir
Neden: Gini ve entropinin matematiksel şekli farklı olduğu için, bilgi kazançları birbirine yakın olan iki aday bölünmeyi farklı sıralayabilirler -- bu da farklı bir ağaç yapısına yol açar.
3. Bu derste hangi kriterin (Gini mi entropi mi) 'kesin olarak daha iyi' olduğu gösterildi mi?
- Evet, Gini her zaman daha iyidir
- Evet, entropi her zaman daha iyidir
- Hayır -- bu örnekte Gini daha iyi sonuç verdi (%94.2 vs %86.7) ama bu genel bir kural değil, veri setine göre değişebilir (doğru cevap)
- İkisi de hiçbir zaman işe yaramaz
Neden: Bu örnekte Gini daha yüksek doğruluk verdi, ama bu evrensel bir kural değildir -- hangi kriterin daha iyi olduğu veri setine bağlıdır ve çapraz doğrulamayla test edilmelidir.
Özet
Özet
- Gini ve entropi, bir grubun sınıf karışıklığını ölçen iki farklı formüldür -- ikisi de 0 (saf) ile maksimum (karışık) arasında değişir.
- Entropi, bilgi teorisinden gelir ve "bit" cinsinden belirsizliği ölçer; Gini hesaplama açısından biraz daha basittir.
- İki ölçü genelde benzer ağaçlar üretir ama GARANTİ DEĞİLDİR -- bazen belirgin şekilde farklı sonuçlar verebilirler.
- Her iki ölçü de, ikiden fazla sınıfa (çok sınıflı problemlere) doğal olarak genelleşir.
- Hangi kriterin daha iyi olduğu veri setine bağlıdır; emin olmak için çapraz doğrulamayla karşılaştırmak gerekir.