

Kümeleme başarı metrikleri
Önkoşul:K-Means
Kanca
- derste dirsek yöntemiyle k seçtik — ama “dirsek” öznel bir gözlem, kesin bir sayı değil. Kümelemede hiç etiket olmadığı için (11. derste sınıflandırmada yaptığımız gibi) doğruluk da hesaplayamıyoruz. Peki bir kümelemenin “iyi” olduğunu NASIL ölçeriz?
Sezgi
Silhouette skoru, her nokta için iki mesafeyi karşılaştırır: a(i) — noktanın KENDİ kümesindeki diğer noktalara ortalama mesafesi (küçük olmalı), ve b(i) — noktanın EN YAKIN DİĞER kümedeki noktalara ortalama mesafesi (büyük olmalı). Skor, bu ikisinin farkını normalize eder: +1’e yakın = mükemmel yerleşmiş, 0 = sınırda, negatif = yanlış kümeye atanmış olabilir.
- dersteki inertia’dan temel farkı şu: inertia, k arttıkça HEP azalır (k=n olduğunda her nokta kendi kümesi olur, inertia sıfırlanır) — bu yüzden “en düşük inertia’yı ver” diyemeyiz. Silhouette skoru ise gerçek bir “en iyi nokta” gösterebilir.
Mekanizma
Gerçek kümelerin bilindiği bir veri setiyle (normalde bilinmez, burada sadece doğrulama için) ilerleyelim:
3 gerçek küme
# 3 gerçek küme -- ve gerçek etiketleri BİLİYORUZ (normalde kümelemede bilinmez, ama metrikleri
# doğrulamak için burada kullanacağız).
merkezler = [(-2, -2), (2, -2), (0, 2.5)]
X_parcalar, gercek_etiketler = [], []
for k, m in enumerate(merkezler):
    X_parcalar.append(rng.normal(m, 0.6, size=(20, 2)))
    gercek_etiketler.append(np.full(20, k))
X = np.vstack(X_parcalar)
gercek_etiketler = np.concatenate(gercek_etiketler)
print(f"{len(X)} nokta, 3 gerçek küme (etiketler sadece DOĞRULAMA için kullanılacak)")
60 nokta, 3 gerçek küme (etiketler sadece DOĞRULAMA için kullanılacak)Silhouette skoru, gerçek bir zirve gösteriyor
# 27. derste inertia'nın k arttıkça HEP azaldığını (asla artmadığını) gördük -- bu yüzden
# "en düşük inertia'yı veren k'yı seç" diyemeyiz. Silhouette skoru farklı çalışır.
for k in range(2, 8):
    model = KMeans(n_clusters=k, n_init=10, random_state=1)
    etiketler = model.fit_predict(X)
    skor = silhouette_score(X, etiketler)
    print(f"k={k}  silhouette skoru={skor:.3f}  (inertia={model.inertia_:.1f})")
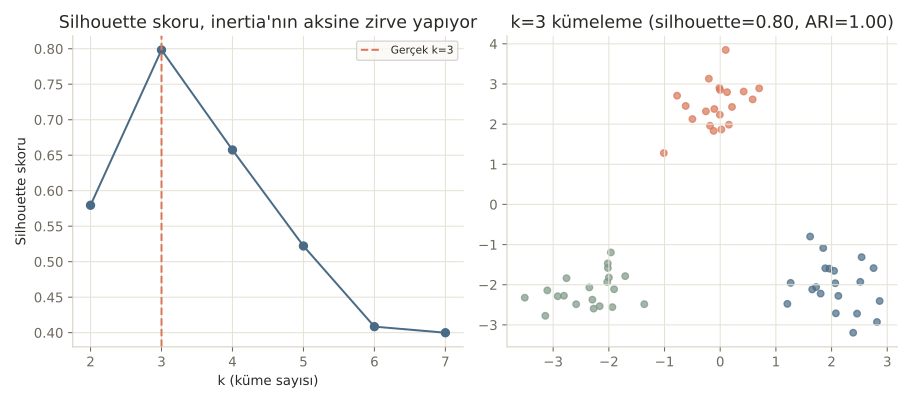
print("\nSilhouette skoru k=3'te ZİRVE yapıyor, sonra düşüyor -- inertia'nın aksine gerçek bir 'en iyi nokta' gösteriyor.")
k=2 silhouette skoru=0.579 (inertia=225.8)
k=3 silhouette skoru=0.798 (inertia=30.1)
k=4 silhouette skoru=0.657 (inertia=24.9)
k=5 silhouette skoru=0.522 (inertia=20.3)
k=6 silhouette skoru=0.408 (inertia=15.6)
k=7 silhouette skoru=0.400 (inertia=13.0)
Silhouette skoru k=3'te ZİRVE yapıyor, sonra düşüyor -- inertia'nın aksine gerçek bir 'en iyi nokta' gösteriyor.Silhouette skoru k=3’te tam zirve (0.798) yapıyor, sonra düşüyor — inertia’nın hiçbir zaman yapamadığı bir şey. Çoğu kişi “kümeleme kalitesini ölçmenin tek yolu inertia’ya bakmaktır” sanır. Değil, çünkü inertia sadece “kümeler ne kadar sıkı” sorusuna cevap verir, “kaç küme olmalı” sorusuna değil — silhouette, kümelerin hem kendi içinde sıkı HEM DE birbirinden ayrı olmasını birlikte değerlendirir.
Matematik
Silhouette skoru formülü
| Sembol | Anlamı |
|---|---|
| Noktanın kendi kümesindeki DİĞER noktalara ortalama mesafesi — düşük olması iyi | |
| Noktanın en yakın KOMŞU kümedeki noktalara ortalama mesafesi — yüksek olması iyi | |
| -1 ile +1 arası — +1’e yakın: mükemmel yerleşmiş, 0: sınırda, negatif: yanlış kümede olabilir |
Genel silhouette skoru, tüm noktaların ‘lerinin ORTALAMASIdır. Bu, hem “kümeler kompakt mı” (a(i) küçük) hem “kümeler birbirinden ayrık mı” (b(i) büyük) sorularını TEK bir sayıda birleştirir.
Kod
Tek bir nokta için silhouette’i elle hesaplayıp doğrulayalım:
Elle silhouette hesaplama
# Silhouette'in mantığını tek bir nokta için elle görelim.
model_3 = KMeans(n_clusters=3, n_init=10, random_state=1)
etiketler_3 = model_3.fit_predict(X)
tum_silhouette = silhouette_samples(X, etiketler_3)

ornek_indeks = 5
ornek_nokta = X[ornek_indeks]
kendi_kume = etiketler_3[ornek_indeks]
kendi_kume_diger_noktalar = X[(etiketler_3 == kendi_kume) & (np.arange(len(X)) != ornek_indeks)]
a_i = np.mean(np.linalg.norm(kendi_kume_diger_noktalar - ornek_nokta, axis=1))

en_yakin_b = np.inf
for k in set(etiketler_3) - {kendi_kume}:
    diger_kume_noktalari = X[etiketler_3 == k]
    ortalama_mesafe = np.mean(np.linalg.norm(diger_kume_noktalari - ornek_nokta, axis=1))
    en_yakin_b = min(en_yakin_b, ortalama_mesafe)

s_i_elle = (en_yakin_b - a_i) / max(a_i, en_yakin_b)
print(f"\nNokta {ornek_indeks}: a(i) (kendi kümesine ort. mesafe)={a_i:.3f}, b(i) (en yakın diğer kümeye ort. mesafe)={en_yakin_b:.3f}")
print(f"Elle hesaplanan silhouette: {s_i_elle:.3f}")
print(f"scikit-learn'ün hesapladığı: {tum_silhouette[ornek_indeks]:.3f}")
Nokta 5: a(i) (kendi kümesine ort. mesafe)=0.907, b(i) (en yakın diğer kümeye ort. mesafe)=3.840
Elle hesaplanan silhouette: 0.764
scikit-learn'ün hesapladığı: 0.764
Elle hesapladığımız (0.764) ile scikit-learn’ün hesapladığı (0.764) BİREBİR aynı. Son olarak, gerçek etiketleri bildiğimiz için (normalde bilinmez) bir DOĞRULAMA daha yapabiliriz — Ayarlanmış Rand İndeksi (ARI):
ARI ile gerçek etiketlerle karşılaştırma
# Gerçek etiketleri bildiğimiz için, Ayarlanmış Rand İndeksi (ARI) ile "gerçekle ne kadar örtüşüyor" ölçelim.
ari_iyi = adjusted_rand_score(gercek_etiketler, etiketler_3)
print(f"\nk=3 kümelemenin ARI'si (gerçek etiketlerle karşılaştırma): {ari_iyi:.3f}  (1.0 = mükemmel örtüşme)")

model_yanlis_k = KMeans(n_clusters=5, n_init=10, random_state=1)
etiketler_yanlis = model_yanlis_k.fit_predict(X)
ari_kotu = adjusted_rand_score(gercek_etiketler, etiketler_yanlis)
silhouette_kotu = silhouette_score(X, etiketler_yanlis)
print(f"k=5 (yanlış) kümelemenin ARI'si: {ari_kotu:.3f}, silhouette: {silhouette_kotu:.3f}")
print("Yanlış k, hem ARI'yi hem silhouette'i düşürüyor -- iki metrik de birbirini destekliyor.")
k=3 kümelemenin ARI'si (gerçek etiketlerle karşılaştırma): 1.000  (1.0 = mükemmel örtüşme)
k=5 (yanlış) kümelemenin ARI'si: 0.741, silhouette: 0.522
Yanlış k, hem ARI'yi hem silhouette'i düşürüyor -- iki metrik de birbirini destekliyor.
k=3 kümeleme, gerçek etiketlerle tam olarak (ARI=1.000) örtüşüyor! Yanlış k=5 kullanıldığında hem ARI (0.741) hem silhouette (0.522) düşüyor — iki farklı metrik birbirini destekliyor.
Nerede işe yarar
Kümeleme metrikleri, “gözetimsiz” öğrenmede bile objektif bir değerlendirme sağlar:
- Silhouette skoru, gerçek etiket OLMADAN kullanılabilir. Gerçek dünyada kümeleme yaparken etiket genelde yoktur — bu yüzden en pratik metrik budur.
- ARI, sadece test/doğrulama amaçlı gerçek etiket VARSA kullanılabilir. Örneğin bir kümeleme algoritmasını, bilinen etiketli bir veri setinde test ederken.
- k seçimi için silhouette, dirsek yönteminden (27. ders) daha objektif bir sinyal verir. İkisini birlikte kullanmak, tek başına birine güvenmekten daha güvenlidir.
Bu 3 hatayı yaparsın:
- Sadece inertia’ya bakıp k seçmek — bu derste gördüğümüz gibi inertia hiçbir zaman gerçek bir “en iyi k” göstermez, hep azalır.
- Silhouette skorunun negatif çıkabileceğini unutmak — negatif bir s(i), o noktanın muhtemelen YANLIŞ kümeye atandığını gösterir.
- ARI’yi gerçek dünya kümelemesinde kullanmaya çalışmak — ARI, gerçek etiket GEREKTİRİR; çoğu kümeleme probleminde bu etiketler yoktur (varsa zaten sınıflandırma problemidir).
Kendini test et
1. Inertia'nın (27. ders) k seçimi için neden yetersiz kaldığını bu ders nasıl gösterdi?
- Inertia hiçbir zaman hesaplanamaz
- Inertia, k arttıkça HEP azalır (k=n'de sıfıra iner) -- bu yüzden 'en düşük inertia'yı seç' diyerek doğru k'yı asla bulamayız (doğru cevap)
- Inertia sadece 2 kümede çalışır
- Inertia her zaman silhouette ile aynı sonucu verir
Neden: Inertia, küme sayısı arttıkça monoton şekilde azalır (her nokta kendi kümesi olduğunda sıfıra iner), bu yüzden minimum inertia her zaman en yüksek k'da olur -- gerçek bir "en iyi k" sinyali vermez.
2. Notebook'ta silhouette skoru k=3'te neden zirve yaptı?
- Tesadüf
- k=3'te kümeler hem kendi içinde sıkı (düşük a(i)) hem birbirinden belirgin şekilde ayrık (yüksek b(i)) olduğu için (doğru cevap)
- k=3 her zaman en iyi sonucu verir
- Silhouette skoru rastgele hesaplanır
Neden: Silhouette, hem küme içi sıkılığı (a(i)) hem kümeler arası ayrımı (b(i)) birlikte değerlendirir; veri setinin gerçek yapısı 3 küme olduğu için bu denge k=3'te en iyi sağlanıyor.
3. Ayarlanmış Rand İndeksi (ARI) ne zaman kullanılabilir?
- Her zaman, etiket gerekmez
- Sadece GERÇEK etiketlerin bilindiği (genelde test/doğrulama amaçlı) durumlarda -- gerçek kümeleme problemlerinde etiket yoktur (doğru cevap)
- Sadece regresyon problemlerinde
- Sadece k=2 olduğunda
Neden: ARI, bulunan kümeleri GERÇEK etiketlerle karşılaştırır; bu yüzden sadece gerçek etiketlerin bilindiği durumlarda (algoritma test etme, akademik karşılaştırma) kullanılabilir -- pratik kümeleme problemlerinde etiket zaten yoktur.
Özet
Özet
- Silhouette skoru, her noktanın kendi kümesine (a(i)) ve en yakın diğer kümeye (b(i)) olan mesafesini karşılaştırır.
- İnertia'nın aksine, silhouette skoru gerçek bir "en iyi k" zirvesi gösterebilir.
- ARI, bulunan kümeleri gerçek etiketlerle karşılaştırır ama sadece etiket bilindiğinde kullanılabilir.
- Silhouette ve ARI'nin birbirini desteklemesi, bir kümelemenin gerçekten iyi olduğuna dair güçlü bir kanıttır.
- Kümeleme kalitesini değerlendirmek için birden fazla metriği birlikte kullanmak, tek bir metriğe güvenmekten daha güvenilirdir.