

PCA
Önkoşul:Box-Cox dönüşümü
Kanca
Bu kategoride hep ETİKETLİ veriyle (bir hedef değişkenle) çalıştık. Ya elimizde sadece öznitelikler olsa, hiç hedef olmasa? PCA, “gözetimsiz öğrenme” (unsupervised learning) dünyasına ilk adımımız — ve ilk sorduğu soru şu: bu verinin GERÇEKTEN kaç boyuta ihtiyacı var?
Sezgi
PCA (Temel Bileşen Analizi), veriyi, VARYANSIN en çok olduğu yönlerde yeniden ifade eder. İlk “ana bileşen” (PC1), verinin en çok yayıldığı yöndür; ikinci ana bileşen (PC2), PC1’e DİK olan ve kalan varyansın en çoğunu açıklayan yöndür — ve böyle devam eder.
Bu eksene projekte edildiğinde korunan varyans: %59.9 (varyans=7.92 / toplam=13.21)
Projeksiyon ekseninin açısını değiştir: bazı açılarda noktalar eksene projekte edildiğinde birbirinden çok UZAK kalıyor (yüksek korunan varyans), bazı açılarda birbirine çok YAKIN sıkışıyor (düşük korunan varyans). “PCA’yı bul” düğmesine bas — bu, varyansı MAKSİMUM yapan açıyı otomatik buluyor.
Mekanizma
Önce ilişkili (korelasyonlu) 2 öznitelikle başlayalım:
İlişkili 2 öznitelik
# Birbiriyle İLİŞKİLİ (korelasyonlu) 2 öznitelik -- bulut çapraz yönde "uzamış".
n = 60
x1 = rng.normal(0, 2.5, n)
x2 = 0.7 * x1 + rng.normal(0, 1.0, n)
X_2b = np.column_stack([x1, x2])
print(f"x1 ile x2 arasındaki korelasyon: {np.corrcoef(x1, x2)[0, 1]:.3f}")
x1 ile x2 arasındaki korelasyon: 0.8622B'de PCA
pca_2b = PCA(n_components=2)
pca_2b.fit(X_2b)
print(f"\nAna bileşen 1 yönü: {pca_2b.components_[0].round(3)}")
print(f"Açıklanan varyans oranı: PC1={pca_2b.explained_variance_ratio_[0]:.3f}, PC2={pca_2b.explained_variance_ratio_[1]:.3f}")
print("PC1 TEK BAŞINA verinin çoğunu açıklıyor -- çünkü bulut o yönde 'uzamış'.")
Ana bileşen 1 yönü: [0.785 0.619]
Açıklanan varyans oranı: PC1=0.934, PC2=0.066
PC1 TEK BAŞINA verinin çoğunu açıklıyor -- çünkü bulut o yönde 'uzamış'.
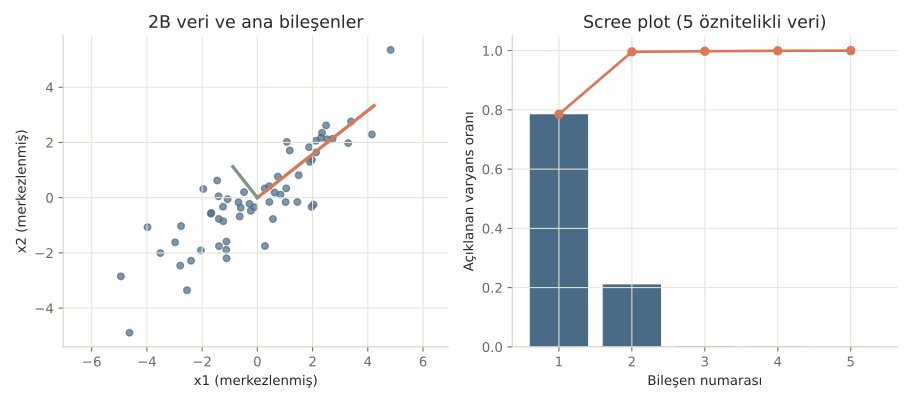
PC1 tek başına varyansın %93.4’ünü açıklıyor, PC2 sadece %6.6’sını — çünkü veri bulutu bir yönde belirgin şekilde “uzamış”. Şimdi daha gerçekçi bir senaryo: 5 öznitelikli ama aslında sadece 2 BAĞIMSIZ kaynaktan türeyen bir veri:
5 öznitelik, 2 gizli kaynak
# 5 öznitelik ama aslında sadece 2 BAĞIMSIZ sinyal var -- diğer 3, ilk 2'nin gürültülü kombinasyonları.
gizli_1 = rng.normal(0, 2, n)
gizli_2 = rng.normal(0, 1.5, n)
X_5b = np.column_stack([
    gizli_1,
    gizli_2,
    0.8 * gizli_1 + 0.2 * gizli_2 + rng.normal(0, 0.2, n),
    0.5 * gizli_1 - 0.5 * gizli_2 + rng.normal(0, 0.2, n),
    gizli_1 + gizli_2 + rng.normal(0, 0.2, n),
])
print(f"\n5 öznitelikli veri şekli: {X_5b.shape} (ama gerçekte sadece 2 BAĞIMSIZ kaynak)")
5 öznitelikli veri şekli: (60, 5) (ama gerçekte sadece 2 BAĞIMSIZ kaynak)Boyut indirgeme
pca_5b = PCA(n_components=5)
pca_5b.fit(X_5b)
print("\nHer bileşenin açıkladığı varyans oranı:")
for i, oran in enumerate(pca_5b.explained_variance_ratio_):
    print(f"  PC{i + 1}: {oran:.4f}")
kumulatif = np.cumsum(pca_5b.explained_variance_ratio_)
print(f"\nİlk 2 bileşenin AÇIKLADIĞI toplam varyans: %{kumulatif[1] * 100:.2f}")
print("5 özniteliği sadece 2 bileşene indirgeyerek, verinin neredeyse TAMAMINI koruyabiliyoruz.")
Her bileşenin açıkladığı varyans oranı:
  PC1: 0.7851
  PC2: 0.2109
  PC3: 0.0021
  PC4: 0.0014
  PC5: 0.0006

İlk 2 bileşenin AÇIKLADIĞI toplam varyans: %99.60
5 özniteliği sadece 2 bileşene indirgeyerek, verinin neredeyse TAMAMINI koruyabiliyoruz.
İlk 2 bileşen, varyansın %99.6’sını açıklıyor! Çoğu kişi “5 öznitelik varsa, verinin gerçekten 5 boyutlu bilgi taşıdığını” sanır. Değil, çünkü öznitelikler birbirleriyle ilişkiliyse (bu veri setinde 3’ü, ilk 2’nin doğrusal kombinasyonları), gerçek “bilgi boyutu” görünen öznitelik sayısından çok daha AZ olabilir — PCA bu gizli düşük boyutu ortaya çıkarıyor.
Matematik
PCA'nın optimizasyon hedefi
| Sembol | Anlamı |
|---|---|
| Birinci ana bileşenin yön vektörü — varyansı MAKSİMUM yapan birim vektör | |
| ‘ıncı ana bileşenin açıkladığı varyans (kovaryans matrisinin özdeğeri) | |
| Verinin yönüne PROJEKSİYONU — interaktif bileşendeki kaydırıcının yaptığı tam olarak bu |
PCA, kovaryans matrisinin ÖZVEKTÖRLERİNİ (eigenvectors) bulur — bunlar birbirine dik, varyansı azalan sırada açıklayan yönlerdir. 13. derste SVM’in marjin maksimize ettiği gibi, PCA da varyansı maksimize eden yönü arar — farklı bir optimizasyon hedefi, benzer bir “en iyi yönü bul” mantığı.
Kod
Bileşen sayısını azalttıkça ne kadar bilgi kaybettiğimizi doğrudan ölçelim:
Yeniden inşa hatası
for n_bilesen in [1, 2, 3, 5]:
    pca = PCA(n_components=n_bilesen)
    donusturulmus = pca.fit_transform(X_5b)
    yeniden_insa = pca.inverse_transform(donusturulmus)
    hata = np.mean((X_5b - yeniden_insa) ** 2)
    print(f"n_components={n_bilesen}  yeniden inşa hatası (MSE): {hata:.5f}")
print("Bileşen sayısı arttıkça hata azalıyor; 5 (tüm boyut) kullanınca hata TAM SIFIR -- bilgi kaybı yok.")
n_components=1 yeniden inşa hatası (MSE): 0.72479
n_components=2 yeniden inşa hatası (MSE): 0.01365
n_components=3 yeniden inşa hatası (MSE): 0.00661
n_components=5 yeniden inşa hatası (MSE): 0.00000
Bileşen sayısı arttıkça hata azalıyor; 5 (tüm boyut) kullanınca hata TAM SIFIR -- bilgi kaybı yok.1 bileşenle hata 0.725; 2 bileşene çıkınca hata 53 kat küçülüp 0.014’e iniyor; 5 (tüm boyut) kullanınca hata tam sıfır — hiç bilgi kaybı yok, çünkü hiçbir şey atılmadı.
Nerede işe yarar
PCA, makine öğrenmesi hattının hazırlık aşamasında yaygın bir araçtır:
- Görselleştirme. Yüksek boyutlu veriyi 2-3 boyuta indirip gözle incelemek için.
- Gürültü azaltma ve hesaplama verimliliği. Az bilgi taşıyan boyutları atarak, sonraki modellerin (KNN gibi mesafeye dayalı yöntemler özellikle) daha hızlı ve daha az gürültülü çalışmasını sağlamak.
- Multicollinearity (öznitelikler arası yüksek korelasyon) sorununu hafifletmek. Doğrusal regresyon gibi yöntemlerde ilişkili öznitelikler sorun yaratabilir; PCA bunları birbirinden BAĞIMSIZ (dik) bileşenlere dönüştürür.
Bu 3 hatayı yaparsın:
- PCA’dan önce öznitelikleri ölçeklemeyi unutmak — varyans mutlak ölçeğe bağlı olduğu için, ölçeksiz bir öznitelik varyansı tek başına domine edebilir (16. derste KNN için gördüğümüz sorunun aynısı).
- Ana bileşenleri orijinal özniteliklermiş gibi YORUMLAMAYA çalışmak — PC1, “metrekare” gibi anlamlı bir şey değil, birden fazla özniteliğin ağırlıklı bir KARIŞIMIdır.
- Kaç bileşen tutulacağına rastgele karar vermek — scree plot’taki (kümülatif varyans grafiği) “dirsek noktası” veya istenen bir varyans eşiği (örn. %95) daha prensipli bir seçim sağlar.
Kendini test et
1. Birinci ana bileşen (PC1) neyi temsil eder?
- Veri setindeki ilk öznitelik
- Verinin en çok yayıldığı (varyansın en yüksek olduğu) yön (doğru cevap)
- Rastgele seçilen bir yön
- Hedef değişkenle en çok ilişkili öznitelik
Neden: PC1, verideki varyansı MAKSİMUM yapan birim vektör yönüdür -- veri bulutunun en çok "uzadığı" yön.
2. Notebook'ta 5 öznitelikli veride ilk 2 bileşenin varyansın %99.6'sını açıklaması neyi gösteriyor?
- Kod hatalıydı
- Öznitelikler birbiriyle GÜÇLÜ ilişkili olduğu için, verinin gerçek 'bilgi boyutu' görünen 5 özniteliğten çok daha az (~2) (doğru cevap)
- Veri seti çok küçüktü
- 5 öznitelik de birbirinden tamamen bağımsızdı
Neden: 3 öznitelik, ilk 2'nin doğrusal kombinasyonlarından türetildiği için, veri gerçekte sadece 2 bağımsız boyut taşıyor -- PCA bu gizli düşük boyutu ortaya çıkarıyor.
3. Yeniden inşa hatası (reconstruction error), bileşen sayısı arttıkça neden azalır?
- Model daha hızlı çalıştığı için
- Daha fazla bileşen tutmak, orijinal veriden daha az bilgi ATMAK anlamına gelir -- tüm bileşenler tutulduğunda hata sıfırdır (doğru cevap)
- Veri seti küçüldüğü için
- Rastgele bir ilişki
Neden: Her ek bileşen, orijinal veriden daha fazla varyansı (bilgiyi) korur; tüm bileşenler tutulduğunda hiçbir bilgi atılmamış olur, bu yüzden yeniden inşa hatası tam sıfır olur.
Özet
Özet
- PCA, veriyi varyansın en çok olduğu (birbirine dik) yönlerde yeniden ifade eder.
- Ana bileşenler, açıkladıkları varyans miktarına göre sıralanır -- PC1 en çok, PCn en az varyansı açıklar.
- İlişkili öznitelikler, verinin gerçek "bilgi boyutunu" görünen öznitelik sayısından çok daha az yapabilir.
- Yeniden inşa hatası, tutulan bileşen sayısı arttıkça azalır ve tüm bileşenler tutulduğunda sıfır olur.
- PCA öncesi öznitelik ölçekleme neredeyse her zaman gereklidir -- varyans mutlak ölçeğe bağlıdır.