

Lojistik regresyon
Önkoşul:Çapraz doğrulama türleri
Kanca
Şimdiye kadar hep bir SAYI tahmin ettik (fiyat, MSE…). Ama “bu öğrenci sınavı geçecek mi?” gibi bir soru, sayı değil EVET/HAYIR istiyor. Doğrusal regresyonu doğrudan 0/1 etiketlere uygularsak ne olur?
Sezgi
Sınıflandırma (classification), bir kategori tahmin etmektir — regresyondaki gibi sürekli bir sayı değil. Lojistik regresyon, ismindeki “regresyon”a rağmen bir SINIFLANDIRMA yöntemidir: doğrusal bir kombinasyonu (tıpkı doğrusal regresyondaki gibi) alır, ama sonucu sigmoid fonksiyonu ile 0 ile 1 arasına “sıkıştırır” — böylece çıktı bir OLASILIK olarak yorumlanabilir.
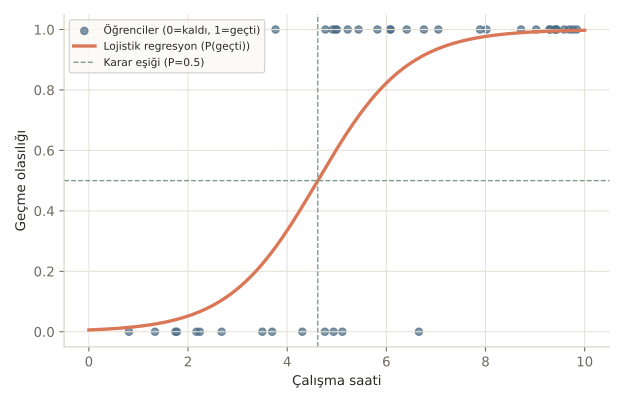
Neden düz doğrusal regresyon yetmiyor? Çünkü bir doğru, sınırsız büyüyüp küçülebilir — ama olasılık asla 0’ın altına inemez, 1’in üstüne çıkamaz. Sigmoid fonksiyonu, S şeklinde bir eğridir: uçlarda düzleşir (0’a ve 1’e yaklaşır ama hiç değmez), ortada hızlı geçiş yapar.
Mekanizma
Önce “yanlış” aracı deneyelim — 0/1 etikete düz bir doğru uydurmak:
Veri: çalışma saati -> geçti mi
# 40 öğrenci: çalışma saati -> sınavı geçti mi (0/1). Gerçek ilişki S şeklinde (sigmoid).
n = 40
calisma_saati = rng.uniform(0, 10, n)
gercek_olasilik = 1 / (1 + np.exp(-1.2 * (calisma_saati - 5)))
gecti = (rng.random(n) < gercek_olasilik).astype(int)

X = calisma_saati.reshape(-1, 1)
print(f"{n} öğrenci, {gecti.sum()} tanesi geçti, {n - gecti.sum()} tanesi kaldı")
40 öğrenci, 26 tanesi geçti, 14 tanesi kaldıDoğrusal regresyonun sorunu
# Önce "yanlış" aracı deneyelim: 0/1 etikete düz doğrusal regresyon uydurmak.
dogrusal = LinearRegression()
dogrusal.fit(X, gecti)
tahmin_0saat = dogrusal.predict([[0]])[0]
tahmin_10saat = dogrusal.predict([[10]])[0]
print(f"Doğrusal regresyon, 0 saat çalışana tahmini: {tahmin_0saat:.3f}")
print(f"Doğrusal regresyon, 10 saat çalışana tahmini: {tahmin_10saat:.3f}")
print("Bu sayılar bir OLASILIK olarak anlamsız -- 0'ın altına inip 1'in üstüne çıkabiliyor.")
Doğrusal regresyon, 0 saat çalışana tahmini: -0.111
Doğrusal regresyon, 10 saat çalışana tahmini: 1.171
Bu sayılar bir OLASILIK olarak anlamsız -- 0'ın altına inip 1'in üstüne çıkabiliyor.0 saat çalışan birine -0.111 “geçme olasılığı” — negatif bir olasılık anlamsız! Şimdi lojistik regresyonu deneyelim:
Lojistik regresyon modeli
lojistik = LogisticRegression()
lojistik.fit(X, gecti)
print(f"Lojistik regresyon katsayısı: {lojistik.coef_[0][0]:.4f}")
print(f"Lojistik regresyon kesişimi: {lojistik.intercept_[0]:.4f}")

karar_siniri = -lojistik.intercept_[0] / lojistik.coef_[0][0]
print(f"Karar sınırı (P=0.5 olduğu çalışma saati): {karar_siniri:.2f} saat")

tahmin_sinif = lojistik.predict(X)
dogruluk = accuracy_score(gecti, tahmin_sinif)
print(f"Eğitim doğruluğu: {dogruluk:.3f}")
Lojistik regresyon katsayısı: 1.1096
Lojistik regresyon kesişimi: -5.1226
Karar sınırı (P=0.5 olduğu çalışma saati): 4.62 saat
Eğitim doğruluğu: 0.875Model, %50 geçme olasılığının 4.62 saatte olduğunu buluyor — bu karar sınırıdır. Eğitim verisinde %87.5 doğrulukla sınıflandırıyor. Çoğu kişi “lojistik regresyon karmaşık bir algoritma” sanır. Değil, çünkü aslında doğrusal regresyonun (eğim × x + kesişim) çıktısını sigmoid fonksiyonundan geçirmekten ibaret — matematiksel çekirdek aynı, sadece çıktı bir olasılığa dönüştürülüyor.
Matematik
Sigmoid fonksiyonu ve lojistik regresyon
| Sembol | Anlamı |
|---|---|
| Doğrusal regresyondaki gibi hesaplanan “ham skor” — sınırsız aralıkta | |
| Sigmoid fonksiyonu — ‘yi (0, 1) aralığına sıkıştırır | |
| Modelin verdiği olasılık — verildiğinde, sınıf 1 olma ihtimali |
olduğunda — bu karar sınırıdır. büyüdükçe 1’e, küçüldükçe 0’a yaklaşır ama hiçbirine tam ulaşmaz. Katsayı ‘nin işareti ve büyüklüğü, arttıkça olasılığın ne kadar hızlı değiştiğini belirler.
Kod
Belirli çalışma saatleri için gerçek olasılık tahminlerine bakalım:
Farklı çalışma saatleri için olasılık
test_saatleri = np.array([2, 4, 5, 6, 8]).reshape(-1, 1)
olasiliklar = lojistik.predict_proba(test_saatleri)[:, 1]
for saat, p in zip(test_saatleri.ravel(), olasiliklar):
    print(f"  {saat} saat çalışan bir öğrencinin geçme olasılığı: %{p * 100:.1f}")
2 saat çalışan bir öğrencinin geçme olasılığı: %5.2
4 saat çalışan bir öğrencinin geçme olasılığı: %33.5
5 saat çalışan bir öğrencinin geçme olasılığı: %60.5
6 saat çalışan bir öğrencinin geçme olasılığı: %82.3
8 saat çalışan bir öğrencinin geçme olasılığı: %97.7Katsayıyı yorumlamanın bir yolu daha var — odds oranı:
Odds oranı yorumu
# exp(katsayı): 1 saat daha çalışmak, "geçme oranını (odds)" kaç KATINA çıkarıyor?
odds_orani = np.exp(lojistik.coef_[0][0])
print(f"\n1 saat daha çalışmak, geçme oranını (odds) {odds_orani:.2f} katına çıkarıyor.")
1 saat daha çalışmak, geçme oranını (odds) 3.03 katına çıkarıyor.1 saat daha çalışmak, geçme “oranını” (olasılık değil, odds = P/(1-P)) yaklaşık 3 katına çıkarıyor.
Nerede işe yarar
Lojistik regresyon, basitliğine rağmen gerçek dünyada en çok kullanılan sınıflandırma yöntemlerinden biridir:
- Evet/hayır kararları. Kredi onayı, hastalık teşhisi, müşteri kaybı (churn) tahmini gibi ikili sonuçlar.
- Yorumlanabilir bir başlangıç noktası. Katsayılar doğrudan “hangi özniteliğin ne yönde etkisi var” sorusuna cevap verir — bu, karmaşık modellerde (11+ derste göreceğimiz ağaçlar, topluluk yöntemleri) kaybolan bir avantajdır.
- Olasılık gerektiren durumlar. Sadece “evet/hayır” değil, “ne kadar olası” bilgisi gerektiğinde (örn. dolandırıcılık riski skoru).
Bu 3 hatayı yaparsın:
- Lojistik regresyonun çıktısını (predict_proba) doğrudan bir “kesinlik” gibi yorumlamak — %70 olasılık, modelin %70 “emin” olduğu anlamına gelmez, sadece verilen özniteliklerle hesaplanan istatistiksel bir tahmindir.
- Karar eşiğini her zaman 0.5 sanmak — dengesiz veri setlerinde (11. derste göreceğiz) farklı bir eşik çok daha iyi sonuç verebilir.
- Katsayıyı doğrudan “olasılık artışı” gibi okumak — katsayı, olasılığı değil ODDS’un LOGARİTMASINI doğrusal olarak etkiler; yorumlamak için
exp()almak gerekir.
Kendini test et
1. Doğrusal regresyonu doğrudan 0/1 sınıflandırma etiketlerine uygulamanın temel sorunu nedir?
- Çok yavaş çalışır
- Tahminler 0-1 aralığının dışına çıkabilir, bu da bir olasılık olarak anlamsızdır (doğru cevap)
- scikit-learn buna izin vermez
- Sadece büyük veri setlerinde sorun olur
Neden: Notebook'ta gördüğümüz gibi doğrusal regresyon -0.111 gibi negatif veya 1'in üzerinde değerler üretebilir; bir olasılık asla bu aralığın dışına çıkamaz.
2. Sigmoid fonksiyonu ne işe yarar?
- Veriyi standardize eder
- Sınırsız bir "ham skoru" (0, 1) aralığına sıkıştırarak bir olasılık haline getirir (doğru cevap)
- Katsayıları sıfırlar
- Sadece görselleştirme için kullanılır
Neden: Sigmoid, doğrusal regresyondaki gibi hesaplanan z değerini S şeklinde bir eğriyle 0 ile 1 arasına sıkıştırır, böylece çıktı geçerli bir olasılık olur.
3. Notebook'ta karar sınırı 4.62 saat olarak bulundu. Bu ne anlama gelir?
- Tüm öğrenciler tam 4.62 saat çalışmalı
- Model, 4.62 saat çalışan bir öğrenciye tam %50 geçme olasılığı veriyor -- bunun altı "kalır", üstü "geçer" tahmin ediliyor (doğru cevap)
- 4.62 saat en verimli çalışma süresi
- Bu sayı rastgele seçildi
Neden: Karar sınırı, modelin P=0.5 verdiği noktadır; bu değerin altında model "kalır" (P<0.5), üstünde "geçer" (P>0.5) tahmini yapar.
Özet
Özet
- Lojistik regresyon, sınıflandırma (kategori tahmini) için kullanılan, isimdeki "regresyon"a rağmen bir sınıflandırma yöntemidir.
- Doğrusal regresyonun ham skorunu sigmoid fonksiyonundan geçirerek geçerli bir olasılığa (0-1 arası) dönüştürür.
- Karar sınırı, modelin P=0.5 verdiği noktadır; varsayılan olarak bu eşiğe göre sınıflandırma yapılır.
- Katsayılar, olasılığı değil odds'un logaritmasını doğrusal olarak etkiler -- yorumlamak için exp() almak gerekir.
- Model hem sınıf tahmini (predict) hem de olasılık tahmini (predict_proba) verebilir.