

Random Forest
Önkoşul:Topluluk (ensemble) yöntemleri
Kanca
- derste bagging’i (aynı algoritmanın birden fazla bootstrap kopyası) gördük. Random Forest, ismiyle “ağaç” içeriyor ve bagging’e ÇOK benzer — ama tek bir ekstra rastgelelik ekliyor. Bu tek fark neden bu kadar önemli?
Sezgi
Random Forest = Bagging + her bölünmede rastgele bir öznitelik ALT KÜMESİ deneme. Düz bagging’de her ağaç, TÜM öznitelikler arasından en iyi bölünmeyi arar — bu yüzden çoğu ağaç, en güçlü özniteliğe (örn. gelir) benzer şekilde bölünme eğilimindedir, bu da ağaçları birbirine BENZETİR. Random Forest, her bölünmede sadece rastgele seçilmiş birkaç özniteliğe bakmaya ZORLAYARAK, ağaçları birbirinden daha da FARKLILAŞTIRIR.
- dersteki matematiği hatırla: topluluğun gücü, modellerin hatalarının BAĞIMSIZ olmasına dayanıyordu. Random Forest’ın bu ekstra rastgeleliği, tam olarak bu bağımsızlığı artırmak için var.
Mekanizma
Bagging ile Random Forest’ı aynı veride karşılaştıralım — 2 gerçek öznitelik (yaş, gelir) ve 4 saf gürültü özniteliği kullanarak:
2 gerçek + 4 gürültü öznitelik
# 6 öznitelik: sadece 2'si (yas, gelir) gerçekten etkili, 4'ü saf gürültü (8. dersi hatırla).
n = 200
yas = rng.uniform(18, 65, n)
gelir = rng.uniform(3, 25, n)
gurultu = rng.normal(0, 1, size=(n, 4))
skor = (yas - 40) / 15 + (gelir - 12) / 8 + rng.normal(0, 0.5, n)
satin_aldi = (skor > 0).astype(int)
X = np.column_stack([yas, gelir, gurultu])
isimler = ["yas", "gelir", "gurultu1", "gurultu2", "gurultu3", "gurultu4"]
print(f"{n} müşteri, {X.shape[1]} öznitelik (2 gerçek + 4 gürültü)")
200 müşteri, 6 öznitelik (2 gerçek + 4 gürültü)Bagging vs Random Forest
# Random Forest = Bagging + HER BÖLÜNMEDE rastgele bir öznitelik ALT KÜMESİ dene.
skor_bagging = cross_val_score(
    BaggingClassifier(DecisionTreeClassifier(), n_estimators=100, random_state=1), X, satin_aldi, cv=5
).mean()
skor_forest = cross_val_score(
    RandomForestClassifier(n_estimators=100, random_state=1), X, satin_aldi, cv=5
).mean()
print(f"Bagging (tam öznitelik seti her bölünmede): {skor_bagging:.3f}")
print(f"Random Forest (rastgele öznitelik alt kümesi her bölünmede): {skor_forest:.3f}")
print("Random Forest'ın ekstra rastgeleliği, ağaçları birbirinden daha da BAĞIMSIZLAŞTIRIYOR -- 19. dersteki bağımsızlık avantajını güçlendiriyor.")
Bagging (tam öznitelik seti her bölünmede): 0.800
Random Forest (rastgele öznitelik alt kümesi her bölünmede): 0.810
Random Forest'ın ekstra rastgeleliği, ağaçları birbirinden daha da BAĞIMSIZLAŞTIRIYOR -- 19. dersteki bağımsızlık avantajını güçlendiriyor.Küçük ama gerçek bir fark: Random Forest (0.810), düz bagging’den (0.800) biraz daha iyi. Şimdi Random Forest’ın gürültü özniteliklerine ne yaptığına bakalım:
Öznitelik önemleri
model = RandomForestClassifier(n_estimators=200, random_state=1)
model.fit(X, satin_aldi)
print("\nÖznitelik önemleri:")
for isim, onem in sorted(zip(isimler, model.feature_importances_), key=lambda x: -x[1]):
    print(f"  {isim:<10} {onem:.3f}")
print("Random Forest, gürültü özniteliklerini otomatik olarak DÜŞÜK öneme indirdi -- hiçbiri elle çıkarılmadı.")
Öznitelik önemleri:
  yas        0.351
  gelir      0.293
  gurultu1   0.109
  gurultu4   0.088
  gurultu3   0.083
  gurultu2   0.077
Random Forest, gürültü özniteliklerini otomatik olarak DÜŞÜK öneme indirdi -- hiçbiri elle çıkarılmadı.
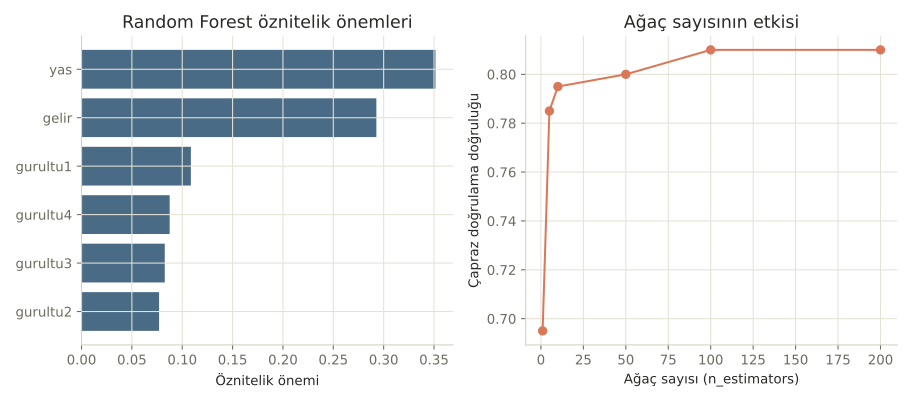
Yaş (0.351) ve gelir (0.293) açık ara en önemli, 4 gürültü özniteliği çok daha düşük (0.077-0.109) — ve bu, 8. dersteki Lasso gibi ELLE bir düzenlileştirme yapılmadan, doğal olarak ortaya çıkıyor. Çoğu kişi “öznitelik önemi, modelin hangi özniteliği KULLANDIĞINI gösterir” sanır. Kısmen doğru, ama asıl ölçtüğü şey, o özniteliğin ormandaki bölünmelerde ortalama olarak Gini kirliliğini NE KADAR azalttığıdır — yani öznitelik ne kadar sık ve ne kadar “faydalı” bölünmeler yaratıyor.
Matematik
Random Forest'ın iki rastgelelik kaynağı
| Sembol | Anlamı |
|---|---|
| Veri setinden rastgele, yerine koyarak seçilen bir alt örneklem (bagging’den) | |
| Her bölünmede değerlendirilecek rastgele öznitelik sayısı (Random Forest’a özgü) | |
| Toplam öznitelik sayısı |
Sınıflandırma için scikit-learn varsayılan olarak kullanır — yani 6 öznitelikten sadece ~2-3’ü her bölünmede değerlendirilir. Bu, her ağacı “farklı bir açıdan bakmaya” zorlar, bu da ormanın genel çeşitliliğini (ve dolayısıyla 19. dersteki bağımsızlık avantajını) artırır.
Kod
Ağaç sayısının etkisine bakalım:
Ağaç sayısının (n_estimators) etkisi
for n_agac in [1, 5, 10, 50, 200]:
    skor = cross_val_score(RandomForestClassifier(n_estimators=n_agac, random_state=1), X, satin_aldi, cv=5).mean()
    print(f"n_estimators={n_agac:<4} çapraz doğrulama doğruluğu: {skor:.3f}")
print("Ağaç sayısı arttıkça skor önce hızla yükselir, sonra bir noktadan sonra DÜZLEŞİR -- daha fazla ağaç zarar vermez ama sonsuza kadar iyileştirmez de.")
n_estimators=1 çapraz doğrulama doğruluğu: 0.695
n_estimators=5 çapraz doğrulama doğruluğu: 0.785
n_estimators=10 çapraz doğrulama doğruluğu: 0.795
n_estimators=50 çapraz doğrulama doğruluğu: 0.800
n_estimators=200 çapraz doğrulama doğruluğu: 0.810
Ağaç sayısı arttıkça skor önce hızla yükselir, sonra bir noktadan sonra DÜZLEŞİR -- daha fazla ağaç zarar vermez ama sonsuza kadar iyileştirmez de.1 ağaçtan 200 ağaca çıkarken skor 0.695’ten 0.810’a yükseliyor, ama artış bir noktadan sonra düzleşiyor — 50’den 200’e çıkmak sadece 0.01 kazandırıyor. Son olarak, Random Forest’ın ücretsiz bir doğrulama yöntemi daha var:
Out-of-bag (OOB) skoru
# Out-of-bag (OOB): her ağaç, bootstrap örneklemine dahil OLMAYAN verilerle "bedava" test edilebilir.
model_oob = RandomForestClassifier(n_estimators=200, random_state=1, oob_score=True)
model_oob.fit(X, satin_aldi)
print(f"\nOOB skoru (ayrı bir test seti gerektirmeden): {model_oob.oob_score_:.3f}")
print("Bu, çapraz doğrulamaya (9. ders) YAKIN bir tahmin veriyor ama EK hesaplama gerektirmiyor -- bagging'in bir yan ürünü.")
OOB skoru (ayrı bir test seti gerektirmeden): 0.810
Bu, çapraz doğrulamaya (9. ders) YAKIN bir tahmin veriyor ama EK hesaplama gerektirmiyor -- bagging'in bir yan ürünü.
OOB skoru (0.810), çapraz doğrulama skoruyla (0.810) neredeyse BİREBİR aynı çıktı — ama hiçbir ekstra hesaplama gerektirmeden! Her ağaç, kendi bootstrap örnekleminde OLMAYAN verilerle otomatik olarak test ediliyor.
Nerede işe yarar
Random Forest, pratikte en çok kullanılan makine öğrenmesi algoritmalarından biridir:
- Güçlü, “hazır çalışan” bir taban çizgisi. Az hiperparametre ayarıyla bile genelde iyi sonuç verir — yeni bir problemde ilk denenecek modellerden biri.
- Öznitelik önemini keşfetmek. Hangi özniteliklerin gerçekten işe yaradığını anlamak için hızlı ve pratik bir yöntem.
- Gürültülü, yüksek boyutlu veriler. Rastgele öznitelik alt kümesi seçimi, alakasız özniteliklerin etkisini doğal olarak azaltır.
Bu 3 hatayı yaparsın:
- Öznitelik önemini “nedensellik” gibi yorumlamak — yüksek önem, sadece o özniteliğin tahminlerde işe yaradığını gösterir, nedensel bir etkiyi KANITLAMAZ (20. istatistik dersini hatırla).
- Ağaç sayısını gereğinden fazla artırmak — bu derste gördüğümüz gibi, bir noktadan sonra kazanç neredeyse sıfırlanırken hesaplama maliyeti artmaya devam eder.
- OOB skorunu her zaman kullanmayı unutmak — ayrı bir doğrulama seti ayırmadan, hesaplaması neredeyse bedava bir performans tahmini sunuyor.
Kendini test et
1. Random Forest, düz bagging'den temel olarak nasıl farklıdır?
- Farklı bir algoritma (ağaç yerine doğrusal model) kullanır
- Bagging'e ek olarak, her bölünmede sadece rastgele seçilmiş bir öznitelik alt kümesini değerlendirir (doğru cevap)
- Sadece tek bir ağaç kurar
- Veriyi önceden ölçekler
Neden: Random Forest = Bagging + her bölünmede rastgele öznitelik alt kümesi seçimi. Bu ekstra rastgelelik, ağaçları birbirinden daha bağımsız hale getirir.
2. Notebook'ta 4 saf gürültü özniteliği neden düşük öznitelik önemi aldı?
- Elle çıkarıldılar
- Ormandaki bölünmelerde bu öznitelikler Gini kirliliğini nadiren ve az azalttığı için, önem skorları düşük çıktı (doğru cevap)
- Rastgele bir sonuçtu, tekrar çalıştırılsa farklı çıkardı
- scikit-learn gürültüyü otomatik siliyor
Neden: Öznitelik önemi, o özniteliğin ormandaki bölünmelerde ortalama olarak ne kadar Gini kirliliği azalttığını ölçer; gürültü özniteliklerinin gerçek bir sinyali olmadığı için bu azaltma düşük kalır.
3. OOB (out-of-bag) skorunun avantajı nedir?
- Modeli daha hızlı eğitir
- Ayrı bir test seti ayırmaya veya ekstra çapraz doğrulama hesaplamaya gerek kalmadan, bootstrap sürecinin bir yan ürünü olarak güvenilir bir performans tahmini verir (doğru cevap)
- Her zaman çapraz doğrulamadan daha yüksek çıkar
- Öznitelik sayısını azaltır
Neden: Her ağaç, kendi bootstrap örnekleminde bulunmayan (out-of-bag) verilerle otomatik olarak test edilebilir; bu da ek hesaplama maliyeti olmadan çapraz doğrulamaya yakın bir tahmin sağlar.
Özet
Özet
- Random Forest, bagging'e ek olarak her bölünmede rastgele bir öznitelik alt kümesi kullanarak ağaçları daha da bağımsızlaştırır.
- Bu ekstra rastgelelik, düz bagging'e göre küçük ama gerçek bir performans artışı sağlar.
- Öznitelik önemi, gerçek ve gürültü öznitelikleri arasındaki farkı elle bir işlem yapmadan ortaya çıkarır.
- Ağaç sayısı arttıkça performans yükselir ama bir noktadan sonra düzleşir -- gereğinden fazla artırmak sadece maliyeti yükseltir.
- OOB skoru, ekstra hesaplama gerektirmeden çapraz doğrulamaya yakın bir performans tahmini sunar.