

XGBoost
Önkoşul:Gradient Boosting
Kanca
- derste Gradient Boosting’in mantığını (kalıntıya uydur, ekle, tekrarla) gördük. XGBoost, bu AYNI fikri kullanır — ama Kaggle yarışmalarının uzun süre standardı olmasının bir nedeni var: aynı sonuçları çok daha hızlı ve daha akıllıca üretiyor.
Sezgi
XGBoost (Extreme Gradient Boosting), Gradient Boosting’in matematiksel çekirdeğini korur ama mühendislik açısından ciddi şekilde optimize eder — düzenlileştirmeyi (8. ders) doğrudan kayıp fonksiyonuna gömer, paralel hesaplama kullanır, ve gereksiz yere ağaç eklemeyi otomatik olarak DURDURABİLİR.
Bu üç özellik birlikte, “aynı Gradient Boosting fikrini, çok daha az hesaplama ve çok daha az manuel ayarla çalıştır” sonucunu veriyor.
Mekanizma
Önce hız farkını doğrudan ölçelim:
Daha büyük bir veri seti
# Daha büyük bir veri seti -- XGBoost'un hız avantajının görünmesi için.
n = 2000
yas = rng.uniform(18, 65, n)
gelir = rng.uniform(3, 25, n)
gurultu = rng.normal(0, 1, size=(n, 5))
skor = (yas - 40) / 15 + (gelir - 12) / 8 + rng.normal(0, 0.6, n)
satin_aldi = (skor > 0).astype(int)
X = np.column_stack([yas, gelir, gurultu])
print(f"{n} müşteri, {X.shape[1]} öznitelik")
2000 müşteri, 7 öznitelikHız karşılaştırması
baslangic = perf_counter()
gb = GradientBoostingClassifier(n_estimators=200, max_depth=3, random_state=11)
skor_gb = cross_val_score(gb, X, satin_aldi, cv=5).mean()
sure_gb = perf_counter() - baslangic

baslangic = perf_counter()
xgb = XGBClassifier(n_estimators=200, max_depth=3, random_state=11, eval_metric="logloss")
skor_xgb = cross_val_score(xgb, X, satin_aldi, cv=5).mean()
sure_xgb = perf_counter() - baslangic

print(f"scikit-learn GradientBoosting: doğruluk={skor_gb:.3f}, süre={sure_gb:.2f}s")
print(f"XGBoost:                       doğruluk={skor_xgb:.3f}, süre={sure_xgb:.2f}s")
print(f"XGBoost {sure_gb / sure_xgb:.1f}x daha hızlı, doğrulukta neredeyse aynı.")
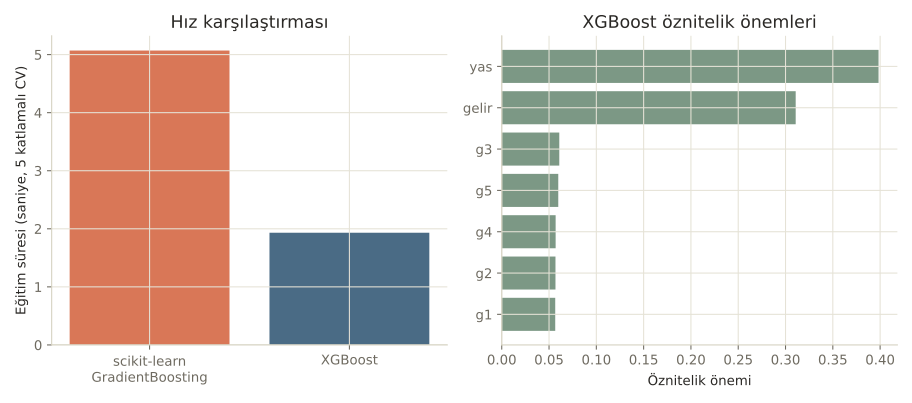
scikit-learn GradientBoosting: doğruluk=0.859, süre=5.07s
XGBoost: doğruluk=0.851, süre=1.93s
XGBoost 2.6x daha hızlı, doğrulukta neredeyse aynı.XGBoost, scikit-learn’ün Gradient Boosting’inden 2.6 kat hızlı, doğrulukta neredeyse hiç fark yok (0.851 vs 0.859). Şimdi XGBoost’a özgü bir özelliği — erken durdurmayı — deneyelim:
Erken durdurma
# XGBoost'un pratik bir özelliği: doğrulama skoru artık iyileşmiyorsa eğitimi ERKEN durdurabilir.
from sklearn.model_selection import train_test_split

X_egitim, X_dogrulama, y_egitim, y_dogrulama = train_test_split(X, satin_aldi, test_size=0.2, random_state=11)
model_erken = XGBClassifier(n_estimators=1000, max_depth=3, random_state=11, eval_metric="logloss", early_stopping_rounds=10)
model_erken.fit(X_egitim, y_egitim, eval_set=[(X_dogrulama, y_dogrulama)], verbose=False)
print(f"\n1000 ağaç istendi, ama erken durdurma {model_erken.best_iteration + 1} ağaçta durdu.")
print("Doğrulama skoru iyileşmeyi bıraktığında devam etmek sadece zaman kaybettirir (ve aşırı öğrenme riski taşır).")
1000 ağaç istendi, ama erken durdurma 27 ağaçta durdu.
Doğrulama skoru iyileşmeyi bıraktığında devam etmek sadece zaman kaybettirir (ve aşırı öğrenme riski taşır).
1000 ağaç istedik ama model, doğrulama skoru 10 tur boyunca iyileşmeyince kendiliğinden 27 ağaçta durdu! Çoğu kişi “daha fazla ağaç her zaman daha iyi sonuç verir” sanır. 22. dersten hatırlarsak yanlış, çünkü bir noktadan sonra ekstra ağaçlar sadece eğitim verisine (gürültüsüyle) daha da uyar, gerçek performansı artırmaz — erken durdurma, bunu ELLE denemene gerek kalmadan otomatik tespit ediyor.
Matematik
XGBoost'un kayıp fonksiyonu
| Sembol | Anlamı |
|---|---|
| Standart kayıp terimi (22. dersteki gibi) — tahmin hatasını ölçer | |
| XGBoost’a özgü düzenlileştirme terimi — her ağacın KARMAŞIKLIĞINI cezalandırır | |
| , | Ağaçtaki yaprak sayısı ve yaprak ağırlıkları — ve bunları büyümekten caydırır |
Sıradan Gradient Boosting sadece hata terimini minimize ederken, XGBoost başından beri KARMAŞIKLIK cezasını da kayba dahil eder — bu, 8. dersteki Ridge/Lasso’nun mantığının, ağaç yapısına doğrudan gömülmüş hali.
Kod
XGBoost’un öznitelik önemi ve düzenlileştirme davranışına bakalım:
Öznitelik önemleri
model = XGBClassifier(n_estimators=200, max_depth=3, random_state=11, eval_metric="logloss")
model.fit(X, satin_aldi)
isimler = ["yas", "gelir", "g1", "g2", "g3", "g4", "g5"]
print("\nÖznitelik önemleri (XGBoost):")
for isim, onem in sorted(zip(isimler, model.feature_importances_), key=lambda x: -x[1]):
    print(f"  {isim:<8} {onem:.3f}")
Öznitelik önemleri (XGBoost):
  yas      0.398
  gelir    0.311
  g3       0.061
  g5       0.060
  g4       0.057
  g2       0.057
  g1       0.057
reg_lambda düzenlileştirme parametresi
# XGBoost, 8. dersteki Ridge/Lasso mantığına benzer düzenlileştirme parametreleri sunar.
for reg_lambda in [0, 1, 10, 50]:
    m = XGBClassifier(n_estimators=200, max_depth=4, reg_lambda=reg_lambda, random_state=11, eval_metric="logloss")
    skor = cross_val_score(m, X, satin_aldi, cv=5).mean()
    print(f"reg_lambda={reg_lambda:<4} çapraz doğrulama doğruluğu: {skor:.3f}")
reg_lambda=0 çapraz doğrulama doğruluğu: 0.840
reg_lambda=1 çapraz doğrulama doğruluğu: 0.847
reg_lambda=10 çapraz doğrulama doğruluğu: 0.853
reg_lambda=50 çapraz doğrulama doğruluğu: 0.855reg_lambda arttıkça (0’dan 50’ye) doğruluk 0.840’tan 0.855’e YÜKSELİYOR — düzenlileştirmesiz model hafifçe aşırı öğrenmiş durumdaydı, ceza terimi bunu düzeltiyor.
Nerede işe yarar
XGBoost, uzun süre yapılandırılmış veri yarışmalarının standardı olmuştur:
- Kaggle ve benzeri yarışmalarda klasik bir seçim. Hız ve doğruluk dengesi, birçok tablo veri probleminde hâlâ rekabetçi.
- Büyük veri setlerinde pratik. Paralelleştirme ve optimize edilmiş bellek kullanımı, milyonlarca satırlık verilerde bile makul sürede çalışmasını sağlar.
- Yerleşik düzenlileştirme sayesinde daha az elle ayar gerektirir.
reg_lambda,reg_alphagibi parametreler, aşırı öğrenmeyi kontrol etmek için hazır araçlar sunar.
Bu 3 hatayı yaparsın:
early_stopping_roundskullanmadan sabit, büyük birn_estimatorsile eğitmek — bu derste gördüğümüz gibi, gereksiz ağaçlar zaman kaybettirir ve aşırı öğrenme riskini artırır.- Düzenlileştirme parametrelerini (
reg_lambda,reg_alpha,max_depth) hiç ayarlamadan varsayılan değerlerle bırakmak — bu derstereg_lambda’nın doğruluğu gerçekten değiştirdiğini gördük. - XGBoost’un “her zaman scikit-learn’den daha iyi” olduğunu sanmak — bu örnekte doğruluk farkı çok küçüktü (0.851 vs 0.859); asıl fark HIZDA ortaya çıktı, özellikle büyük veride önemli hale gelir.
Kendini test et
1. Notebook'ta erken durdurma neden 1000 yerine 27 ağaçta durdu?
- Bir hata oluştu
- Doğrulama skoru 10 tur boyunca iyileşmeyince, XGBoost devam etmenin faydasız (ve aşırı öğrenme riski taşıyan) olduğunu tespit etti (doğru cevap)
- Veri seti tükendi
- XGBoost her zaman 27 ağaçta durur
Neden: early_stopping_rounds parametresi, doğrulama skoru belirtilen tur sayısı boyunca iyileşmezse eğitimi otomatik olarak durdurur -- gereksiz hesaplamayı ve aşırı öğrenmeyi önler.
2. XGBoost'un kayıp fonksiyonu, sıradan Gradient Boosting'den (22. ders) temel olarak nasıl farklıdır?
- Farklı bir hata ölçütü kullanır
- Hata terimine ek olarak, her ağacın karmaşıklığını cezalandıran bir düzenlileştirme terimi içerir (doğru cevap)
- Sadece sınıflandırma yapabilir
- Ağaç kullanmaz
Neden: XGBoost'un kayıp fonksiyonu, standart hata terimine ek olarak ağaç karmaşıklığını (yaprak sayısı, yaprak ağırlıkları) cezalandıran bir düzenlileştirme terimi içerir -- bu, Ridge/Lasso'nun (8. ders) mantığının ağaç yapısına gömülmüş hali.
3. Notebook'ta reg_lambda arttıkça (0'dan 50'ye) doğruluk neden YÜKSELDİ, düşmedi?
- Rastgele bir sonuç
- Düzenlileştirmesiz model hafifçe aşırı öğrenmiş durumdaydı; ceza terimi bu aşırı uyumu azaltarak genellemeyi iyileştirdi (doğru cevap)
- reg_lambda öznitelik sayısını değiştiriyor
- Bu her zaman böyle olur, düzenlileştirme her zaman doğruluğu artırır
Neden: Düzenlileştirmesiz (reg_lambda=0) model muhtemelen eğitim verisine hafif aşırı uymuştu; artan ceza terimi bu aşırı uyumu azaltarak çapraz doğrulama performansını iyileştirdi -- ama bu her veri setinde garanti değildir.
Özet
Özet
- XGBoost, Gradient Boosting'in matematiğini korur ama hız ve düzenlileştirme açısından ciddi şekilde optimize eder.
- Erken durdurma, doğrulama skoru iyileşmeyi bıraktığında eğitimi otomatik olarak durdurur.
- Düzenlileştirme (reg_lambda, reg_alpha gibi), ağaç karmaşıklığını doğrudan kayıp fonksiyonuna gömerek aşırı öğrenmeyi kontrol eder.
- XGBoost'un asıl avantajı genelde doğrulukta değil, HIZ ve büyük veriye ölçeklenebilirlikte ortaya çıkar.
- Yerleşik düzenlileştirme parametreleri, aşırı öğrenmeyi kontrol etmek için hazır ve etkili araçlar sunar.