

K-Means
Önkoşul:PCA
Kanca
- derste PCA ile hiç etiket kullanmadan veriyi yeniden ifade ettik. K-Means, gözetimsiz öğrenmenin bir adım ötesine geçiyor: veriyi hiç etiket olmadan GRUPLARA ayırmaya çalışıyor. Ama bu grupları nasıl buluyor, ve her zaman doğru grupları mı buluyor?
Sezgi
K-Means, iki basit adımı tekrar tekrar uygular: (1) her noktayı EN YAKIN merkeze ata, (2) her merkezi, kendisine atanan noktaların ortalamasına taşı. Bu iki adım, merkezler artık hareket etmeyene kadar tekrarlanır.
Adım 0, sıradaki faz: noktaları en yakın merkeze ata.
“Sonraki adım” düğmesine tekrar tekrar bas — atama ve güncelleme fazlarının nasıl dönüşümlü çalıştığını izle. Şimdi “Kötü başlangıç”ı dene: bir merkez, tüm veriden ÇOK uzakta başlıyor. Adımları ilerlet — bu merkez hiçbir noktayı “kazanamıyor” ve iki yakın küme birbirine YANLIŞLIKLA karışabiliyor.
Mekanizma
Gerçek veriyle, iki yakın + bir uzak kümeden oluşan bir yapıda ilerleyelim:
İki yakın + bir uzak küme
# İki YAKIN küme + bir UZAK küme -- kötü ilklendirmenin gerçek bir tuzak kurabileceği yapı.
merkezler = [(-1, -1), (1, -1), (6, -1)]
X = np.vstack([rng.normal(m, 0.5, size=(15, 2)) for m in merkezler])
print(f"{len(X)} nokta, 3 gerçek küme (ikisi yakın, biri uzak)")
45 nokta, 3 gerçek küme (ikisi yakın, biri uzak)Akıllı ilklendirme (k-means++)
model_iyi = KMeans(n_clusters=3, init="k-means++", n_init=10, random_state=1)
model_iyi.fit(X)
print(f"k-means++ ile (varsayılan, akıllı ilklendirme) inertia: {model_iyi.inertia_:.2f}")
print(f"Küme boyutları: {np.bincount(model_iyi.labels_)}")
k-means++ ile (varsayılan, akıllı ilklendirme) inertia: 16.89
Küme boyutları: [16 15 14]Kasıtlı kötü ilklendirme
# Kasıtlı kötü bir başlangıç: bir merkez tüm veriden ÇOK uzakta, tek bir deneme (n_init=1).
kotu_baslangic = np.array([[-1, -1], [1, -1], [20, 20]])
model_kotu = KMeans(n_clusters=3, init=kotu_baslangic, n_init=1, max_iter=15, random_state=1)
model_kotu.fit(X)
print(f"\nKötü ilklendirme ile inertia: {model_kotu.inertia_:.2f}")
print(f"Küme boyutları: {np.bincount(model_kotu.labels_, minlength=3)}")
print(f"İyi ilklendirmeye göre {model_kotu.inertia_ / model_iyi.inertia_:.2f} kat -- bu sefer scikit-learn kurtuldu!")
print("scikit-learn'ün KMeans'i, HİÇBİR noktayı kazanamayan ('yetim') bir merkezi otomatik olarak")
print("en uzak noktaya taşıyan bir güvenlik önlemi içeriyor -- ama bu, aşağıdaki deney gösterdiği gibi")
print("kötü yerel optimumlara düşme riskini TAMAMEN ortadan kaldırmıyor.")
Kötü ilklendirme ile inertia: 16.89
Küme boyutları: [14 16 15]
İyi ilklendirmeye göre 1.00 kat -- bu sefer scikit-learn kurtuldu!
scikit-learn'ün KMeans'i, HİÇBİR noktayı kazanamayan ('yetim') bir merkezi otomatik olarak
en uzak noktaya taşıyan bir güvenlik önlemi içeriyor -- ama bu, aşağıdaki deney gösterdiği gibi
kötü yerel optimumlara düşme riskini TAMAMEN ortadan kaldırmıyor.
Bu sefer scikit-learn kurtuldu — kütüphane, hiçbir noktayı kazanamayan “yetim” bir merkezi otomatik olarak en uzak noktaya taşıyan bir güvenlik önlemi içeriyor. Ama bu, sorunu TAMAMEN ortadan kaldırmıyor:
Rastgele başlangıçların gerçek başarısızlık oranı
# k-means++, ilk merkezleri TAMAMEN rastgele değil, birbirinden UZAK olacak şekilde akıllıca seçer.
# Bu yüzden yukarıdaki gibi bir tuzağa çok daha az düşer -- scikit-learn'ün modern
# n_init="auto" varsayılanı da bu akıllı başlangıca güvenip k-means++ ile TEK deneme yapar.
basarisiz_sayisi = 0
denemeler = 20
for tekrar in range(denemeler):
    rastgele_rng = np.random.default_rng(tekrar)
    rastgele_baslangic_indeksleri = rastgele_rng.choice(len(X), 3, replace=False)
    m = KMeans(n_clusters=3, init=X[rastgele_baslangic_indeksleri], n_init=1, max_iter=15)
    m.fit(X)
    if m.inertia_ > model_iyi.inertia_ * 1.5:
        basarisiz_sayisi += 1
print(f"\n{denemeler} rastgele (n_init=1) denemeden {basarisiz_sayisi} tanesi kötü bir yerel optimuma takıldı.")
print("Savunma iki katmanlı: k-means++ (akıllı başlangıç) + n_init (çok deneme, en düşük inertia'yı seç).")
print("scikit-learn 1.4+ varsayılanı n_init='auto': k-means++ ile 1 deneme, init='random' ile 10 deneme.")
20 rastgele (n_init=1) denemeden 9 tanesi kötü bir yerel optimuma takıldı.
Savunma iki katmanlı: k-means++ (akıllı başlangıç) + n_init (çok deneme, en düşük inertia'yı seç).
scikit-learn 1.4+ varsayılanı n_init='auto': k-means++ ile 1 deneme, init='random' ile 10 deneme.
20 tamamen rastgele başlangıçtan 9 tanesi (%45) kötü bir yerel optimuma takıldı! Çoğu kişi “K-Means her zaman doğru kümeleri bulur” sanır. Değil, çünkü algoritma sadece MEVCUT atamaya göre yerel bir iyileştirme yapar — başlangıç noktası kötüyse, hiçbir zaman GERÇEK en iyi çözüme ulaşamayabilir. Bu riske karşı iki savunma var: AKILLI başlangıç (k-means++) ve ÇOK SAYIDA deneme (n_init). scikit-learn’ün eski sürümleri n_init=10 kullanırdı; 1.4’ten beri varsayılan n_init="auto" — yani k-means++ ile TEK deneme (akıllı başlangıca güvenir), init="random" ile 10 deneme.
Matematik
K-Means'in optimizasyon hedefi
| Sembol | Anlamı |
|---|---|
| ‘inci kümedeki noktalar | |
| ‘inci kümenin merkezi (kendisine atanan noktaların ortalaması) | |
| Inertia | Her noktanın, kendi merkezine olan kare mesafesinin TOPLAMI — ne kadar düşükse kümeler o kadar “sıkı” |
K-Means’in “ata, sonra güncelle” döngüsü, bu inertia’yı HER ADIMDA azaltır (asla artırmaz) — ama sadece YEREL bir minimuma iner, global en iyiye ulaşacağı garanti edilmez. Bu, 7. dersteki gradyan inişinin de paylaştığı bir sınırlamadır.
Kod
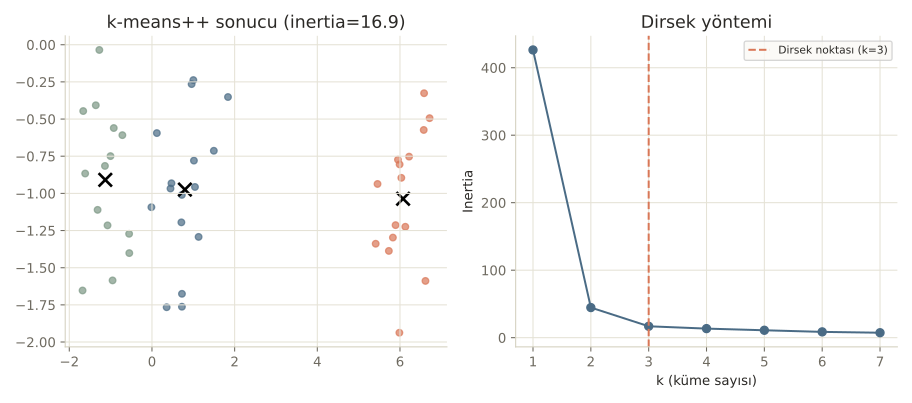
Peki kaç küme (k) kullanmalıyız? “Dirsek yöntemi” bir ipucu verir:
Dirsek yöntemi ile k seçimi
# Doğru k'yı nasıl seçeriz? "Dirsek yöntemi": farklı k'lar için inertia'ya bak.
inertialar = []
for k in range(1, 8):
    m = KMeans(n_clusters=k, n_init=10, random_state=1)
    m.fit(X)
    inertialar.append(m.inertia_)
    print(f"k={k}  inertia={m.inertia_:.2f}")
print("k=3'ten sonra inertia'daki azalma HIZLA yavaşlıyor -- bu 'dirsek' noktası, doğru k için iyi bir ipucu.")
k=1 inertia=426.29
k=2 inertia=44.63
k=3 inertia=16.89
k=4 inertia=13.46
k=5 inertia=10.99
k=6 inertia=8.61
k=7 inertia=7.35
k=3'ten sonra inertia'daki azalma HIZLA yavaşlıyor -- bu 'dirsek' noktası, doğru k için iyi bir ipucu.k=1’den k=3’e geçerken inertia 426’dan 16.9’a dramatik şekilde düşüyor, ama k=3’ten sonra azalma HIZLA yavaşlıyor (13.5, 11.0, 8.6…) — bu “dirsek” noktası, gerçek küme sayısının 3 olduğunu işaret ediyor.
Nerede işe yarar
K-Means, basitliği ve hızı sayesinde en yaygın kullanılan kümeleme yöntemidir:
- Müşteri segmentasyonu. Etiket olmadan, benzer davranış gösteren müşteri gruplarını keşfetmek.
- Görüntü sıkıştırma. Bir görüntüdeki renkleri az sayıda “temsilci” renge (küme merkezine) indirgemek.
- Veri keşfi için hızlı bir ilk adım. Yeni bir veri setinde doğal gruplaşmaların olup olmadığını hızlıca görmek.
Bu 3 hatayı yaparsın:
init="random"ile tek deneme yapmak (veya elle tek bir başlangıç vermek) — bu derste gördüğümüz gibi, akıllı başlangıç olmadan tek deneme, kötü bir yerel optimuma takılma riskini önemli ölçüde artırır.- Öznitelikleri ölçeklemeden K-Means kullanmak — mesafeye dayalı olduğu için, 16. derste KNN’de gördüğümüz ölçekleme sorunu burada da geçerlidir.
- Dirsek yöntemini “kesin bir cevap” gibi görmek — bazı veri setlerinde dirsek net değildir; kümeleme başarı metrikleri (28. ders) daha objektif bir karşılaştırma sağlayabilir.
Kendini test et
1. K-Means'in 'ata, sonra merkez güncelle' döngüsü ne zaman durur?
- Sabit bir süre sonra
- Merkezler artık hareket etmediğinde (veya çok az hareket ettiğinde) (doğru cevap)
- Rastgele bir noktada
- Sadece 1 tur sonra
Neden: Algoritma, atama ve güncelleme adımlarını, merkezlerin konumu stabilize olana (artık değişmeyene) kadar tekrarlar.
2. Notebook'ta 20 rastgele başlangıçtan 9'unun kötü bir yerel optimuma takılması neyi gösteriyor?
- Kod hatalıydı
- K-Means sadece YEREL bir iyileştirme yapar; başlangıç noktası kötüyse global en iyi çözüme ulaşamayabilir (doğru cevap)
- Veri seti çok küçüktü
- K-Means hiçbir zaman doğru sonuç veremez
Neden: K-Means'in 'ata-güncelle' döngüsü her adımda inertia'yı azaltır ama sadece yerel bir minimuma iner -- bu yüzden farklı başlangıçlar farklı (bazen kötü) sonuçlara yol açabilir.
3. scikit-learn'ün n_init parametresi (birden fazla başlangıç denemesi) ne işe yarar?
- Modeli kasıtlı olarak yavaşlatmak için
- Birden fazla başlangıç deneyip en düşük inertia'yı veren sonucu seçerek, kötü bir yerel optimuma takılma riskini azaltmak için (doğru cevap)
- Küme sayısını (k) otomatik belirlemek için
- Hiçbir özel nedeni yok, rastgele bir varsayılan
Neden: Tek bir başlangıç kötü bir yerel optimuma takılabilir; n_init birden fazla deneme yapıp en iyi (en düşük inertia'lı) sonucu seçerek bu riski azaltır. Modern scikit-learn'de varsayılan n_init="auto": k-means++ ile tek deneme (akıllı başlangıca güvenir), init="random" ile 10 deneme.
Özet
Özet
- K-Means, noktaları en yakın merkeze atayıp merkezleri güncelleyerek, inertia'yı (iç-küme hatasını) azaltan bir döngü çalıştırır.
- Bu döngü sadece YEREL bir iyileştirme yapar -- global en iyi çözüme ulaşacağı garanti edilmez.
- Kötü bir başlangıç, kümelerin yanlış birleşmesine yol açabilir; k-means++ (akıllı başlangıç) ve n_init (çok sayıda deneme) bu riski azaltır.
- Dirsek yöntemi, farklı k değerleri için inertia'ya bakarak makul bir küme sayısı önerir.
- K-Means, mesafeye dayandığı için öznitelik ölçeklemesi gerektirir (KNN'deki gibi).