

Isolation Forest
Önkoşul:DBSCAN
Kanca
- derste DBSCAN’in “gürültü” noktalarını yan ürün olarak tespit ettiğini gördük. Isolation Forest, anomali tespitini bir yan ürün değil, TEK amaç haline getiriyor — ve bunu şaşırtıcı derecede basit bir fikirle yapıyor: anormal noktalar, İZOLE ETMESİ KOLAY noktalardır.
Sezgi
Isolation Forest’ın fikri şu: bir noktayı rastgele bölünmelerle “izole etmek” (diğer tüm noktalardan ayırmak) için gereken adım sayısına bak. Yoğun bir bölgedeki normal bir nokta, çok sayıda komşusu olduğu için izole edilmesi ÇOK adım sürer. Ama izole, uzak bir anomali, tek bir rastgele bölünmeyle bile diğer her şeyden ayrılabilir — çünkü zaten etrafında kimse yok.
Bu, 17-24. derste gördüğümüz karar ağaçlarına benzer bir yapı kullanır (rastgele bölünmeler, orman) ama TAMAMEN farklı bir amaç için: sınıflandırma/regresyon yapmak yerine, “bu noktayı izole etmek ne kadar kolay?” sorusuna cevap arar.
Mekanizma
Normal noktalardan oluşan yoğun bir bulut + birkaç gerçek anomaliyle başlayalım:
Normal veri + gerçek anomaliler
# Normal işlemler (yoğun bir bulut) + birkaç gerçek anomalinin (uzak, izole nokta) karışımı.
normal_veri = rng.normal([0, 0], 1.0, size=(180, 2))
anomaliler = rng.uniform([-6, -6], [6, 6], size=(10, 2))
# Anomalileri normal bulutun İÇİNDEN uzaklaştır (gerçekten izole olsunlar).
anomaliler = anomaliler[np.linalg.norm(anomaliler, axis=1) > 3.5][:8]
X = np.vstack([normal_veri, anomaliler])
gercek_anomali_mi = np.array([0] * len(normal_veri) + [1] * len(anomaliler))
print(f"{len(X)} nokta: {len(normal_veri)} normal + {len(anomaliler)} gerçek anomali")
188 nokta: 180 normal + 8 gerçek anomaliŞimdi “izolasyon” fikrini elle deneyelim — rastgele bölünmelerle bir noktayı izole etmek kaç adım sürüyor?
İzolasyon derinliği: normal vs anomali
# Fikir: bir noktayı rastgele bölünmelerle "izole etmek" için gereken adım sayısı, o nokta
# ne kadar İZOLE ise o kadar AZDIR (etrafında az komşu olduğu için erken ayrılır).
def rastgele_izolasyon_derinligi(X, hedef_indeks, maks_derinlik=20):
    indeksler = np.arange(len(X))
    derinlik = 0
    while len(indeksler) > 1 and derinlik < maks_derinlik:
        oznitelik = rng.integers(0, X.shape[1])
        degerler = X[indeksler, oznitelik]
        if degerler.min() == degerler.max():
            break
        esik = rng.uniform(degerler.min(), degerler.max())
        hedef_deger = X[hedef_indeks, oznitelik]
        if hedef_deger < esik:
            indeksler = indeksler[degerler < esik]
        else:
            indeksler = indeksler[degerler >= esik]
        derinlik += 1
        if hedef_indeks not in indeksler:
            break
    return derinlik

# Tek bir nokta yerine, TÜM normal noktaların ve TÜM anomalilerin ortalama izolasyon derinliğine bakalım
# (tek noktada rastgele bölünmeler gürültülü olabilir; birçok noktayı ortalamak asıl örüntüyü ortaya çıkarır).
tekrar = 5
normal_derinlikler = [rastgele_izolasyon_derinligi(X, i) for i in range(len(normal_veri)) for _ in range(tekrar)]
anomali_derinlikler = [rastgele_izolasyon_derinligi(X, len(normal_veri) + i) for i in range(len(anomaliler)) for _ in range(tekrar)]
print(f"Normal noktaları izole etmek için ORTALAMA adım sayısı: {np.mean(normal_derinlikler):.2f}")
print(f"Anomalileri izole etmek için ORTALAMA adım sayısı: {np.mean(anomali_derinlikler):.2f}")
print("Anomaliler, ortalamada daha AZ adımda izole ediliyor -- Isolation Forest'ın çekirdek fikri tam olarak bu;")
print("gerçek gücü ise YÜZLERCE ağacın bu derinlikleri ORTALAYARAK gürültüden arındırılmış, güvenilir bir skor çıkarmasında.")
Normal noktaları izole etmek için ORTALAMA adım sayısı: 12.34
Anomalileri izole etmek için ORTALAMA adım sayısı: 4.80
Anomaliler, ortalamada daha AZ adımda izole ediliyor -- Isolation Forest'ın çekirdek fikri tam olarak bu;
gerçek gücü ise YÜZLERCE ağacın bu derinlikleri ORTALAYARAK gürültüden arındırılmış, güvenilir bir skor çıkarmasında.Normal noktaları izole etmek ortalama 12.3 adım sürerken, anomalileri izole etmek sadece 4.8 adım sürüyor — 2.6 kat daha az! Çoğu kişi “anomali tespiti için önce ‘normal’in ne olduğunu MODELLEMEK gerekir” sanır. Isolation Forest için değil, çünkü algoritma normal olanı hiç tanımlamaya çalışmıyor — sadece “bu noktayı ayırmak ne kadar KOLAY” sorusuna cevap arıyor, bu da dolaylı olarak anormalliği ölçüyor.
Matematik
Anomali skoru formülü
| Sembol | Anlamı |
|---|---|
| noktasının, TÜM ağaçlardaki ortalama izolasyon derinliği | |
| örneklemli rastgele bir ağaçta beklenen ortalama derinlik — normalleştirme sabiti | |
| 0 ile 1 arası anomali skoru — 1’e yakın: kesin anomali, 0.5: belirsiz, 0’a yakın: kesin normal |
küçükse (nokta kolay izole ediliyorsa), 1’e yaklaşır. Bu skor, TEK bir ağaca değil YÜZLERCE ağacın ortalamasına dayanır — bu da 19-20. derste gördüğümüz topluluk mantığının (bagging/Random Forest) gürültüyü azaltma avantajını buraya taşır.
Kod
Şimdi gerçek Isolation Forest’ı çalıştıralım:
Isolation Forest modeli
model = IsolationForest(n_estimators=200, contamination=0.05, random_state=3)
tahmin = model.fit_predict(X)  # -1 = anomali, 1 = normal
skorlar = model.decision_function(X)  # düşük skor = daha anormal

bulunan_anomali_sayisi = np.sum(tahmin == -1)
print(f"\nIsolation Forest'ın anomali olarak işaretlediği nokta sayısı: {bulunan_anomali_sayisi}")
gercek_anomali_indeksleri = np.where(gercek_anomali_mi == 1)[0]
dogru_yakalanan = np.sum(tahmin[gercek_anomali_indeksleri] == -1)
print(f"Gerçek {len(anomaliler)} anomaliden doğru yakalanan: {dogru_yakalanan}")
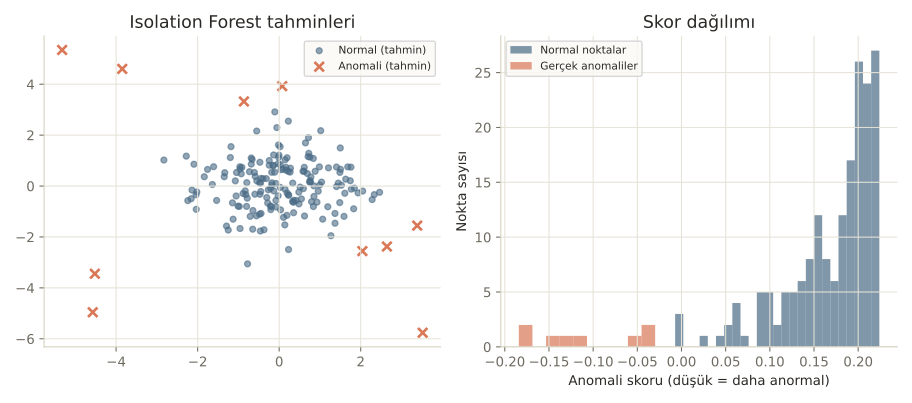
Isolation Forest'ın anomali olarak işaretlediği nokta sayısı: 10
Gerçek 8 anomaliden doğru yakalanan: 8
8 gerçek anomaliden 8’i de doğru yakalandı! Modelin contamination parametresini değiştirerek eşiği ayarlayabiliriz:
contamination parametresinin etkisi
for c in [0.01, 0.05, 0.1, 0.2]:
    m = IsolationForest(n_estimators=200, contamination=c, random_state=3)
    t = m.fit_predict(X)
    print(f"contamination={c:<5} işaretlenen anomali sayısı: {np.sum(t == -1)}")
print("contamination, 'verinin yaklaşık yüzde kaçının anomali olduğunu düşündüğünü' modele söyler --")
print("bu bir EŞİK ayarıdır, modelin kendisi anomali OLASILIĞINI zaten skorlar (decision_function).")
contamination=0.01 işaretlenen anomali sayısı: 2
contamination=0.05 işaretlenen anomali sayısı: 10
contamination=0.1 işaretlenen anomali sayısı: 19
contamination=0.2 işaretlenen anomali sayısı: 38
contamination, 'verinin yaklaşık yüzde kaçının anomali olduğunu düşündüğünü' modele söyler --
bu bir EŞİK ayarıdır, modelin kendisi anomali OLASILIĞINI zaten skorlar (decision_function).contamination arttıkça daha fazla nokta anomali olarak işaretleniyor (2 → 10 → 19 → 38) — bu, 11. dersteki karar eşiği mantığına benzer: modelin kendisi zaten her noktaya bir anomali SKORU veriyor, contamination sadece bu skorların hangi noktadan itibaren “anomali” sayılacağını belirleyen bir eşik.
Nerede işe yarar
Isolation Forest, anomali tespitinin özel ihtiyaçlarına doğrudan hitap eder:
- Dolandırıcılık tespiti. 12. dersteki dengesiz veri sorununu hatırla — anomaliler zaten NADİR olduğu için, Isolation Forest bu doğal nadirliği doğrudan kullanır.
- Sistem/ağ izleme. Normal davranıştan sapan sunucu, sensör veya ağ trafiği örüntülerini yakalamak.
- Veri temizliği. Bir modeli eğitmeden ÖNCE, veri setindeki bariz hatalı/aykırı kayıtları hızlıca taramak için.
Bu 3 hatayı yaparsın:
contamination’ı rastgele bir sayı sanıp önemsememek — bu parametre, kaç noktanın anomali sayılacağını doğrudan belirler; yanlış bir değer hem çok fazla hem çok az işaretlemeye yol açabilir.- Isolation Forest’ın “supervised” (etiketli) bir yöntem olduğunu düşünmek — DBSCAN gibi, hiçbir etiket gerektirmeden çalışır; hangi noktaların gerçekten anomali olduğunu ÖNCEDEN bilmene gerek yoktur.
- Anomali skorunu “kesinlik” olarak yorumlamak — düşük bir skor, o noktanın izole edilmesinin KOLAY olduğunu gösterir, ama bu her zaman “kötü” veya “hatalı” anlamına gelmez; bazen gerçekten nadir ama meşru bir olaydır.
Kendini test et
1. Isolation Forest'ın anomali tespiti fikri nedir?
- Önce 'normal' verinin dağılımını modelleyip, ona uymayan noktaları işaretlemek
- Bir noktayı rastgele bölünmelerle diğerlerinden AYIRMAK (izole etmek) için gereken adım sayısına bakmak -- az adımda izole edilen noktalar anomali olma eğilimindedir (doğru cevap)
- Sadece en uzak noktayı bulmak
- K-Means ile kümeleyip en küçük kümeyi anomali saymak
Neden: Isolation Forest, normal veriyi hiç modellemeden, sadece bir noktayı rastgele bölünmelerle izole etmenin ne kadar kolay olduğuna bakar -- izole (az komşulu) noktalar çok daha az adımda ayrılır.
2. Notebook'ta normal noktaları izole etmek 12.3 adım sürerken anomalileri izole etmek neden sadece 4.8 adım sürdü?
- Kod hatalıydı
- Anomaliler, etraflarında az sayıda (veya hiç) komşu olduğu için, rastgele bir bölünme onları diğer noktalardan çok daha hızlı ayırabiliyor (doğru cevap)
- Anomaliler her zaman daha büyük sayısal değerlere sahiptir
- Rastgele bir tesadüf
Neden: Yoğun bir bölgedeki normal bir noktayı komşularından ayırmak birçok bölünme gerektirir; izole bir anomalinin etrafında ayrılacak az komşu olduğu için, tek bir rastgele bölünme bile onu genelde ayırabilir.
3. `contamination` parametresi ne işe yarar?
- Modelin hızını ayarlar
- Modelin zaten hesapladığı anomali skorlarının hangi eşikten itibaren 'anomali' sayılacağını belirler (doğru cevap)
- Veri setindeki gürültüyü temizler
- Ağaç sayısını belirler
Neden: Isolation Forest her noktaya zaten bir anomali skoru verir; contamination, bu skorların yaklaşık hangi yüzdesinin 'anomali' olarak etiketleneceğini belirleyen bir eşik ayarıdır.
Özet
Özet
- Isolation Forest, bir noktayı rastgele bölünmelerle izole etmenin ne kadar kolay olduğuna bakarak anomalileri tespit eder.
- İzole (az komşulu) noktalar, yoğun bölgedeki noktalardan çok daha az adımda ayrılır.
- Anomali skoru, YÜZLERCE ağacın izolasyon derinliklerinin ortalamasına dayanır -- bu da gürültüyü azaltır.
- `contamination` parametresi, modelin zaten hesapladığı skorların hangi eşikten itibaren anomali sayılacağını belirler.
- Etiket gerektirmeyen (unsupervised) bir yöntemdir -- hangi noktaların gerçekten anomali olduğunu önceden bilmene gerek yoktur.