

Box-Cox dönüşümü
Önkoşul:LightGBM
Kanca
Gelir, ev fiyatı, bekleme süresi gibi birçok gerçek dünya değişkeni SİMETRİK değildir — çoğu değer düşük/orta seviyede toplanır, az sayıda aşırı yüksek değer “kuyruğu” uzatır. Doğrusal regresyon gibi birçok yöntem, hatanın yaklaşık normal dağıldığını VARSAYAR. Bu varsayım ihlal edilirse ne olur, ve düzeltmenin tek bir formülü var mı?
Sezgi
Box-Cox dönüşümü, çarpık bir değişkeni, VERİDEN öğrenilen tek bir parametreyle (λ, lambda) simetrik bir dağılıma yaklaştıran bir formüldür. log dönüşümüne benzer (aslında λ=0 durumunda TAM OLARAK log dönüşümüdür) ama sabit bir formül dayatmak yerine, verine EN İYİ uyan λ değerini otomatik olarak bulur.
Bunun neden önemli olduğu 25. dersimizin can alıcı sorusu: birçok istatistiksel yöntem ve model, hata terimlerinin (kalıntıların) yaklaşık normal dağıldığını varsayar. Çarpık bir hedef değişken, bu kalıntıları da çarpık bırakabilir — bu da güven aralıklarını, p-değerlerini ve bazı model varsayımlarını güvenilmez hale getirebilir.
Mekanizma
Sağa çarpık bir gelir dağılımıyla başlayalım:
Sağa çarpık gelir verisi
# Gelir gibi birçok gerçek dünya değişkeni SAĞA ÇARPIKTIR (çoğu kişi düşük/orta, az sayıda çok yüksek).
n = 300
gelir = rng.lognormal(mean=2.5, sigma=0.8, size=n)
print(f"Gelir -- ortalama: {gelir.mean():.2f}, medyan: {np.median(gelir):.2f}")
print(f"Çarpıklık (skewness): {skew(gelir):.3f}  (0 = simetrik, >1 = güçlü sağa çarpık)")
print("Ortalama medyandan belirgin şekilde yüksek -- birkaç aşırı yüksek değer ortalamayı yukarı 'çekiyor'.")
Gelir -- ortalama: 16.84, medyan: 12.78
Çarpıklık (skewness): 2.543 (0 = simetrik, >1 = güçlü sağa çarpık)
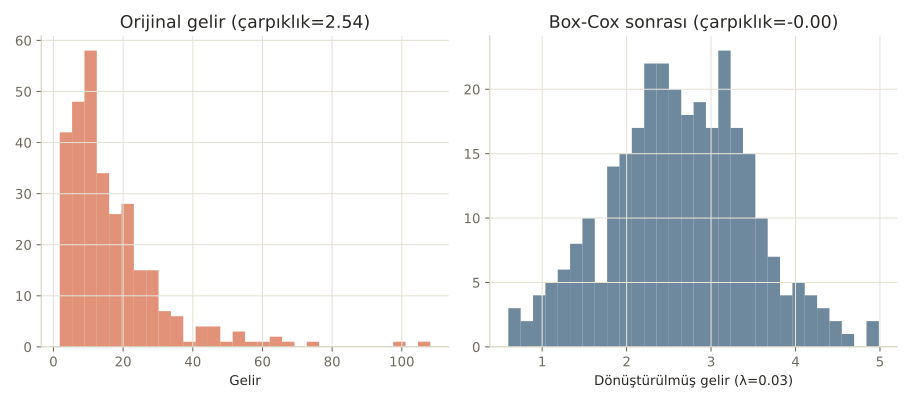
Ortalama medyandan belirgin şekilde yüksek -- birkaç aşırı yüksek değer ortalamayı yukarı 'çekiyor'.Ortalama (16.84), medyandan (12.78) belirgin şekilde yüksek — bu, sağa çarpıklığın klasik bir işareti. Çarpıklık değeri 2.543 (0 simetrik olurdu). Şimdi Box-Cox uygulayalım:
Box-Cox dönüşümü
gelir_donusturulmus, en_iyi_lambda = boxcox(gelir)
print(f"\nBox-Cox'un bulduğu en iyi lambda: {en_iyi_lambda:.3f}")
print(f"Dönüşüm sonrası çarpıklık: {skew(gelir_donusturulmus):.3f}  (0'a çok daha yakın)")
print("lambda=0 olsaydı bu doğrudan log(gelir) demek olurdu; Box-Cox bunun YERİNE en iyi lambda'yı veriden buluyor.")
Box-Cox'un bulduğu en iyi lambda: 0.027
Dönüşüm sonrası çarpıklık: -0.001  (0'a çok daha yakın)
lambda=0 olsaydı bu doğrudan log(gelir) demek olurdu; Box-Cox bunun YERİNE en iyi lambda'yı veriden buluyor.
Çarpıklık 2.543’ten -0.001’e indi — neredeyse tam simetrik! Bulunan λ (0.027) sıfıra çok yakın, yani bu durumda Box-Cox neredeyse log dönüşümüyle aynı sonucu veriyor (ama bunu VERİDEN kendisi keşfetti, elle “log alayım mı almayayım mı” kararı vermeden).
Matematik
Box-Cox formülü
| Sembol | Anlamı |
|---|---|
| Orijinal (pozitif) değişken — Box-Cox SADECE pozitif değerlerde tanımlıdır | |
| Dönüşümün “şeklini” belirleyen parametre — veriden en yüksek olabilirlik (maximum likelihood) ile bulunur | |
| Dönüştürülmüş değişken — amaç bunun mümkün olduğunca normale yakın dağılması |
neredeyse hiç dönüşüm yapmaz (doğrusal bir kaydırma), log dönüşümüdür, karekök dönüşümüne yakındır. Box-Cox, bu sonsuz aile içinden veriye EN İYİ uyanı otomatik olarak seçer.
Kod
Şimdi bunun neden PRATİKTE önemli olduğunu, bir regresyon modelinin kalıntılarında görelim:
Dönüşümün kalıntılara etkisi
# Doğrusal regresyon gibi yöntemler, hatanın (residual) yaklaşık NORMAL dağıldığını varsayar.
# Çarpık bir hedef değişken, bu varsayımı ihlal edip KALINTILARI da çarpık bırakabilir.
egitim_yili = rng.uniform(0, 20, n)  # gelirle ilişkili basit bir öznitelik

model_carpik = LinearRegression()
model_carpik.fit(egitim_yili.reshape(-1, 1), gelir)
kalinti_carpik = gelir - model_carpik.predict(egitim_yili.reshape(-1, 1))

model_donusturulmus = LinearRegression()
model_donusturulmus.fit(egitim_yili.reshape(-1, 1), gelir_donusturulmus)
kalinti_donusturulmus = gelir_donusturulmus - model_donusturulmus.predict(egitim_yili.reshape(-1, 1))

print(f"\nHam gelirle kurulan modelin kalıntı çarpıklığı: {skew(kalinti_carpik):.3f}")
print(f"Box-Cox dönüştürülmüş gelirle kurulan modelin kalıntı çarpıklığı: {skew(kalinti_donusturulmus):.3f}")
print("Dönüşüm sonrası kalıntılar 0'a çok daha yakın -- doğrusal regresyonun normallik varsayımına çok daha uygun.")
Ham gelirle kurulan modelin kalıntı çarpıklığı: 2.541
Box-Cox dönüştürülmüş gelirle kurulan modelin kalıntı çarpıklığı: 0.008
Dönüşüm sonrası kalıntılar 0'a çok daha yakın -- doğrusal regresyonun normallik varsayımına çok daha uygun.
Ham gelirle kurulan modelin kalıntı çarpıklığı (2.541), dönüştürülmüş gelirle kurulanınkinden (0.008) ÇOK daha yüksek — ham veriyle çalışan model, normal dağılım varsayımını ciddi şekilde ihlal ediyor. Bunu resmi bir testle doğrulayalım:
Shapiro-Wilk normallik testi
# Shapiro-Wilk testiyle (14. istatistik dersini hatırla), dönüşümün normalliğe ne kadar yaklaştırdığını ölçelim.
_, p_carpik = stats.shapiro(gelir)
_, p_donusturulmus = stats.shapiro(gelir_donusturulmus)
print(f"\nOrijinal gelirin Shapiro-Wilk p-değeri: {p_carpik:.5f}  (çok küçük -> normallikten UZAK)")
print(f"Dönüştürülmüş gelirin Shapiro-Wilk p-değeri: {p_donusturulmus:.5f}")
Orijinal gelirin Shapiro-Wilk p-değeri: 0.00000  (çok küçük -> normallikten UZAK)
Dönüştürülmüş gelirin Shapiro-Wilk p-değeri: 0.84489
Orijinal gelirin p-değeri (0.00000) normallik hipotezini KESİN OLARAK reddediyor; dönüştürülmüş gelirin p-değeri (0.84489) ise normallikle TUTARLI. Çoğu kişi “dönüşüm sadece görsel bir kozmetik işlem” sanır. Değil, çünkü 14. istatistik dersindeki p-değeri mantığıyla, bu resmi bir istatistiksel test — dönüşüm, veriyi gerçekten normal dağılıma çok daha yakın bir hale getiriyor.
Nerede işe yarar
Box-Cox dönüşümü, özellikle klasik istatistiksel varsayımlara dayanan yöntemlerde faydalıdır:
- Doğrusal regresyon, ANOVA gibi normallik varsayan yöntemler. Hedef değişken çarpıksa, dönüşüm modelin varsayımlarını daha iyi karşılamasını sağlar.
- Aykırı değerlerin etkisini yumuşatmak. Çarpık dağılımlardaki uç değerler, dönüşüm sonrası daha az baskın hale gelir.
- Ağaç tabanlı yöntemlerde (17-24. ders) genelde GEREKSİZ. Karar ağaçları, Random Forest, XGBoost gibi yöntemler dağılım şekline duyarlı değildir — Box-Cox esas olarak doğrusal/istatistiksel yöntemler için değerlidir.
Bu 3 hatayı yaparsın:
- Negatif veya sıfır içeren verilere doğrudan Box-Cox uygulamaya çalışmak — formül sadece POZİTİF değerlerde tanımlıdır (negatif değerler için Yeo-Johnson gibi bir alternatif gerekir).
- Dönüşümü uyguladıktan sonra tahminleri ORİJİNAL ölçeğe geri çevirmeyi unutmak — model dönüştürülmüş ölçekte tahmin üretir, yorumlamak için ters dönüşüm gerekir.
- Her modelde Box-Cox’un gerekli olduğunu sanmak — ağaç tabanlı yöntemler (17-24. ders) bu dönüşüme genelde ihtiyaç duymaz.
Kendini test et
1. Box-Cox dönüşümünün λ (lambda) parametresi ne işe yarar?
- Veri setinin boyutunu küçültür
- Dönüşümün "şeklini" belirler -- veriden otomatik olarak, sonucu en normale yakın yapacak şekilde bulunur (doğru cevap)
- Sadece kategorik verilerde kullanılır
- Modelin öğrenme oranını ayarlar
Neden: λ, dönüşümün formunu belirler (λ=0 log dönüşümü, λ=1 neredeyse dönüşümsüz gibi); Box-Cox bu parametreyi veriden otomatik olarak, sonucu en normale yakın yapacak şekilde bulur.
2. Notebook'ta Box-Cox dönüşümünden sonra Shapiro-Wilk p-değeri neden 0.00000'dan 0.84489'a yükseldi?
- Kod hatalıydı
- Dönüşüm, veriyi normal dağılıma çok daha yakın bir hale getirdi -- bu resmi bir istatistiksel testle doğrulandı (doğru cevap)
- p-değeri rastgele değişti
- Veri seti küçüldü
Neden: Düşük p-değeri normallikten sapmayı gösterir; dönüşüm sonrası yüksek p-değeri (0.84489), verinin artık normal dağılımla tutarlı olduğunu -- yani dönüşümün gerçekten işe yaradığını gösterir.
3. Ağaç tabanlı yöntemlerde (Random Forest, XGBoost gibi) Box-Cox dönüşümü genelde neden gerekli değildir?
- Bu yöntemler negatif sayıları kabul etmez
- Ağaç tabanlı yöntemler, özniteliklerin/hedefin MUTLAK dağılım şekline değil, sadece SIRALAMASINA duyarlıdır -- normallik varsaymazlar (doğru cevap)
- Box-Cox sadece sınıflandırma için kullanılır
- Ağaçlar zaten otomatik olarak Box-Cox uygular
Neden: Karar ağaçları bölünme noktaları ararken değerlerin SIRALAMASINA bakar, mutlak dağılım şekline değil -- bu yüzden doğrusal regresyon gibi normallik varsayan yöntemlerin aksine, dönüşüme ihtiyaç duymazlar.
Özet
Özet
- Box-Cox dönüşümü, çarpık bir değişkeni veriden öğrenilen tek bir λ parametresiyle normale yaklaştırır.
- λ=0 özel durumu, doğrudan log dönüşümüne karşılık gelir.
- Çarpık bir hedef değişken, doğrusal regresyon gibi yöntemlerin normallik varsayımını ihlal ederek kalıntıları da çarpık bırakabilir.
- Shapiro-Wilk gibi testler, dönüşümün normalliğe ne kadar yaklaştırdığını resmi olarak doğrulayabilir.
- Ağaç tabanlı yöntemler dağılım şekline duyarlı olmadığı için Box-Cox'a genelde ihtiyaç duymaz.