

Karar ağaçları
Önkoşul:KNN
Kanca
Şimdiye kadarki modeller matematiksel formüllerle (doğru, sigmoid, marjin) çalıştı. Ya bunun yerine, insanların doğal olarak karar verdiği gibi — bir dizi evet/hayır sorusu sorarak — bir model kursak? “Yaş 40’tan büyük mü? Evet ise… Hayır ise…”
Sezgi
Karar ağacı, veriyi bir dizi basit soruyla (bölünme noktasıyla) art arda ikiye ayırır, her seferinde sonuçtaki grupları mümkün olduğunca “SAF” (tek bir sınıfa yakın) hale getirmeye çalışır. Bir grubun ne kadar “saf” (homojen) olduğunu ölçmenin yaygın bir yolu Gini kirliliği’dir — 0 tamamen saf (tek sınıf), 0.5 tamamen karışık (50/50) demektir.
Ağırlıklı ortalama Gini: 0.277 — Bilgi kazancı: 0.223 (0.500 − 0.277)
Bölünme noktasını kaydır: bazı noktalarda sol/sağ gruplar birbirine çok benzer kalır (düşük bilgi kazancı), bazı noktalarda gruplar belirgin şekilde saflaşır (yüksek bilgi kazancı). “En iyi bölünmeyi bul” düğmesine bas — bu, TÜM olası noktaları deneyip en yüksek bilgi kazancını veren noktayı buluyor.
Mekanizma
Gerçek bir örnekle ilerleyelim — yaş ve gelire göre satın alma tahmini:
Müşteri verisi
n = 120
yas = rng.uniform(18, 65, n)
gelir = rng.uniform(3, 25, n)  # bin TL
skor = (yas - 40) / 15 + (gelir - 12) / 8 + rng.normal(0, 0.4, n)
satin_aldi = (skor > 0).astype(int)
X = np.column_stack([yas, gelir])
print(f"{n} müşteri, {satin_aldi.sum()} tanesi satın aldı")
120 müşteri, 75 tanesi satın aldıElle Gini ve bilgi kazancı hesaplama
def gini(etiketler):
    if len(etiketler) == 0:
        return 0.0
    p1 = etiketler.mean()
    return 1 - p1**2 - (1 - p1) ** 2

gini_toplam = gini(satin_aldi)
print(f"Tüm veri setinin Gini değeri: {gini_toplam:.3f}")

esik_deneme = 40
sol_maske = yas < esik_deneme
sol_gini = gini(satin_aldi[sol_maske])
sag_gini = gini(satin_aldi[~sol_maske])
agirlikli = (sol_maske.sum() * sol_gini + (~sol_maske).sum() * sag_gini) / n
print(f"yaş<{esik_deneme} ile bölünürse: sol Gini={sol_gini:.3f} ({sol_maske.sum()} örnek), sağ Gini={sag_gini:.3f} ({(~sol_maske).sum()} örnek)")
print(f"Ağırlıklı Gini: {agirlikli:.3f}, bilgi kazancı: {gini_toplam - agirlikli:.3f}")
Tüm veri setinin Gini değeri: 0.469
yaş<40 ile bölünürse: sol Gini=0.431 (51 örnek), sağ Gini=0.248 (69 örnek)
Ağırlıklı Gini: 0.326, bilgi kazancı: 0.143yaş<40 bölünmesi, Gini’yi 0.469’dan 0.326’ya düşürüyor — 0.143’lük bir bilgi kazancı. Şimdi gerçek bir ağaç eğitelim:
Derinlik=2 ağaç
model = DecisionTreeClassifier(max_depth=2, random_state=19)
model.fit(X, satin_aldi)
print(export_text(model, feature_names=["yas", "gelir"]))
print(f"Eğitim doğruluğu (derinlik=2): {accuracy_score(satin_aldi, model.predict(X)):.3f}")
|--- gelir <= 9.67
| |--- yas <= 47.75
| | |--- class: 0
| |--- yas > 47.75
| | |--- class: 1
|--- gelir > 9.67
| |--- yas <= 24.38
| | |--- class: 0
| |--- yas > 24.38
| | |--- class: 1
Eğitim doğruluğu (derinlik=2): 0.942Ağaç, önce gelire, sonra yaşa bakarak %94.2 doğrulukla sınıflandırıyor — ve bu kurallar İNSAN tarafından okunup anlaşılabilir, bu da karar ağaçlarının en büyük avantajlarından biri.
Matematik
Gini kirliliği ve bilgi kazancı
| Sembol | Anlamı |
|---|---|
| kümesindeki ‘ıncı sınıfın oranı | |
| Kümenin “kirliliği” — 0 (tamamen saf) ile 0.5 (tamamen karışık, 2 sınıf için) arasında | |
| Bölünme sonrası oluşan alt kümeler (sol, sağ) |
Ağaç, her adımda TÜM olası bölünme noktalarını (ve tüm öznitelikleri) dener, bilgi kazancını en YÜKSEK yapan bölünmeyi seçer. Bu açgözlü (greedy) bir stratejidir — her adımda “şu an en iyisini” seçer, gelecekteki adımları hesaba katmaz.
Kod
Peki ağacın derinliğini hiç sınırlamazsak ne olur?
Sınırsız derinlik -- aşırı öğrenme
# Derinliği SINIRLAMAZSAK ne olur? (7. dersteki aşırı öğrenmeyi hatırla)
model_sinirsiz = DecisionTreeClassifier(random_state=19)  # max_depth yok
model_sinirsiz.fit(X, satin_aldi)
egitim_dogruluk = accuracy_score(satin_aldi, model_sinirsiz.predict(X))
capraz_dogrulama = cross_val_score(model_sinirsiz, X, satin_aldi, cv=5).mean()
capraz_dogrulama_sinirli = cross_val_score(DecisionTreeClassifier(max_depth=2, random_state=19), X, satin_aldi, cv=5).mean()
print(f"\nSınırsız derinlik -- eğitim doğruluğu: {egitim_dogruluk:.3f}  (ağaç derinliği: {model_sinirsiz.get_depth()})")
print(f"Sınırsız derinlik -- çapraz doğrulama doğruluğu: {capraz_dogrulama:.3f}")
print(f"Derinlik=2 -- çapraz doğrulama doğruluğu: {capraz_dogrulama_sinirli:.3f}")
print("Sınırsız ağaç eğitim verisini EZBERLİYOR (yaklaşık %100) ama çapraz doğrulamada sınırlı ağaçtan daha iyi değil -- klasik aşırı öğrenme.")
Sınırsız derinlik -- eğitim doğruluğu: 1.000  (ağaç derinliği: 5)
Sınırsız derinlik -- çapraz doğrulama doğruluğu: 0.858
Derinlik=2 -- çapraz doğrulama doğruluğu: 0.850
Sınırsız ağaç eğitim verisini EZBERLİYOR (yaklaşık %100) ama çapraz doğrulamada sınırlı ağaçtan daha iyi değil -- klasik aşırı öğrenme.
Sınırsız ağaç, eğitim verisini %100 doğrulukla EZBERLİYOR (derinlik 5’e kadar dallanarak) — ama çapraz doğrulamada (0.858), sadece 2 seviye derin olan ağaçtan (0.850) neredeyse hiç daha iyi değil! Çoğu kişi “ağaç ne kadar derin olursa o kadar iyi öğrenir” sanır. Değil, çünkü 7. derste gördüğümüz aşırı öğrenmenin klasik bir örneği burada — ağaç, her yaprakta tek tek örnekleri ayırt edecek kadar derinleşip veri setindeki GÜRÜLTÜYÜ ezberliyor, bu da yeni veride işe yaramıyor.
Hangi öznitelik daha önemli?
for isim, onem in zip(["yaş", "gelir"], model.feature_importances_):
    print(f"{isim}: {onem:.3f}")
yaş: 0.578
gelir: 0.422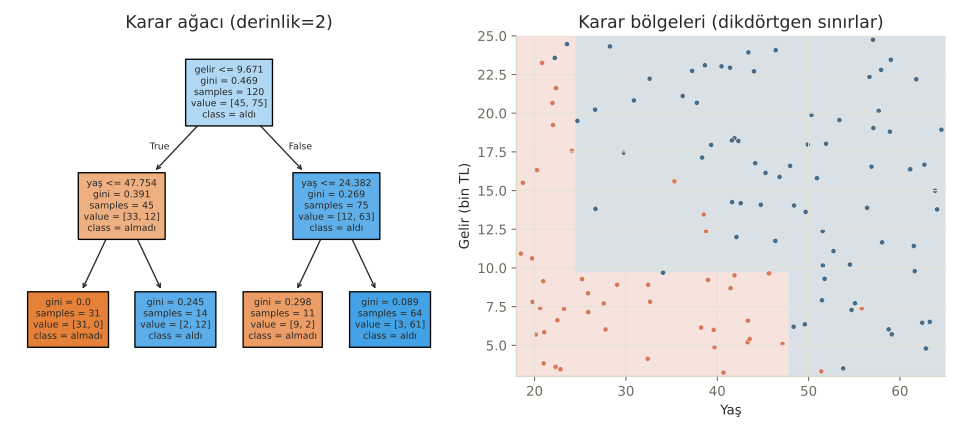
Nerede işe yarar
Karar ağaçları, YORUMLANABİLİRLİK gerektiren durumlarda özellikle değerlidir:
- Açıklanabilir karar verme. Bir kredi başvurusu neden reddedildi? Ağacın kuralları doğrudan okunup anlatılabilir.
- Öznitelik önemini hızlıca görmek.
feature_importances_, hangi özniteliklerin tahminlerde en çok işe yaradığını doğrudan gösterir. - Daha güçlü yöntemlerin (19+ derste göreceğimiz Random Forest, Gradient Boosting) temel yapı taşı. Tek başına sınırlı olsa da, topluluk halinde çok güçlü hale gelirler.
Bu 3 hatayı yaparsın:
- Ağaç derinliğini sınırlamadan (
max_depthbelirlemeden) kullanmak — bu derste gördüğümüz gibi, ağaç eğitim verisini ezberler ama genellemesi kötüleşir. - Tek bir karar ağacının kararlı (stabil) olduğunu düşünmek — veri setine küçük değişiklikler bile, ağacın yapısını (hangi öznitelikte, hangi noktada bölündüğünü) büyük ölçüde değiştirebilir.
- Karar ağaçlarının eğri sınırlar çizebileceğini sanmak — her bölünme, TEK bir özniteliğe göre olduğu için sınırlar her zaman eksenlere paralel, dikdörtgen şekillerdir.
Kendini test et
1. Gini kirliliği neyi ölçer?
- Bir kümedeki örnek sayısını
- Bir kümenin ne kadar "saf" (tek bir sınıfa yakın) olduğunu -- 0 tamamen saf, 0.5 tamamen karışık (doğru cevap)
- Ağacın derinliğini
- Modelin hızını
Neden: Gini kirliliği, bir kümedeki sınıf karışıklığını ölçer; tüm örnekler aynı sınıftaysa 0, sınıflar eşit dağılmışsa (2 sınıf için) 0.5 olur.
2. Notebook'ta sınırsız derinlikli ağaç eğitim verisinde %100 doğruluk aldı ama çapraz doğrulamada derinlik=2'den neredeyse hiç daha iyi değildi. Bu neyi gösteriyor?
- Kod hatalıydı
- Ağaç, eğitim verisindeki gürültüyü ezberledi (aşırı öğrenme) -- eğitim doğruluğu yüksek olsa da yeni veride bu avantaj kayboldu (doğru cevap)
- Çapraz doğrulama yanlış çalıştı
- Derinlik=2 zaten mükemmeldi
Neden: 7. dersteki aşırı öğrenme kavramının karar ağaçlarındaki karşılığı budur: sınırsız derinlik, ağacın eğitim verisindeki gürültüyü ezberlemesine izin verir, bu da genelleme performansını artırmaz.
3. Karar ağaçlarının karar sınırları neden her zaman dikdörtgen (eksenlere paralel) şekillerdedir?
- Bu bir sınırlama değil, tercihen böyle çizilir
- Her bölünme TEK bir özniteliğe göre yapıldığı için (örn. sadece "yaş<40"), sınır o eksene dik bir çizgi olmak zorundadır (doğru cevap)
- scikit-learn bunu böyle zorluyor
- Veri her zaman dikdörtgen dağılır
Neden: Her bölünme kuralı ('öznitelik X, eşik Y'den küçük mü?') sadece tek bir özniteliğe bakar; bu yüzden sınır her zaman o özniteliğin eksenine dik, dikdörtgen parçalardan oluşur.
Özet
Özet
- Karar ağacı, veriyi art arda ikiye bölerek, her bölünmede grupları mümkün olduğunca "saf" hale getirmeye çalışır.
- Gini kirliliği, bir grubun sınıf karışıklığını ölçer; bilgi kazancı, bir bölünmenin bu kirliliği ne kadar azalttığını gösterir.
- Ağaç, her adımda açgözlü (greedy) bir şekilde en yüksek bilgi kazancını veren bölünmeyi seçer.
- Derinliği sınırlamamak, ağacın eğitim verisini ezberlemesine (aşırı öğrenme) yol açar.
- Karar ağaçları her zaman eksenlere paralel, dikdörtgen sınırlar çizer -- bu SVM gibi yöntemlerden temel bir farktır.