

KNN
Önkoşul:Naive Bayes
Kanca
Şimdiye kadarki tüm modeller (lojistik regresyon, SVM, Naive Bayes) veriden katsayılar veya istatistikler ÖĞRENİYORDU. Ya hiç öğrenmeden, yeni bir noktayı sadece “ona en çok benzeyen noktalara” bakarak sınıflandırsak?
Sezgi
K-En Yakın Komşu (KNN), en basit fikirlerden birine dayanır: yeni bir noktayı sınıflandırmak için, ona en YAKIN k tane noktaya bak, çoğunluğun sınıfını ver. Başka hiçbir “eğitim” yok — model sadece tüm veriyi hafızasında tutar (buna tembel öğrenme/lazy learning denir) ve her tahmin anında mesafe hesabı yapar.
Karar bölgesine tıklayarak yeni bir test noktası ekle -- model onu en yakın 3 komşusuna bakarak sınıflandırsın.
sınıf 0 sınıf 1 sınıf 2 test noktan
k=3 -- makul bir denge: sınır ne çok pürüzlü ne çok düz. 0 test noktası eklendi.
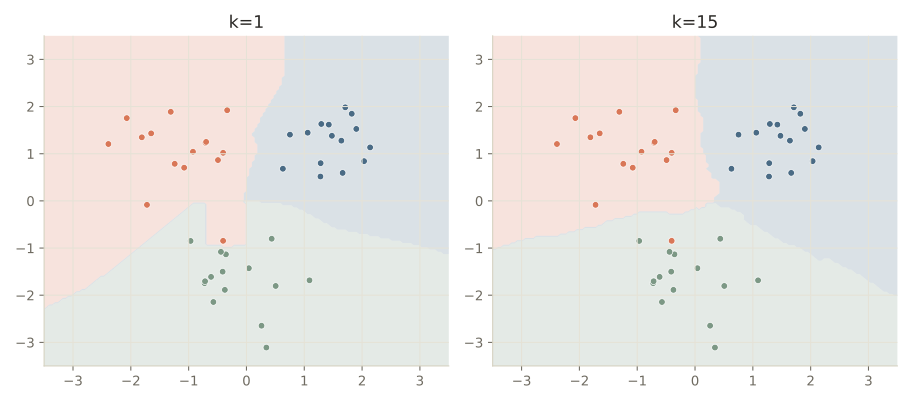
k’yı değiştir: k=1’de karar sınırı çok pürüzlü (her nokta kendi küçük bölgesini oluşturuyor) — tek bir gürültülü noktaya bile aşırı duyarlı. k büyüdükçe sınır yumuşuyor, daha genel bir örüntüyü yansıtıyor. Bir noktaya tıklayarak yeni bir test noktası ekle ve modelin onu hangi komşulara bakarak sınıflandırdığını (kesikli çizgiler) gör.
Mekanizma
KNN’in mekaniğini elle yapalım:
3 sınıflı veri
merkezler = [(-1.5, 1), (1.5, 1), (0, -1.5)]
X_parcalar, y_parcalar = [], []
for sinif, (mx, my) in enumerate(merkezler):
    X_parcalar.append(rng.normal([mx, my], 0.6, size=(15, 2)))
    y_parcalar.append(np.full(15, sinif))
X = np.vstack(X_parcalar)
y = np.concatenate(y_parcalar)
print(f"{len(X)} nokta, 3 sınıf")
45 nokta, 3 sınıfElle KNN hesaplama
# KNN'in mekaniğini elle yapalım: yeni bir noktaya en yakın k komşuyu bul, çoğunluk oyu kullan.
yeni_nokta = np.array([0.5, 0.5])
mesafeler = np.linalg.norm(X - yeni_nokta, axis=1)
k = 5
en_yakin_indeksler = np.argsort(mesafeler)[:k]
en_yakin_siniflar = y[en_yakin_indeksler]
print(f"En yakın {k} komşunun sınıfları: {en_yakin_siniflar}")
print(f"Çoğunluk oyu (elle): sınıf {np.bincount(en_yakin_siniflar).argmax()}")

model = KNeighborsClassifier(n_neighbors=k)
model.fit(X, y)
print(f"scikit-learn'ün tahmini: sınıf {model.predict([yeni_nokta])[0]}")
En yakın 5 komşunun sınıfları: [1 1 1 1 0]
Çoğunluk oyu (elle): sınıf 1
scikit-learn'ün tahmini: sınıf 1Elle bulduğumuz sonuç (sınıf 1) ile scikit-learn’ün bulduğu BİREBİR aynı — KNN’in “gizemli” bir tarafı yok, sadece mesafe ölçüp oy sayıyor. Şimdi k’nın etkisine bakalım:
k parametresinin etkisi
# k arttıkça karar sınırı nasıl değişiyor? (Kendi kendine test etmemek için "leave-one-out" mantığı)
from sklearn.model_selection import cross_val_score

for k_deneme in [1, 3, 5, 9, 15, 25]:
    m = KNeighborsClassifier(n_neighbors=k_deneme)
    skor = cross_val_score(m, X, y, cv=5).mean()
    print(f"k={k_deneme:<3} çapraz doğrulama doğruluğu: {skor:.3f}")
print("k=1, tek bir gürültülü komşuya bile duyarlı (en düşük skor); k>=3 ile skor hemen toparlanıp düzleşiyor.")
print("Çok daha büyük k değerlerinde (veri boyutuna yakın), sınır aşırı düzleşip yetersiz öğrenmeye kayar -- 7. dersteki bias-variance dengesi.")
k=1 çapraz doğrulama doğruluğu: 0.956
k=3 çapraz doğrulama doğruluğu: 0.978
k=5 çapraz doğrulama doğruluğu: 0.978
k=9 çapraz doğrulama doğruluğu: 0.978
k=15 çapraz doğrulama doğruluğu: 0.978
k=25 çapraz doğrulama doğruluğu: 0.978
k=1, tek bir gürültülü komşuya bile duyarlı (en düşük skor); k>=3 ile skor hemen toparlanıp düzleşiyor.
Çok daha büyük k değerlerinde (veri boyutuna yakın), sınır aşırı düzleşip yetersiz öğrenmeye kayar -- 7. dersteki bias-variance dengesi.k=1’de skor en düşük (0.956) — tek bir gürültülü komşuya karşı savunmasız. k≥3 ile skor toparlanıp düzleşiyor. Çok daha büyük bir k (örneğin veri boyutuna yakın) sınırı aşırı düzleştirip yetersiz öğrenmeye kayabilir — 7. dersteki bias-variance dengesinin KNN’deki karşılığı.
Matematik
Öklid mesafesi ve çoğunluk oyu
| Sembol | Anlamı |
|---|---|
| ile eğitim noktası arasındaki Öklid mesafesi | |
| ‘e en yakın eğitim noktasının kümesi | |
| En sık görülen sınıf (çoğunluk oyu) |
Mesafe formülü, HER özniteliği eşit ağırlıkla ele alır. Bu yüzden bir öznitelik diğerinden çok daha büyük SAYISAL değerler alıyorsa (örn. metrekare vs oda sayısı), mesafeyi neredeyse TEK BAŞINA belirler — bu bir sonraki bölümde göreceğimiz sorunun matematiksel kökeni.
Kod
KNN’in en kritik pratik detayı — ölçekleme:
Ölçeklemenin kritik önemi
# KNN mesafeye dayanır -- öznitelikler farklı ölçekteyse, büyük ölçekli olan HAKİM olur.
X_olceksiz = np.column_stack([X[:, 0], X[:, 1] * 100])  # ikinci öznitelik 100 kat büyütüldü
model_olceksiz = KNeighborsClassifier(n_neighbors=5)
skor_olceksiz = cross_val_score(model_olceksiz, X_olceksiz, y, cv=5).mean()
print(f"\nÖlçeklenmemiş veri (2. öznitelik 100x büyütülmüş) doğruluk: {skor_olceksiz:.3f}")

X_olcekli = StandardScaler().fit_transform(X_olceksiz)
model_olcekli = KNeighborsClassifier(n_neighbors=5)
skor_olcekli = cross_val_score(model_olcekli, X_olcekli, y, cv=5).mean()
print(f"StandardScaler ile düzeltilmiş doğruluk: {skor_olcekli:.3f}")
print("Ölçekleme yapılmadan, mesafe hesabı neredeyse tamamen 2. özniteliğe göre belirleniyor -- yanıltıcı sonuçlar.")
Ölçeklenmemiş veri (2. öznitelik 100x büyütülmüş) doğruluk: 0.733
StandardScaler ile düzeltilmiş doğruluk: 0.978
Ölçekleme yapılmadan, mesafe hesabı neredeyse tamamen 2. özniteliğe göre belirleniyor -- yanıltıcı sonuçlar.
Sadece bir özniteliği 100 kat büyütmek, doğruluğu %97.8’den %73.3’e düşürdü! Çoğu kişi “bir özniteliğin ölçeği, o özniteliğin önemini artırmaz, sadece birimini değiştirir” sanır. KNN için tamamen yanlış, çünkü mesafe hesabı doğrudan sayısal büyüklüğe dayanır — 100 kat büyütülmüş bir öznitelik, mesafeyi neredeyse TEK BAŞINA belirler, diğer öznitelik anlamsızlaşır. StandardScaler bu sorunu hemen çözüyor.
Nerede işe yarar
KNN, basitliği ve yorumlanabilirliğiyle hâlâ kullanışlı bir araçtır:
- Küçük/orta veri setlerinde hızlı bir başlangıç noktası. Kurulumu kolay, hiperparametre sayısı az (esas olarak sadece k).
- Öneri sistemlerinin temeli. “Bu kullanıcıya benzer kullanıcılar neyi sevdi?” mantığı, doğrudan KNN’in bir uzantısıdır.
- Anomali tespiti. Bir noktanın en yakın komşularına olan mesafesi, ne kadar “sıra dışı” olduğunun bir göstergesi olabilir.
Bu 3 hatayı yaparsın:
- Öznitelikleri ölçeklemeden KNN kullanmak — bu derste gördüğümüz gibi, sonuçları tamamen çarpıtabilir. KNN’de ölçekleme NEREDEYSE HER ZAMAN zorunludur.
- Büyük veri setlerinde KNN kullanmak — her tahmin, TÜM eğitim verisiyle mesafe hesaplamayı gerektirir; bu büyük veride yavaşlar (diğer modeller bir kez eğitilip hızla tahmin yapar).
- k’yı tek bir sabit değer olarak “akılda tutmak” — doğru k, veri setine göre değişir ve çapraz doğrulamayla (9. ders) bulunmalıdır.
Kendini test et
1. KNN'in diğer modellerden (lojistik regresyon, SVM) temel farkı nedir?
- Sadece 2 sınıflı problemlerde çalışır
- 'Eğitim' aşamasında bir şey öğrenmez -- tüm veriyi saklar ve her tahminde en yakın komşulara bakar (tembel öğrenme) (doğru cevap)
- Her zaman daha yüksek doğruluk verir
- Sadece görüntü verisinde kullanılır
Neden: KNN, katsayı veya istatistik öğrenmez; sadece eğitim verisini saklar ve her yeni tahmin anında mesafe hesaplayarak en yakın k komşuya bakar -- bu yüzden 'tembel öğrenme' olarak adlandırılır.
2. Notebook'ta bir özniteliği 100 kat büyütmek doğruluğu neden %97.8'den %73.3'e düşürdü?
- Kod hatalıydı
- KNN mesafeye dayandığı için, büyük ölçekli öznitelik mesafeyi neredeyse tek başına belirledi, diğer öznitelik anlamsızlaştı (doğru cevap)
- Veri seti küçüktü
- k değeri yanlıştı
Neden: Öklid mesafesi tüm özniteliklerin sayısal büyüklüğüne dayanır; ölçeksiz bir öznitelik diğerlerinden çok daha büyük değerler alırsa, mesafe hesabına neredeyse tek başına hükmeder.
3. k=1 kullanmanın riski nedir?
- Model çok yavaş çalışır
- Karar sınırı tek bir gürültülü noktaya bile aşırı duyarlı olur (yüksek varyans) (doğru cevap)
- Model hiç tahmin yapamaz
- Sadece 1 sınıf tahmin edilebilir
Neden: k=1'de tahmin tamamen TEK bir en yakın komşuya bağlıdır; o komşu bir gürültü/aykırı nokta ise tahmin de hatalı olur -- bu yüksek varyanslı, aşırı öğrenmeye yatkın bir durumdur.
Özet
Özet
- KNN, yeni bir noktayı en yakın k eğitim noktasının çoğunluk sınıfına göre sınıflandırır.
- "Tembel öğrenme" olarak adlandırılır çünkü eğitim aşamasında hiçbir şey hesaplamaz, sadece veriyi saklar.
- Küçük k, karar sınırını pürüzlü ve gürültüye duyarlı yapar; büyük k sınırı yumuşatır ama aşırı büyürse yetersiz öğrenmeye yol açabilir.
- KNN, mesafeye dayandığı için öznitelik ölçeklemesi NEREDEYSE HER ZAMAN zorunludur.
- Büyük veri setlerinde her tahmin TÜM veriyle karşılaştırma gerektirdiği için KNN yavaşlayabilir.